omega <- expand.grid(x = 1:6, y = 1:6)       # cele 36 de rezultate
A <- ___                                     # suma cel puțin 9
B <- omega$x == 5                            # zarul roșu arată 5
C <- ___                                     # cel puțin un 5
p_cond <- function(A, B) ___                 # P(A | B) = |A și B| / |B|
c(P_A = mean(A), A_dat_B = p_cond(A, B),
  A_dat_C = p_cond(A, C), B_dat_A = p_cond(B, A))
set.seed(202)                                # (d): 10^5 aruncări
nsim <- 1e5
x <- sample(1:6, nsim, replace = TRUE)       # zarul roșu
y <- ___                                     # zarul albastru
A <- x + y >= 9
C <- x == 5 | y == 5
c(N_C = sum(C), N_A_si_C = sum(A & C))       # numărăm repetările
c(estimare = ___, exact = ___) # N(A și C) / N(C); valoarea de la (a)Seminarul 2. Probabilități condiționate, formula lui Bayes și independență
Fișă de lucru (fără rezolvări)
Aceasta este fișa de lucru: enunțurile, scheletele de cod R și răspunsurile finale pentru exercițiile marcate „Dacă timpul permite” și „Pentru acasă”. Rezolvările complete vor fi publicate ulterior.
Planul seminarului și laboratorului
O informație nouă — un test medical pozitiv, un cuvânt apărut într-un mesaj, o ușă deschisă de prezentatorul unui concurs — schimbă probabilitățile evenimentelor care ne interesează. În Cursul 2 am construit instrumentele cu care ținem cont de o astfel de informație; astăzi le exersăm pe probleme concrete. Fiecare problemă este rezolvată întâi matematic, apoi verificată, ilustrată sau extinsă în R, iar problemele se sprijină una pe alta: funcțiile R scrise la un exercițiu sunt refolosite la următoarele.
Obiective. La sfârșitul ședinței studentul trebuie să poată:
- calcula o probabilitate condiționată prin restrângerea spațiului stărilor și folosi regula înmulțirii și arborii de probabilitate pentru experimente desfășurate în etape;
- aplica formula probabilității totale și formula lui Bayes, inclusiv pentru mai multe observații succesive, și explica de ce un test pozitiv pentru o boală rară nu înseamnă, de regulă, boală;
- verifica independența a două sau a mai multor evenimente și calcula fiabilitatea unui sistem cu componente independente;
- analiza un algoritm randomizat simplu — verificarea egalității a două polinoame — cu ajutorul independenței și al regulii înmulțirii;
- estima în R o probabilitate condiționată prin simulare, ca frecvență relativă printre repetările în care s-a realizat evenimentul la care condiționăm (
mean(A[B])); - scrie funcții R care simulează experimente în etape (cu
forșiwhile): urna lui Pólya, jocul lui Monty Hall, ruina jucătorului.
Structura. Breviar; probabilitate condiționată și regula înmulțirii (Exercițiile 1–3); formula probabilității totale și formula lui Bayes (Exercițiile 4–6); independență (Exercițiile 7–9); probleme clasice prin simulare (Exercițiile 10 și 11); exerciții suplimentare; temă. Pentru aprofundare: (Blitzstein and Hwang 2019, cap. 2), (Bertsekas and Tsitsiklis 2008, cap. 1), (Wagaman and Dobrow 2021, cap. 2); pentru algoritmii probabiliști (verificarea egalității a două polinoame): (Mitzenmacher and Upfal 2017, cap. 1).
Planul ședinței
De rezolvat la seminar (în această ordine):
- Exercițiul 1 — probabilitate condiționată prin restrângerea spațiului stărilor; funcția
p_condși estimarea prin simulare cumean(A[B]); - Exercițiul 2 — regula înmulțirii și arborele de probabilitate, fără și cu revenire; simularea cu
while; - Exercițiul 4 — formula probabilității totale, formula lui Bayes și actualizarea succesivă; funcția
bayes; - Exercițiul 6 — un test de diagnostic și eroarea ratei de bază; funcția
posterior; - Exercițiul 7 — independență două câte două și independență mutuală, verificate prin enumerare.
Dacă timpul permite:
- Exercițiul 8 — fiabilitatea unui sistem cu componente independente;
- Exercițiul 9 — un algoritm randomizat: verificarea egalității a două polinoame;
- Exercițiul 10 — jocul lui Monty Hall cu \(n\) uși, prin simulare.
Pentru acasă:
- Exercițiile 3 (urna lui Pólya), 5 (filtrul anti-spam) și 11 (ruina jucătorului);
- exercițiile suplimentare 12, 13, 14 și 15 (Secțiunea 6);
- enunțurile din Secțiunea 7.
Rezolvările complete vor fi publicate ulterior; scheletele de cod R se completează în locurile marcate cu ___. Exercițiile marcate „Dacă timpul permite” și „Pentru acasă” au, după enunț, răspunsurile finale, pentru verificare.
1 Breviar
Toate rezultatele de mai jos au fost enunțate și demonstrate în Cursul 2; le reamintim, cu trimiteri precise, în forma în care le folosim astăzi. În rezolvări (publicate ulterior) indicăm de fiecare dată rezultatul aplicat.
Rezultate din Cursul 2 folosite azi
- Probabilitate condiționată (Definiția 1 din Cursul 2): \(\PP(A\mid B)=\dfrac{\PP(A\cap B)}{\PP(B)}\), pentru \(\PP(B)>0\). În modelul clasic (Definiția 19 din Cursul 1), \(\PP(A\mid B)=|A\cap B|/|B|\): informația \(B\) restrânge spațiul stărilor la \(B\). Pentru \(B\) fixat, \(\PP(\cdot\mid B)\) este o probabilitate (Propoziția 2 din Cursul 2); în particular \(\PP(A^c\mid B)=1-\PP(A\mid B)\).
- Regula înmulțirii (Teorema 3 din Cursul 2): \(\PP(A_1\cap\dots\cap A_n)=\PP(A_1)\,\PP(A_2\mid A_1)\cdots\PP(A_n\mid A_1\cap\dots\cap A_{n-1})\). Într-un arbore de probabilitate, probabilitatea unei frunze este produsul probabilităților de pe drumul care duce la ea.
- Formula probabilității totale (Teorema 5 din Cursul 2): dacă \(B_1,\dots,B_n\) formează o partiție a lui \(\Omega\) (Definiția 4 din Cursul 2), atunci \(\PP(A)=\sum_{i=1}^n\PP(A\mid B_i)\,\PP(B_i)\).
- Formula lui Bayes (Teorema 7 din Cursul 2): \(\PP(B_i\mid A)=\dfrac{\PP(A\mid B_i)\,\PP(B_i)}{\sum_{j}\PP(A\mid B_j)\,\PP(B_j)}\) — de la probabilitatea a priori \(\PP(B_i)\) la probabilitatea a posteriori \(\PP(B_i\mid A)\).
- Independență (Definiția 8 din Cursul 2): \(A\indep B\) dacă \(\PP(A\cap B)=\PP(A)\,\PP(B)\); independența se păstrează la trecerea la complementare (Propoziția 9 din Cursul 2). Evenimentele \(A_1,\dots,A_n\) sunt (mutual) independente (Definiția 10 din Cursul 2) dacă relația de produs are loc pentru orice subfamilie; atunci \(\PP(\text{cel puțin unul se realizează})=1-\prod_{i}\big(1-\PP(A_i)\big)\).
- Independență condiționată (Definiția 11 din Cursul 2): \(\PP(A\cap B\mid C)=\PP(A\mid C)\,\PP(B\mid C)\).
- Fiabilitate (Secțiunea 6 din Cursul 2): pentru componente independente, un sistem serie funcționează cu probabilitatea \(p_1p_2\cdots p_m\), iar un sistem paralel cu probabilitatea \(1-(1-p_1)\cdots(1-p_m)\).
- Probleme clasice (Secțiunea 8 din Cursul 2): Monty Hall (Exemplul 18 din Cursul 2), urna lui Pólya (Propoziția 12 din Cursul 2), ruina jucătorului (Propoziția 13 din Cursul 2).
- Interpretarea frecvenționistă (Secțiunea 2 din Cursul 2): în \(N\) repetări ale experimentului, \(\PP(A\mid B)\approx N(A\cap B)/N(B)\) — frecvența lui \(A\) printre repetările în care \(B\) s-a realizat.
Instrumente R folosite azi
Pe lângă instrumentele din Seminarul 1 (vectori, sample, replicate, mean(conditie), expand.grid, funcții), folosim:
- vectori logici:
A & B(„și”),A | B(„sau”),!A(„non”);sum(A)numără valorileTRUE, iarmean(A)este frecvența lor relativă; - selecție logică:
x[B]păstrează doar componentele luixpentru careBesteTRUE. De aici ideea centrală a laboratorului: dacăAșiBsunt vectorii logici care arată, pentru fiecare repetare a experimentului, dacă evenimentele \(A\) și \(B\) s-au realizat, atunci \(\PP(A\mid B)\) se estimează prinmean(A[B]), adicăsum(A & B) / sum(B); runif(n) < p—nîncercări independente, fiecare reușită (TRUE) cu probabilitateap(runif(n)genereazănnumere la întâmplare în intervalul \([0,1]\));sample(x, size, replace = TRUE, prob = p)— extrageri cu probabilități inegale;ifelse(cond, a, b)— alege, componentă cu componentă, întreașib;which(cond)— pozițiile pe care condiția este adevărată;setdiff(x, y)— elementele luixcare nu sunt îny;x %% 2— restul împărțirii la \(2\);x %in% y— apartenența;for (k in 1:m) {...}șiwhile (cond) {...}— repetarea unor instrucțiuni;prod,cumsum,cumprod— produs, sume și produse cumulate;sapply(v, f)— aplică funcțiaffiecărui element al luiv;apply(M, 1, f)— fiecărei linii a matriceiM; cândf()întoarce un vector,replicate(nsim, f())este o matrice cunsimcoloane, pe care o rezumăm curowMeans(sau, după transpunerea cut(), cucolMeansșirowSums);table(x)— tabelul de frecvențe;all.equal(a, b)— egalitatea a două numere reale, cu toleranță la erorile de rotunjire;- o capcană: dacă
xare un singur element, de exemplux = 5, atuncisample(x, 1)alege din1:5, nu îl întoarce pe5. Pentru a alege la întâmplare dintr-o mulțime care poate avea un singur element scriemx[sample(length(x), 1)](Exercițiul 10).
2 Probabilitate condiționată și regula înmulțirii
Începem cu cele două moduri de a calcula o probabilitate condiționată: direct, prin restrângerea spațiului stărilor (când rezultatele sunt egal probabile, totul se reduce la o numărare), și în etape, cu regula înmulțirii, atunci când experimentul se desfășoară pas cu pas. În paralel construim primul instrument de laborator: estimarea unei probabilități condiționate prin simulare.
Exercițiul 1 (Două zaruri: ce schimbă o informație)
La seminar Aruncăm două zaruri echilibrate, unul roșu și unul albastru, și considerăm evenimentele: \[ \begin{aligned} A&=\text{„suma punctelor este cel puțin 9”},\qquad B=\text{„zarul roșu arată 5”},\\ C&=\text{„cel puțin unul dintre zaruri arată 5”}. \end{aligned} \]
Calculați \(\PP(A)\), \(\PP(A\mid B)\) și \(\PP(A\mid C)\). Care dintre informațiile \(B\) și \(C\) îl face pe \(A\) mai probabil?
Calculați \(\PP(B\mid A)\) și comparați cu \(\PP(A\mid B)\).
Enumerați în R cele \(36\) de rezultate, scrieți o funcție
p_cond(A, B)care calculează \(\PP(A\mid B)\) prin numărare și verificați rezultatele de la (a) și (b).Estimați \(\PP(A\mid C)\) prin simulare, folosind \(10^5\) aruncări ale celor două zaruri.
Laborator Schelet de cod pentru (c), (d) — completați locurile marcate cu ___:
În exercițiul precedent am calculat probabilități condiționate plecând de la probabilitățile intersecțiilor. De cele mai multe ori drumul este invers: experimentul se desfășoară în etape, probabilitățile condiționate sunt date de descrierea experimentului, iar probabilitățile intersecțiilor se obțin din regula înmulțirii.
Exercițiul 2 (Chei încercate pe rând)
La seminar Pe un inel sunt \(8\) chei, dintre care exact una deschide ușa. Încercăm cheile una câte una, alese la întâmplare, până când ușa se deschide. Fie \(D_k\) evenimentul „ușa se deschide la încercarea \(k\)”. Comparăm două metode:
- metoda A (fără revenire): o cheie încercată este pusă deoparte;
- metoda B (cu revenire): după fiecare încercare nereușită cheile se amestecă din nou, astfel că aceeași cheie poate fi încercată de mai multe ori.
Pentru metoda A, desenați arborele de probabilitate al primelor trei încercări și calculați \(\PP(D_k)\) pentru \(k=1,\dots,8\).
Pentru metoda B, calculați \(\PP(D_k)\) pentru \(k\ge1\).
Pentru fiecare metodă, care este probabilitatea să fie necesare mai mult de \(5\) încercări?
Simulați în R cele două metode și comparați frecvențele obținute cu rezultatele de la (a)–(c).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (cheia \(1\) este cea bună; funcțiile incearca_A și incearca_B vor fi folosite și în Exercițiul 12):
incearca_A <- function(n = 8) ___       # poziția cheii 1 într-o permutare aleatoare
incearca_B <- function(n = 8) {
  k <- 1                                # numărul încercării curente
  while (___) k <- k + 1                # cât timp cheia extrasă nu este cheia 1
  k
}
set.seed(8)
nsim <- 1e4
nA <- replicate(nsim, incearca_A())     # numărul de încercări, metoda A
nB <- replicate(nsim, incearca_B())     # numărul de încercări, metoda B
round(table(nA) / nsim, 3)              # comparați cu (a)
rbind(B_simulat = round(table(nB)[1:6] / nsim, 3),
      B_exact   = round(___, 3))        # P(D_1), ..., P(D_6), de la (b)
rbind(simulat = c(A = mean(___), B = mean(___)),   # mai mult de 5 încercări
      exact   = c(A = ___, B = ___))               # valorile de la (c)
Al treilea exercițiu combină cele două situații de mai sus: după fiecare extragere compoziția urnei se schimbă, dar nu prin scoaterea unei bile, ci prin adăugarea uneia. Regula înmulțirii funcționează la fel.
Exercițiul 3 (Urna lui Pólya în trei pași)
Pentru acasă O urnă conține \(2\) bile albe și o bilă neagră. Extragem o bilă la întâmplare, îi notăm culoarea și o punem înapoi în urnă împreună cu încă o bilă de aceeași culoare; repetăm procedeul (urna lui Pólya din Propoziția 12 din Cursul 2, cu \(a=2\), \(n=1\), \(d=1\)). Fie \(A_k\) evenimentul „a \(k\)-a bilă extrasă este albă”.
Desenați arborele de probabilitate al primelor două extrageri și calculați \(\PP(A_2)\).
Calculați probabilitățile succesiunilor (albă, albă, neagră), (albă, neagră, albă) și (neagră, albă, albă). Ce observați?
Determinați probabilitatea ca, în primele trei extrageri, să apară exact \(j\) bile albe, pentru \(j=0,1,2,3\).
Știind că în primele trei extrageri au apărut exact două bile albe, care este probabilitatea ca prima bilă extrasă să fi fost albă?
Scrieți o funcție R care simulează \(m\) extrageri din urna lui Pólya și verificați prin simulare rezultatele de la (a)–(d).
Laborator Schelet de cod pentru (e) — completați locurile marcate cu ___:
urna_polya <- function(a, n, d, m) {
  alba <- logical(m)               # alba[k] = TRUE: extragerea k este albă
  for (k in 1:m) {
    alba[k] <- ___                 # albă cu probabilitatea a / (a + n)
    if (alba[k]) ___ else ___      # adăugăm d bile de culoarea extrasă
  }
  alba
}
set.seed(303)
nsim <- 2e4
X <- t(replicate(nsim, urna_polya(2, 1, 1, 3)))  # nsim linii, 3 coloane
colMeans(X)                        # estimări pentru P(A_1), P(A_2), P(A_3)
nr_albe <- rowSums(X)              # numărul de bile albe din fiecare linie
c(AAN = mean(X[, 1] & X[, 2] & !X[, 3]),
  ANA = ___, NAA = ___)            # celelalte două succesiuni de la (b)
table(nr_albe) / nsim              # comparați cu (c)
mean(___)                          # P(A_1 | exact două albe), ca la (d)
Răspunsuri
\(\PP(A_2)=\frac12+\frac16=\frac23=\PP(A_1)\).
Toate trei sunt egale cu \(\frac{1}{10}\): probabilitatea unei succesiuni depinde doar de numărul bilelor de fiecare culoare, nu și de ordinea lor (Propoziția 12 din Cursul 2).
\(\frac1{10}\), \(\frac15\), \(\frac3{10}\) și \(\frac25\) pentru \(j=0,1,2,3\).
\(\PP(A_1\mid G)=\frac{2/10}{3/10}=\frac23\), unde \(G\) = „exact două bile albe în primele trei extrageri”.
Frecvențele simulate sunt apropiate de valorile exacte: \(\approx0.66\) pentru fiecare dintre \(\PP(A_1)\), \(\PP(A_2)\), \(\PP(A_3)\); \(\approx0.1\) pentru fiecare succesiune de la (b); \(\approx(0.10,\,0.20,\,0.30,\,0.40)\) pentru repartiția numărului de bile albe; \(\approx0.663\) pentru \(\PP(A_1\mid G)\).
3 Formula probabilității totale și formula lui Bayes
Trecem la situațiile în care evenimentul de interes poate apărea în mai multe „scenarii”: probabilitatea lui se calculează adunând contribuțiile scenariilor (formula probabilității totale), iar după ce l-am observat ne întrebăm din ce scenariu provine (formula lui Bayes). Cele trei exerciții au aceeași structură — o cauză ascunsă, un efect observat — și folosesc aceeași funcție R, scrisă la primul dintre ele. În toate trei apare și ideea de actualizare succesivă: fiecare observație nouă modifică probabilitățile obținute după observațiile precedente.
Exercițiul 4 (Trei mașini și o cutie suspectă)
La seminar Reluăm modelul din Exercițiul 4 din Cursul 2, cu alte date și cu o întrebare nouă. Trei mașini \(M_1\), \(M_2\), \(M_3\) produc \(45\%\), \(35\%\), respectiv \(20\%\) din piesele unei fabrici, iar proporțiile de piese defecte sunt \(1\%\), \(2\%\), respectiv \(4\%\).
Care este probabilitatea ca o piesă aleasă la întâmplare să fie defectă?
O piesă aleasă la întâmplare este defectă. Care este probabilitatea să provină de la fiecare mașină?
Piesele sunt ambalate în cutii, toate piesele dintr-o cutie provenind de la aceeași mașină; o cutie aleasă la întâmplare provine de la \(M_1\), \(M_2\), \(M_3\) cu probabilitățile \(0.45\), \(0.35\), \(0.20\). Odată cunoscută mașina, piesele din cutie sunt defecte independent una de alta. Dintr-o cutie verificăm două piese și ambele sunt defecte. Care este acum probabilitatea ca ea să provină de la fiecare mașină? Care este probabilitatea ca a doua piesă să fie defectă, știind că prima este defectă?
Scrieți o funcție R
bayes(prior, veros)care primește probabilitățile a priori și verosimilitățile și întoarce probabilitățile a posteriori. Verificați cu ea punctele (b) și (c), apoi estimați aceleași probabilități simulând \(10^6\) cutii.
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (funcția bayes va fi folosită și în exercițiile următoare):
bayes <- function(prior, veros) {
  produs <- ___                    # P(B_i) * P(observație | B_i)
  ___                              # împărțim la P(observație)
}
prior <- c(M1 = 0.45, M2 = 0.35, M3 = 0.20)
p_def <- c(0.01, 0.02, 0.04)       # P(defect | mașină)
___                                # (a) probabilitatea totală
rbind(o_piesa    = bayes(prior, p_def),
      doua_piese = bayes(prior, ___),          # două piese defecte
      succesiv   = bayes(___, p_def))          # a priori = a posteriori după prima piesă
set.seed(404)
nsim <- 1e6
masina <- sample(1:3, nsim, replace = TRUE, prob = ___)
def1 <- runif(nsim) < p_def[masina]      # prima piesă este defectă?
def2 <- ___                              # dar a doua?
round(rbind(o_piesa    = table(___) / sum(def1),   # mașinile cutiilor cu def1
            doua_piese = table(masina[def1 & def2]) / sum(def1 & def2)), 3)
c(P_E2_dat_E1 = ___, P_E2 = mean(def2))
Aceeași schemă — probabilități a priori, verosimilități, actualizare — stă la baza filtrelor anti-spam. Noutatea față de exercițiul precedent: folosim mai multe observații de naturi diferite, iar absența unui cuvânt este și ea o observație.
Exercițiul 5 (Un filtru anti-spam cu trei cuvinte)
Pentru acasă Extindem filtrul din Exercițiul 5 din Cursul 2. Dintre mesajele primite de un server, \(30\%\) sunt spam. Cuvântul „ofertă” apare în \(40\%\) dintre mesajele spam și în \(5\%\) dintre cele legitime; cuvântul „urgent” apare în \(30\%\), respectiv \(10\%\); cuvântul „ședință” apare în \(2\%\), respectiv \(25\%\). Presupunem că aparițiile celor trei cuvinte sunt independente condiționat de tipul mesajului.
Un mesaj conține cuvântul „ofertă” (despre celelalte cuvinte nu știm nimic). Care este probabilitatea să fie spam?
Un mesaj conține „ofertă” și „urgent”, dar nu conține „ședință”. Aceeași întrebare.
Un mesaj conține „ofertă” și „ședință”, dar nu conține „urgent”. Aceeași întrebare. Comentați.
Scrieți o funcție R care calculează probabilitatea de spam pentru orice combinație de cuvinte prezente și absente, și construiți tabelul celor \(8\) tipuri de mesaje. Filtrul marchează drept spam mesajele cu probabilitatea de spam mai mare decât \(1/2\): ce proporție din mesaje sunt clasificate greșit? Verificați prin simulare.
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (un mesaj este descris de un vector logic x cu trei componente; funcția bayes este cea din Exercițiul 4):
p_S <- 0.3
w_spam  <- c(oferta = 0.40, urgent = 0.30, sedinta = 0.02)
w_legit <- c(oferta = 0.05, urgent = 0.10, sedinta = 0.25)
veros  <- function(x, w) ___          # P(tipul x | clasă): w sau 1 - w, apoi produsul
p_spam <- function(x)
  bayes(c(p_S, 1 - p_S), ___)[1]      # verosimilitățile tipului x
c(b = p_spam(c(TRUE, TRUE, FALSE)), c = p_spam(c(TRUE, FALSE, TRUE)))
tip <- expand.grid(oferta = c(TRUE, FALSE), urgent = c(TRUE, FALSE),
                   sedinta = c(TRUE, FALSE))
v_spam  <- apply(tip, 1, veros, w = w_spam)    # P(tip | spam)
v_legit <- apply(tip, 1, veros, w = w_legit)   # P(tip | legitim)
post    <- apply(tip, 1, p_spam)               # P(spam | tip)
cbind(tip, v_spam, v_legit, P_spam = round(post, 3))
marcat <- post > 0.5
c(eroare = ___)                       # formula probabilității totale
Răspunsuri
\(\PP(S\mid O)\approx0.774\).
\(\PP(S\mid O\cap U\cap Z^c)\approx0.931\).
\(\PP(S\mid O\cap U^c\cap Z)\approx0.176\), mai mică decât probabilitatea a priori \(0.3\): mesajul este cel mai probabil legitim, deși conține „ofertă”.
Sunt marcate drept spam mesajele care nu conțin „ședință” și conțin cel puțin unul dintre cuvintele „ofertă” și „urgent”; proporția mesajelor clasificate greșit este \(\approx0.206\) (sunt marcate \(10.9\%\) dintre mesajele legitime și trec nemarcate \(43.2\%\) dintre mesajele spam). Simularea dă frecvențe apropiate de \(0.931\), \(0.176\) și \(0.206\).
Ultimul exercițiu al secțiunii este cel mai important pentru practică: interpretarea unui test de diagnostic. Calculul este același ca la filtrul anti-spam (două ipoteze, o observație), dar una dintre ipoteze este foarte rară, iar acest fapt schimbă complet concluzia.
Exercițiul 6 (Un test de diagnostic)
La seminar Un test de depistare pentru o afecțiune cu prevalența de \(0.8\%\) are senzitivitatea \(0.92\) și specificitatea \(0.96\) (noțiunile sunt cele din Exemplul 7 din Cursul 2). O persoană aleasă la întâmplare din populație efectuează testul.
Testul este pozitiv. Care este probabilitatea ca persoana să aibă afecțiunea? Dar probabilitatea ca persoana să fie sănătoasă, dacă testul este negativ?
Scrieți o funcție R
posterior(prev, sens, spec)care calculează probabilitatea bolii după un test pozitiv și reprezentați grafic această probabilitate în funcție de prevalență. De la ce prevalență un test pozitiv înseamnă boală cu probabilitate cel puțin \(1/2\)?Persoana repetă testul, iar al doilea rezultat este tot pozitiv. Presupunând că cele două teste sunt independente condiționat de starea persoanei, care este acum probabilitatea bolii?
Simulați o populație de \(10^5\) persoane, fiecare testată de două ori, și estimați probabilitățile de la (a) și (c) ca frecvențe relative condiționate. Sunt rezultatele celor două teste independente?
Laborator Schelet de cod pentru (b)–(d) — completați locurile marcate cu ___ (funcția posterior va fi folosită și în temă):
posterior <- function(prev, sens, spec) {
  ___                              # P(D | T), formula lui Bayes (și pentru un vector prev)
}
posterior(c(0.001, 0.008, 0.05, 0.20), 0.92, 0.96)
prev <- seq(0.001, 0.30, by = 0.001)
plot(prev, posterior(prev, 0.92, 0.96), type = "l", ylim = c(0, 1),
     xlab = "prevalența P(D)", ylab = "P(D | test pozitiv)")
abline(h = 0.5, lty = 3)                         # pragul 1/2
p1 <- posterior(0.008, 0.92, 0.96)               # după un test pozitiv
c(un_test = p1, doua_teste = ___)                # (c): actualizare succesivă
set.seed(606)                                    # (d)
n <- 1e5; prev <- 0.008; sens <- 0.92; spec <- 0.96
bolnav <- runif(n) < prev
test1  <- runif(n) < ___                         # pozitiv: sens sau 1 - spec
test2  <- runif(n) < ifelse(bolnav, sens, 1 - spec)
c(dupa_un_test = mean(___), dupa_doua_teste = ___,
  sanatos_dat_negativ = mean(!bolnav[!test1]))
c(P_T2 = mean(test2), P_T2_dat_T1 = ___)         # sunt testele independente?
4 Independență
În exercițiile de până acum independența a apărut ca ipoteză (încercări cu revenire, cuvinte sau teste independente condiționat). În această secțiune o privim din trei unghiuri: o verificăm pe un spațiu al stărilor enumerat complet, o folosim pentru a calcula fiabilitatea unui sistem și, în final, pentru a analiza un algoritm randomizat — un algoritm care aruncă zaruri și care poate greși, dar cu o probabilitate pe care o controlăm.
Exercițiul 7 (Independență pe două zaruri)
La seminar Aruncăm două zaruri echilibrate. Ca în Exercițiul 1, notăm cu \(x\) și \(y\) rezultatele celor două zaruri.
Fie \(S_7\) = „suma este \(7\)” și \(U_i\) = „primul zar arată \(i\)”. Arătați că \(S_7\) și \(U_i\) sunt independente pentru orice \(i\in\{1,\dots,6\}\). Rămâne afirmația adevărată pentru \(S_6\) = „suma este \(6\)”?
Fie \(I_1\) = „primul zar arată un număr impar”, \(I_2\) = „al doilea zar arată un număr impar” și \(I_3\) = „suma este impară”. Arătați că \(I_1,I_2,I_3\) sunt independente două câte două, dar nu sunt (mutual) independente.
Fie \(A\) = „primul zar arată \(1\), \(2\) sau \(3\)”, \(B\) = „primul zar arată \(3\), \(4\) sau \(5\)” și \(C\) = „suma este \(9\)”. Arătați că \(\PP(A\cap B\cap C)=\PP(A)\,\PP(B)\,\PP(C)\), deși nicio pereche dintre cele trei evenimente nu este independentă.
Scrieți o funcție R
indep(A, B)care verifică, pe spațiul stărilor enumerat, dacă două evenimente sunt independente, și verificați cu ea punctele (a)–(c).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
omega <- expand.grid(x = 1:6, y = 1:6)
x <- omega$x; y <- omega$y; s <- x + y           # s = suma
indep <- function(A, B)
  isTRUE(all.equal(___, ___))                    # P(A și B) față de P(A) P(B)
rbind(suma_7 = sapply(1:6, function(i) indep(s == 7, x == i)),
      suma_6 = sapply(1:6, function(i) indep(___, x == i)))
I1 <- x %% 2 == 1; I2 <- ___; I3 <- ___          # evenimentele de la (b)
c(I1_I2 = indep(I1, I2), I1_I3 = indep(I1, I3), I2_I3 = indep(I2, I3))
c(P_intersectie = mean(I1 & I2 & I3), produs = ___)
A <- ___; B <- x %in% 3:5; C <- s == 9           # evenimentele de la (c)
c(A_B = indep(A, B), A_C = indep(A, C), B_C = indep(B, C))
c(P_intersectie = mean(A & B & C), produs = mean(A) * mean(B) * mean(C))
Independența este ipoteza de lucru în studiul fiabilității: componentele unui sistem se defectează, de regulă, din cauze fără legătură între ele. Exercițiul următor arată și o tehnică de laborator nouă — enumerarea unui spațiu al stărilor în care rezultatele nu sunt egal probabile.
Exercițiul 8 (Fiabilitatea unui sistem)
Dacă timpul permite Componentele sistemelor de mai jos funcționează independent una de alta. Un sistem funcționează dacă există un drum de la \(S\) la \(T\) format numai din componente funcționale.
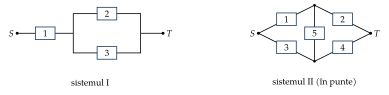
În sistemul I, componenta \(1\) (un distribuitor de sarcină) funcționează cu probabilitatea \(0.95\), iar componentele \(2\) și \(3\) (două servere) cu probabilitatea \(0.9\) fiecare. Calculați probabilitatea ca sistemul să funcționeze.
Știind că sistemul I nu funcționează, care este probabilitatea ca distribuitorul să fie defect?
Un sistem cu redundanță triplă este format din trei module identice și funcționează dacă cel puțin două dintre ele funcționează. Dacă fiecare modul funcționează cu probabilitatea \(p\), calculați probabilitatea de funcționare a sistemului. Pentru ce valori ale lui \(p\) este el mai fiabil decât un singur modul?
În sistemul II (puntea din Exercițiul 8 din Cursul 2), componentele funcționează cu probabilitățile \(p_1=p_4=0.9\), \(p_2=p_3=0.8\), \(p_5=0.7\). Calculați probabilitatea de funcționare.
Scrieți o funcție R care calculează exact fiabilitatea unui sistem cu \(m\) componente, enumerând cele \(2^m\) stări posibile, și verificați (a), (c) și (d). Estimați prin simulare probabilitatea de la (b).
Laborator Schelet de cod pentru (e) — completați locurile marcate cu ___ (o stare este un vector logic cu \(m\) componente; phi primește matricea stărilor, câte una pe linie, și spune pentru fiecare dacă sistemul funcționează):
fiabilitate <- function(phi, p) {
  m <- length(p)
  stari <- as.matrix(expand.grid(rep(list(c(TRUE, FALSE)), m)))
  pr <- apply(stari, 1, function(s) ___)        # probabilitatea stării s
  sum(pr[phi(stari)])              # adunăm stările „bune”
}
phi_I   <- function(s) s[, 1] & ___
phi_2_3 <- function(s) ___                      # cel puțin 2 din 3
phi_II  <- function(s) (s[, 1] & s[, 2]) | (s[, 3] & s[, 4]) |
  ___                                           # drumurile prin puntea 5
c(I = fiabilitate(phi_I, c(0.95, 0.9, 0.9)),
  doi_din_trei = fiabilitate(phi_2_3, rep(0.9, 3)),
  II = fiabilitate(phi_II, c(0.9, 0.8, 0.8, 0.9, 0.7)),
  II_egal = fiabilitate(phi_II, rep(0.9, 5)))
set.seed(808)
nsim <- 1e5
f1 <- runif(nsim) < 0.95; f2 <- runif(nsim) < 0.9; f3 <- runif(nsim) < 0.9
merge <- ___                                    # sistemul I funcționează
c(P_F = mean(merge), P_F1c_dat_Fc = ___)
Răspunsuri
\(\PP(F)=0.9405\).
\(\PP(F_1^c\mid F^c)=\frac{0.05}{0.0595}\approx0.840\).
\(\PP(F)=3p^2-2p^3\) (de exemplu, \(0.972\) pentru \(p=0.9\)); sistemul este mai fiabil decât un singur modul dacă și numai dacă \(p>\frac12\).
\(\PP(F)\approx0.9488\) (condiționând după starea punții: \(\PP(F\mid F_5)=0.9604\), \(\PP(F\mid F_5^c)=0.9216\)).
Enumerarea dă exact \(0.9405\), \(0.972\) și \(0.9488\) (iar pentru cinci componente cu \(p=0.9\), \(0.9785\), valoarea din Exercițiul 8 din Cursul 2); prin simulare, frecvența funcționării este \(\approx0.940\), iar printre repetările în care sistemul cade distribuitorul este defect în \(\approx84\%\) din cazuri.
Ultimul exercițiu al secțiunii aplică aceleași două instrumente — independența și regula înmulțirii — într-un context tipic informaticii: un algoritm care folosește numere aleatoare pentru a răspunde repede la o întrebare, cu prețul unei probabilități mici de a greși.
Exercițiul 9 (Verificarea egalității a două polinoame)
Dacă timpul permite Un program primește două polinoame de grad cel mult \(d\): \(F\), scris ca produs de factori, și \(G\), scris în formă dezvoltată, \[ F(x)=(x-a_1)(x-a_2)\cdots(x-a_d),\qquad G(x)=c_dx^d+c_{d-1}x^{d-1}+\dots+c_1x+c_0, \] și trebuie să decidă dacă \(F\) și \(G\) sunt același polinom. Dezvoltarea produsului cere un număr de înmulțiri de ordinul \(d^2\). Următorul algoritm randomizat cere doar un număr de operații de ordinul \(d\): alegem la întâmplare, uniform, un număr \(r\in\{1,2,\dots,100d\}\) și calculăm \(F(r)\) și \(G(r)\); dacă \(F(r)\ne G(r)\) răspundem „diferite”, altfel răspundem „egale”.
Arătați că răspunsul „diferite” este întotdeauna corect și că, dacă \(F\ne G\), algoritmul greșește (răspunde „egale”) cu probabilitate cel mult \(1/100\).
Repetăm testul de \(k\) ori, cu numere \(r_1,\dots,r_k\) alese independent (cu revenire), și răspundem „egale” doar dacă \(F(r_j)=G(r_j)\) pentru toți \(j\). Arătați că, dacă \(F\ne G\), probabilitatea de eroare este cel mult \(100^{-k}\). Câte repetări garantează o probabilitate de eroare sub \(10^{-9}\)?
Ce margine obținem dacă numerele \(r_1,\dots,r_k\) sunt alese fără revenire? Comparați cele două margini pentru \(d=5\) și \(k=2\). Ce se întâmplă pentru \(k=d+1\)?
Implementați algoritmul în R și aplicați-l polinomului \(F(x)=(x-1)(x+2)(x-3)(x+4)(x-5)\) și polinoamelor: \(G_0\), dezvoltarea corectă a lui \(F\); \(G_1\), obținut din \(G_0\) prin înlocuirea coeficientului \(51\) al lui \(x^2\) cu \(15\); \(G_2=F+D\), unde \(D(x)=(x-10)(x-20)(x-30)(x-40)(x-50)\). Estimați prin simulare probabilitatea de eroare și comparați-o cu marginile de la (a)–(c).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (\(F\) este dat prin vectorul rădăcinilor, \(G\) prin vectorul coeficienților, de la \(c_d\) la \(c_0\); funcția dezvolta, dată, calculează coeficienții unui produs de factori \((x-a)\); test_egalitate va fi folosită și în temă):
evalueaza_produs <- function(rad, r) {   # F(r), F dat prin rădăcini
  v <- 1 + 0 * r
  for (a in rad) v <- ___
  v
}
evalueaza <- function(coef, r) {         # G(r), schema lui Horner
  v <- 0 * r
  for (cj in coef) v <- ___
  v
}
dezvolta <- function(rad) {              # coeficienții produsului
  coef <- 1
  for (a in rad) coef <- c(coef, 0) - a * c(0, coef)
  coef
}
rad <- c(1, -2, 3, -4, 5)                # rădăcinile lui F
G0 <- dezvolta(rad); G0
G1 <- G0; G1[4] <- 15                    # coeficientul lui x^2: 51 -> 15
G2 <- G0 + ___                           # G2 = F + D
test_egalitate <- function(rad, coef, k = 1, N = 100 * length(rad),
                           revenire = TRUE) {
  r <- ___                               # k numere alese din 1:N
  all(___)                               # TRUE = „egale”
}
set.seed(909)
nsim <- 2e4
c(G0 = mean(replicate(nsim, test_egalitate(rad, G0))),
  G1 = mean(replicate(nsim, test_egalitate(rad, G1))),
  G2 = mean(replicate(nsim, test_egalitate(rad, G2))))
Răspunsuri
(demonstrație) Dacă \(F\ne G\), \(\PP(\text{eroare})\le\frac{d}{100d}=\frac1{100}\).
\(\PP(\text{eroare})\le100^{-k}\); \(k=5\) repetări sunt suficiente (marginea este \(10^{-10}\)), oricât de mare ar fi \(d\).
\(\PP(\text{eroare})\le\prod_{j=1}^{k}\frac{d-j+1}{100d-j+1}\le100^{-k}\); pentru \(d=5\), \(k=2\): \(\frac{5}{500}\cdot\frac{4}{499}\approx8.02\cdot10^{-5}<10^{-4}\); pentru \(k=d+1\) marginea este \(0\): eroarea devine imposibilă.
\(F(x)=x^5-3x^4-23x^3+51x^2+94x-120\). Frecvența răspunsului „egale” (o repetare, \(N=500\)) este \(1\) pentru \(G_0\) (corect), \(0\) pentru \(G_1\) (\(F-G_1=36x^2\) nu are rădăcini în \(\{1,\dots,500\}\)) și \(\approx0.01\) pentru \(G_2\) (exact \(5/500=0.01\): marginea de la (a) este atinsă).
5 Probleme clasice prin simulare
Încheiem partea principală cu două probleme clasice din Cursul 2, privite acum ca programe: scriem câte o funcție care simulează o singură desfășurare a experimentului, o repetăm de multe ori cu replicate și comparăm frecvențele cu rezultatele teoretice. Odată scrisă simularea, o variantă nouă a problemei cere doar schimbarea câtorva linii de cod — iar calculul teoretic al variantei devine un bun exercițiu de formula probabilității totale.
Exercițiul 10 (Monty Hall prin simulare)
Dacă timpul permite Reluăm jocul din Exemplul 18 din Cursul 2: în spatele uneia dintre uși se află o mașină, în spatele celorlalte câte o capră; concurentul alege o ușă, iar gazda, care știe unde este mașina, deschide uși cu capre dintre celelalte.
Scrieți o funcție R care simulează un joc cu trei uși și estimați probabilitatea de câștig pentru strategiile „păstrez ușa” și „schimb ușa”. Comparați cu valorile din Exemplul 18 din Cursul 2.
Generalizare: sunt \(n\ge3\) uși, iar gazda deschide \(m\) uși cu capre (\(1\le m\le n-2\)) dintre cele \(n-1\) nealese. Concurentul poate păstra ușa aleasă sau poate alege, la întâmplare, una dintre celelalte \(n-m-1\) uși rămase închise. Calculați probabilitatea de câștig pentru fiecare strategie. Merită întotdeauna să schimbe?
Verificați formula de la (b) prin simulare, pentru câteva perechi \((n,m)\).
Laborator Schelet de cod pentru (a), (c) — completați locurile marcate cu ___ (funcția monty tratează direct cazul general, cu \(n\) uși și \(m\) uși deschise; alege evită capcana lui sample semnalată în breviar):
alege <- function(x, k = 1) x[sample(length(x), k)]  # k elemente din x
monty <- function(n = 3, m = 1) {
  masina  <- sample(1:n, 1)
  alegere <- sample(1:n, 1)
  capre <- ___                                 # uși pe care gazda le
  deschise <- alege(capre, m)                  # poate deschide
  ramase <- ___                                # uși închise, nealese
  noua <- alege(ramase)                        # ușa după schimbare
  c(pastrez = alegere == masina, schimb = ___)
}
set.seed(1010)
nsim <- 2e4
rowMeans(replicate(nsim, monty()))             # (a): frecvențele de câștig
cazuri <- rbind(c(3, 1), c(4, 1), c(4, 2), c(10, 1), c(10, 8))
t(apply(cazuri, 1, function(v) {
  n <- v[1]; m <- v[2]
  c(n = n, m = m, rowMeans(replicate(nsim, monty(n, m))),
    teoretic = ___)                            # formula de la (b)
}))
Răspunsuri
Frecvențele de câștig sunt apropiate de \(\frac13\) („păstrez”) și \(\frac23\) („schimb”).
„Păstrez” câștigă cu probabilitatea \(\frac1n\), „schimb” cu probabilitatea \(\frac{n-1}{n\,(n-m-1)}\); schimbarea este întotdeauna avantajoasă (inegalitatea revine la \(m>0\)).
Frecvențele simulate ale strategiei „schimb” sunt apropiate de valorile teoretice: \(0.667\), \(0.375\), \(0.75\), \(0.1125\) și \(0.9\) pentru \((n,m)=(3,1),(4,1),(4,2),(10,1),(10,8)\); cele ale strategiei „păstrez”, de \(\frac1n\).
A doua problemă clasică este un experiment fără un număr fixat de pași: jocul continuă până când se întâmplă ceva. În R, aceasta înseamnă o buclă while, ca la metoda B din Exercițiul 2.
Exercițiul 11 (Ruina jucătorului prin simulare)
Pentru acasă Un jucător pornește cu capitalul \(k\) și joacă runde independente: la fiecare rundă câștigă o unitate cu probabilitatea \(p\) sau pierde o unitate cu probabilitatea \(q=1-p\). Jocul se oprește când capitalul ajunge la \(0\) (ruină) sau la ținta \(N\). Notăm cu \(p_k\) probabilitatea de ruină, dată de Propoziția 13 din Cursul 2.
Pentru \(N=3\) și \(k=1\), determinați direct \(p_1\), scriind formula probabilității totale după rezultatul primei runde. Verificați cu formula din Propoziția 13 din Cursul 2.
Calculați probabilitatea de ruină pentru \(k=3\) și \(N=10\), în jocul echitabil (\(p=1/2\)) și în jocul ușor defavorabil cu \(p=0.45\).
Scrieți o funcție R care simulează un joc și întoarce evoluția capitalului. Reprezentați grafic două jocuri simulate.
Estimați prin simulare, în cele două situații de la (b), probabilitatea de ruină și numărul mediu de runde ale unui joc. Comparați probabilitățile cu valorile teoretice, pentru \(k=3\) și apoi pentru toate valorile \(k=1,\dots,9\).
Laborator Schelet de cod pentru (c), (d) — completați locurile marcate cu ___ (funcțiile vor fi folosite și în temă):
joc_ruina <- function(k, N, p) {
  capital <- k                     # capitalul după fiecare rundă
  while (___) {                    # până la ruină sau până la țintă
    k <- k + ___                   # +1 cu probabilitatea p, altfel -1
    capital <- c(capital, k)
  }
  capital
}
p_ruina <- function(k, N, p) {     # formula din Propoziția despre ruină
  if (p == 0.5) return(___)
  r <- (1 - p) / p
  ___
}
rezumat <- function(k, N, p) {     # ruina? câte runde?
  capital <- joc_ruina(k, N, p)
  c(ruina = ___, runde = length(capital) - 1)
}
set.seed(1112)
nsim <- 1e4
echitabil    <- rowMeans(replicate(nsim, rezumat(3, 10, 0.5)))
defavorabil  <- rowMeans(replicate(nsim, rezumat(3, 10, 0.45)))
rbind(echitabil, defavorabil)
Răspunsuri
\(p_1=\dfrac{q}{1-pq}\): \(\frac23\) pentru \(p=\frac12\) și \(\approx0.731\) pentru \(p=0.45\), ca în Propoziția 13 din Cursul 2.
\(p_3=0.7\) în jocul echitabil și \(p_3\approx0.872\) pentru \(p=0.45\).
Fiecare joc este un drum în trepte care pornește din \(k\) și se oprește la \(0\) sau la \(N\); durata lui variază mult de la un joc la altul.
Frecvențele ruinei sunt apropiate de \(0.7\), respectiv \(0.872\); un joc durează în medie aproximativ \(21\) de runde (echitabil), respectiv \(17\) (defavorabil). Pentru \(k=1,\dots,9\) frecvențele simulate se așază pe curbele teoretice: dreapta \(p_k=1-k/N\) pentru \(p=\frac12\) și o curbă situată deasupra ei pentru \(p=0.45\).
6 Exerciții suplimentare
Exercițiile de mai jos, pentru studiul individual (cu răspunsuri finale), reiau modelele și funcțiile R din ședință: cheile din Exercițiul 2, funcția bayes din Exercițiul 4 și jocul lui Monty Hall din Exercițiul 10.
Exercițiul 12 (Paznicul obosit)
Pentru acasă Un paznic are pe inel cele \(8\) chei din Exercițiul 2. Când este odihnit, încearcă cheile cu metoda A (fără revenire); când este obosit, cu metoda B (cu revenire). Paznicul este obosit într-o noapte din trei.
Într-o noapte, primele \(5\) încercări ale paznicului eșuează. Care este probabilitatea ca el să fie obosit?
Calculați aceeași probabilitate după \(j\) încercări eșuate, pentru \(j=0,1,\dots,8\), și comentați.
Verificați rezultatul de la (a) prin simulare.
Răspunsuri
\(\PP(O\mid R_5)\approx0.406\), unde \(O\) = „paznicul este obosit” și \(R_5\) = „primele \(5\) încercări eșuează”.
\(\PP(O\mid R_j)=\dfrac{\frac13\,(7/8)^j}{\frac13\,(7/8)^j+\frac23\cdot\frac{8-j}{8}}\): \(0.333\) pentru \(j=0\) și \(j=1\) (un singur eșec nu aduce nicio informație), apoi \(0.338\), \(0.349\), \(0.370\), \(0.406\), \(0.473\), \(0.611\) și \(1\) pentru \(j=8\) (un paznic odihnit nu poate eșua de \(8\) ori).
Frecvența simulată este apropiată de \(0.406\) (și, după \(7\) eșecuri, de \(0.611\)).
Exercițiul 13 (Un zar, apoi monede)
Pentru acasă Aruncăm un zar echilibrat și apoi aruncăm o monedă echilibrată de atâtea ori câte puncte a arătat zarul.
Care este probabilitatea să nu obținem niciun cap?
Știind că nu am obținut niciun cap, care este probabilitatea ca zarul să fi arătat \(i\), pentru \(i=1,\dots,6\)?
Care este probabilitatea să obținem exact \(4\) capete?
Verificați (a)–(c) prin simulare.
Răspunsuri
\(\frac{21}{128}\approx0.164\).
\(\frac{2^{6-i}}{63}\), adică \(\frac{32}{63},\frac{16}{63},\frac{8}{63},\frac{4}{63},\frac{2}{63},\frac{1}{63}\) pentru \(i=1,\dots,6\).
\(\frac{29}{384}\approx0.0755\).
Frecvențele simulate sunt apropiate de \(0.164\) și \(0.0755\), iar repartiția zarului printre repetările fără niciun cap este apropiată de \((0.508,\,0.254,\,0.127,\,0.063,\,0.032,\,0.016)\).
Exercițiul 14 (Monty Hall cu o gazdă cu preferințe)
Pentru acasă În jocul cu trei uși din Exercițiul 10, concurentul alege ușa \(1\). Când gazda are de ales între ușile \(2\) și \(3\) (adică atunci când mașina este în spatele ușii \(1\)), ea deschide ușa \(2\) cu probabilitatea \(\theta\) și ușa \(3\) cu probabilitatea \(1-\theta\), unde \(\theta\in[0,1]\) este cunoscut concurentului.
Gazda deschide ușa \(2\). Care este probabilitatea ca schimbarea ușii să aducă mașina? Dar dacă gazda deschide ușa \(3\)?
Arătați că strategia „schimb” câștigă, în total, tot cu probabilitatea \(2/3\), oricare ar fi \(\theta\).
Verificați prin simulare pentru \(\theta=1\) (gazda deschide ușa \(2\) ori de câte ori poate) și \(\theta=0.8\).
Răspunsuri
\(\frac{1}{1+\theta}\) dacă gazda deschide ușa \(2\) și \(\frac{1}{2-\theta}\) dacă deschide ușa \(3\); ambele sunt cel puțin \(\frac12\).
\(\PP(\text{câștig prin schimbare})=\frac23\) pentru orice \(\theta\).
Pentru \(\theta=1\): frecvențe apropiate de \(\frac12\), \(1\) și \(\frac23\); pentru \(\theta=0.8\): de \(\frac1{1.8}\approx0.556\), \(\frac1{1.2}\approx0.833\) și \(\frac23\).
Exercițiul 15 (Un bit transmis prin relee)
Pentru acasă Un bit este transmis printr-un lanț de \(n\) relee. Fiecare releu, independent de celelalte, inversează bitul primit cu probabilitatea \(\varepsilon=0.1\) și îl transmite neschimbat cu probabilitatea \(0.9\). Fie \(a_n\) probabilitatea ca bitul primit după \(n\) relee să coincidă cu cel trimis.
Arătați că \(a_{n+1}=0.9\,a_n+0.1\,(1-a_n)\), cu \(a_0=1\), și calculați \(a_1,\dots,a_4\).
Verificați că \(a_n=\frac12\big(1+0.8^n\big)\). Ce se întâmplă când \(n\) este mare?
Pentru \(n=4\): știind că bitul a ajuns corect, care este probabilitatea ca primul releu să nu-l fi inversat?
Calculați \(a_n\) în R cu o buclă
forși verificați (a) și (c) prin simulare.
Răspunsuri
\(a_1=0.9\), \(a_2=0.82\), \(a_3=0.756\), \(a_4=0.7048\).
(demonstrație, prin inducție) \(a_n\to\frac12\): după multe relee, bitul primit nu mai poartă nicio informație despre bitul trimis.
\(\PP(V_1^c\mid K_4)=\frac{0.9\,a_3}{a_4}\approx0.965\), unde \(V_1\) = „primul releu inversează bitul” și \(K_4\) = „bitul ajunge corect după \(4\) relee”.
\(a_{10}\approx0.554\), \(a_{20}\approx0.506\); frecvențele simulate sunt apropiate de \(0.7048\) și \(0.965\).
7 Temă
Aruncăm două zaruri echilibrate. Calculați probabilitatea ca cel puțin unul dintre zaruri să arate \(6\), știind că: (i) zarurile arată numere diferite; (ii) suma este cel puțin \(10\). Verificați în R, prin enumerare, cu funcția
p_conddin Exercițiul 1. Răspuns: (i) \(10/30=1/3\); (ii) \(5/6\).Un lot de \(12\) plăci video conține \(3\) plăci defecte. Testăm pe rând, fără revenire, \(3\) plăci alese la întâmplare. Calculați probabilitatea ca: (i) niciuna să nu fie defectă; (ii) prima placă defectă găsită să fie a treia testată. Răspuns: (i) \(\frac{9}{12}\cdot\frac{8}{11}\cdot\frac{7}{10}=\frac{21}{55}\approx0.382\); (ii) \(\frac{9}{12}\cdot\frac{8}{11}\cdot\frac{3}{10}=\frac{9}{55}\approx0.164\).
Un student trebuie să repartizeze \(2\) bile albe și \(2\) bile negre în două urne, astfel încât nicio urnă să nu rămână goală. Profesorul alege apoi o urnă la întâmplare și extrage din ea o bilă; studentul promovează dacă bila este neagră. (i) Cum trebuie repartizate bilele pentru ca probabilitatea de promovare să fie maximă? (ii) Scrieți o funcție R care calculează probabilitatea de promovare pentru o repartizare dată și găsiți repartizarea optimă pentru \(10\) bile albe și \(10\) negre. Răspuns: (i) o bilă neagră singură într-o urnă, celelalte trei în a doua: \(\frac12\big(1+\frac13\big)=\frac23\); (ii) aceeași idee: \(\frac12\big(1+\frac{9}{19}\big)=\frac{14}{19}\approx0.737\).
O companie asigură două categorii de șoferi, la fel de numeroase: cei din prima categorie au un accident într-un an cu probabilitatea \(0.2\), cei din a doua cu probabilitatea \(0.05\), independent de la un an la altul. Pentru un asigurat ales la întâmplare, fie \(A_1\), \(A_2\) evenimentele „are un accident în primul”, respectiv „în al doilea an”. Calculați \(\PP(A_1)\), \(\PP(A_2\mid A_1)\) și probabilitatea ca asiguratul să fie din prima categorie, știind că a avut un accident în primul an. Sunt \(A_1\) și \(A_2\) independente? Răspuns: \(0.125\); \(0.02125/0.125=0.17\); \(0.8\); nu sunt independente (\(0.17>0.125\)), ci doar independente condiționat de categorie.
Un test de alcoolemie este pozitiv cu probabilitatea \(0.99\) pentru un șofer care a depășit limita legală și negativ cu probabilitatea \(0.99\) pentru unul care nu a depășit-o; \(0.5\%\) dintre șoferi depășesc limita. (i) Care este probabilitatea ca un șofer testat pozitiv să fi depășit limita? (ii) Dar într-o seară în care \(30\%\) dintre șoferi depășesc limita? (iii) Folosind funcția
posteriordin Exercițiul 6, găsiți în R cea mai mică valoare \(p\) a senzitivității și specificității (presupuse egale) pentru care probabilitatea de la (i) este cel puțin \(0.95\). Răspuns: (i) \(\approx0.332\); (ii) \(\approx0.977\); (iii) \(p\approx0.9997\). Indicație pentru (iii): evaluațiposterior(0.005, p, p)pentrup <- seq(0.99, 1, by = 0.00001).Printr-un canal de comunicație se transmit biți: \(0\) cu probabilitatea \(0.6\) și \(1\) cu probabilitatea \(0.4\). Un \(0\) transmis este recepționat greșit (ca \(1\)) cu probabilitatea \(0.05\), iar un \(1\) transmis este recepționat greșit cu probabilitatea \(0.10\). (i) Care este probabilitatea să recepționăm \(1\)? (ii) Dacă am recepționat \(1\), care este probabilitatea să fi fost transmis \(1\)? (iii) Pe un alt canal, care inversează fiecare bit cu probabilitatea \(0.1\), independent, fiecare bit se transmite de trei ori și se decodifică prin vot majoritar. Care este probabilitatea unei decodificări greșite? Răspuns: (i) \(0.4\cdot0.9+0.6\cdot0.05=0.39\); (ii) \(0.36/0.39\approx0.923\); (iii) \(3\cdot0.1^2\cdot0.9+0.1^3=0.028\) (comparați cu Exercițiul 8(c)).
Folosiți funcția
test_egalitatedin Exercițiul 9 pentru a verifica identitatea \((x-1)(x-2)(x-3)(x-4)=x^4-10x^3+35x^2-50x+24\), apoi varianta în care coeficientul \(35\) este înlocuit, din greșeală, cu \(53\). Ce răspunsuri obțineți în \(1000\) de rulări? Câte repetări \(k\) garantează o probabilitate de eroare sub \(10^{-12}\)? Răspuns: în primul caz, „egale” la fiecare rulare; în al doilea, „diferite” la fiecare rulare, pentru că \(F-G=-18x^2\) nu are rădăcini în \(\{1,\dots,400\}\); \(k=6\).La ruleta europeană, un pariu pe „roșu” este câștigat cu probabilitatea \(p=18/37\). Un jucător pornește cu \(5\) unități, pariază câte o unitate la fiecare rundă și se oprește la \(0\) sau la \(10\) unități. Estimați cu funcțiile din Exercițiul 11, din \(10^4\) jocuri simulate, probabilitatea de ruină și numărul mediu de runde, și comparați probabilitatea cu Propoziția 13 din Cursul 2. Reprezentați grafic trei jocuri simulate. Răspuns: probabilitatea de ruină este \(\approx0.567\); un joc durează în medie aproximativ \(25\) de runde.
Bibliografie
Bertsekas, Dimitri P., and John N. Tsitsiklis. 2008. Introduction to Probability. 2nd ed. Athena Scientific.
Blitzstein, Joseph K., and Jessica Hwang. 2019. Introduction to Probability. 2nd ed. CRC Press.
Mitzenmacher, Michael, and Eli Upfal. 2017. Probability and Computing: Randomization and Probabilistic Techniques in Algorithms and Data Analysis. 2nd ed. Cambridge University Press.
Wagaman, Amy S., and Robert P. Dobrow. 2021. Probability with Applications and R. 2nd ed. Wiley.