Timpul până la următoarea cerere primită de un server, zgomotul unui senzor sau numerele produse de runif sunt descrise de câteva repartiții continue atât de des întâlnite încât au primit un nume: exponențială, normală, uniformă. Cursul de astăzi le studiază pe rând, explică de unde provin (de ce timpii de așteptare sunt exponențiali, de ce sumele sunt aproximativ normale) și arată cum se obține repartiția unei funcții \(g(X)\) de o variabilă cu repartiție cunoscută, inclusiv cum simulăm orice repartiție pornind de la numere uniforme.
Obiective. La sfârșitul cursului studentul trebuie să poată:
recunoaște și folosi repartițiile \(\Unif(a,b)\), \(\Exp(\lambda)\), \(\Norm(\mu,\sigma^2)\), \(\GammaD(\alpha,\lambda)\) și \(\BetaD(a,b)\): densitate, funcție de repartiție, medie, varianță și funcțiile R cu prefixele d, p, q, r;
simula o repartiție dată pornind de la \(\Unif(0,1)\), prin metoda inversei;
explica și aplica lipsa de memorie a repartiției exponențiale și legătura ei cu procesul Poisson și cu repartiția geometrică;
calcula probabilități și cuantile normale prin standardizare și cu pnorm, qnorm și ilustra prin simulare de ce sumele de variabile independente sunt aproximativ normale;
determina repartiția lui \(Y=g(X)\) cu metoda funcției de repartiție și cu formula schimbării de variabilă;
calcula și interpreta coeficienții de asimetrie și de aplatizare ai unei repartiții sau ai unui set de date.
Structura. Recapitulare; repartiția uniformă; universalitatea repartiției uniforme (metoda inversei); repartiția exponențială (lipsa de memorie, procesul Poisson, trecerea de la timp discret la timp continuu); repartiția normală (standardizare, regula 68–95–99.7, de ce apare atât de des); repartițiile Gamma și Beta; transformări de variabile aleatoare; asimetria și aplatizarea unei repartiții; tabel sinteză; exerciții rezolvate și exerciții propuse. Pentru aprofundare: (Blitzstein and Hwang 2019, cap. 5 și 8), (Bertsekas and Tsitsiklis 2008, cap. 3–4), (Chan 2021, cap. 4, în special sec. 4.5–4.8).
În Cursul 4 am introdus noțiunile generale legate de variabilele aleatoare continue: densitatea, funcția de repartiție, cuantilele, media și varianța. În acest curs studiem câteva repartiții continue care apar atât de des în aplicații încât merită un nume propriu. Repartiția uniformă modelează alegerea „la întâmplare” a unui punct dintr-un interval și, după cum vom vedea, stă la baza simulării oricărei alte repartiții (universalitatea repartiției uniforme). Repartiția exponențială modelează duratele de viață și timpii de așteptare ai unor sisteme care „nu îmbătrânesc” (proprietatea lipsei de memorie). Repartiția normală (gaussiană) este, fără îndoială, cea mai importantă repartiție a teoriei probabilităților și a statisticii, datorită teoremei limită centrale (Cursul 7). Vom prezenta pe scurt și repartițiile Gamma și Beta, care generalizează exemplele anterioare și vor reapărea în partea de statistică.
În ultima parte a cursului răspundem la întrebarea: dacă \(X\) are o repartiție cunoscută și \(g\) este o funcție dată, care este repartiția variabilei \(Y=g(X)\)? Vom descrie metoda funcției de repartiție și formula schimbării de variabilă pentru densități, cu aplicații la repartițiile hi-pătrat și log-normală.
1 Recapitulare
Repartițiile de astăzi sunt cazuri particulare ale cadrului general din Cursul 4; reamintim instrumentele pe care le aplicăm fiecăreia dintre ele, precum și două repartiții discrete din Cursul 3 ale căror analoage continue le întâlnim acum.
Rezultate din Cursurile 3 și 4 folosite azi
Densitatea de repartiție (Definiția 1 din Cursul 4): \(\PP(X\in A)=\int_Af(x)\dd x\); o funcție \(f\) este densitate dacă \(f\ge0\) și \(\int_{\R}f(x)\dd x=1\) (Propoziția 2 din Cursul 4); punctele au probabilitate zero (Propoziția 3 din Cursul 4).
Funcția de repartiție\(F(x)=\PP(X\le x)=\int_{-\infty}^xf(t)\dd t\) este continuă și \(F'=f\) în punctele de continuitate ale lui \(f\) (Teorema 6 din Cursul 4); \(\PP(a<X\le b)=F(b)-F(a)\), iar \(\PP(X>x)=1-F(x)\) este funcția de supraviețuire.
Cuantila de ordin \(\alpha\) (Definiția 7 din Cursul 4): \(x_\alpha=F^{-1}(\alpha)=\inf\{x: F(x)\ge\alpha\}\), soluția ecuației \(F(x)=\alpha\) atunci când \(F\) este continuă și strict crescătoare; mediana este \(x_{1/2}\).
Media\(\E[X]=\int_{\R}xf(x)\dd x\) (Definiția 8 din Cursul 4) și formula de transport\(\E[g(X)]=\int_{\R}g(x)f(x)\dd x\) (Teorema 10 din Cursul 4).
Momente și varianță (Definiția 11 din Cursul 4): \(\Var(X)=\E[X^2]-(\E[X])^2\); \(\E[aX+b]=a\E[X]+b\), \(\Var(aX+b)=a^2\Var(X)\), iar pentru variabile independente \(\Var(X+Y)=\Var(X)+\Var(Y)\) (Propoziția 12 din Cursul 4).
Exemple pe care le reluăm: repartiția logistică (Exemplul 3 din Cursul 4), densitatea nemărginită \(\frac{1}{2\sqrt x}\) pe \((0,1]\) (Exemplul 1 din Cursul 4) și repartiția Cauchy, care nu are medie (Exemplul 8 din Cursul 4).
Repartiția geometrică (Definiția 13 din Cursul 3): \(\PP(X>n)=(1-p)^n\) și proprietatea lipsei de memorie (Propoziția 14 din Cursul 3); astăzi îi găsim analogul continuu, repartiția exponențială.
Repartiția Poisson (Definiția 16 din Cursul 3) și aproximarea Poisson a repartiției binomiale (Teorema 17 din Cursul 3): pe ele se sprijină procesul Poisson.
2 Repartiția uniformă
2.1 Definiție, densitate și funcție de repartiție
Alegem un punct „la întâmplare” în intervalul \([a,b]\), în sensul că nicio regiune a intervalului nu este favorizată. Formal, cerem ca densitatea să fie constantă pe \([a,b]\) și nulă în rest: \(f(x)=c\) pentru \(x\in[a,b]\). Cum \(f\) este o densitate, \(c\ge0\) și \[
1=\int_{-\infty}^{+\infty}f(x)\dd x=\int_a^b c\dd x=c\,(b-a),\qquad\text{deci}\qquad c=\frac{1}{b-a}.
\]
Definiția 1(Repartiția uniformă)
Fie \(a<b\). O variabilă aleatoare \(U\) este repartizată uniform pe intervalul \([a,b]\), și notăm \(U\sim\Unif(a,b)\) (sau \(U\sim\Unif([a,b])\)), dacă are densitatea \[
f(x)=\begin{cases}\dfrac{1}{b-a}, & a\le x\le b,\\[2mm] 0, & \text{altfel,}\end{cases}
\qquad\text{adică}\qquad f(x)=\frac{1}{b-a}\Ind_{[a,b]}(x).
\]
Deoarece punctele au probabilitate zero, este indiferent dacă intervalul se consideră închis sau deschis: \(\Unif([a,b])\) și \(\Unif((a,b))\) desemnează aceeași repartiție.
Propoziția 2(Funcția de repartiție a lui U(a,b))
Dacă \(U\sim\Unif(a,b)\), atunci \[
F(x)=\int_{-\infty}^x f(t)\dd t=\begin{cases}0, & x<a,\\[1mm] \dfrac{x-a}{b-a}, & a\le x\le b,\\[2mm] 1, & x>b.\end{cases}
\] În plus, pentru orice subinterval \((c,d)\subseteq(a,b)\), \[
\PP\big(U\in(c,d)\big)=\int_c^d\frac{1}{b-a}\dd x=\frac{d-c}{b-a},
\] adică probabilitatea ca \(U\) să se afle într-un subinterval este proporțională cu lungimea subintervalului (și nu depinde de poziția lui).
Demonstrație. Dacă \(x<a\), densitatea este nulă pe \((-\infty,x]\), deci \(F(x)=0\). Dacă \(a\le x\le b\), \(F(x)=\int_a^x\frac{1}{b-a}\dd t=\frac{x-a}{b-a}\). Dacă \(x>b\), \(F(x)=\int_a^b\frac{1}{b-a}\dd t=1\). A doua afirmație se obține la fel.■
Arată codul R
a <-1; b <-4fu <-function(x) dunif(x, a, b)p1 <-plot_densitate_arie(fu, 2, 2.75, xlim =c(0, 5), n =2001, titlu ="Densitatea") +scale_y_continuous(limits =c(0, 0.45)) +scale_x_continuous(breaks =c(0, a, 2, 2.75, b, 5), labels =c("0", "a", "c", "d", "b", "5"))p2 <-ggplot(data.frame(x =seq(0, 5, length.out =401)), aes(x, punif(x, a, b))) +geom_line() +scale_x_continuous(breaks =c(0, a, b, 5), labels =c("0", "a", "b", "5")) +labs(title ="Funcția de repartiție", x ="x", y ="F(x)")p1 + p2
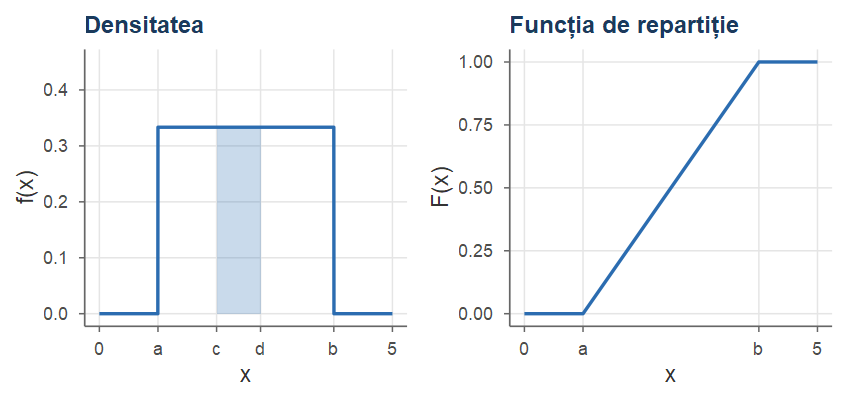
Figura 1: Repartiția \(\Unif(a,b)\) pentru \(a=1\), \(b=4\). Stânga: densitatea, cu \(\PP(c\le U\le d)\) hașurată pentru \(c=2\), \(d=2.75\) (aria \(0.25\)). Dreapta: funcția de repartiție, liniară pe \([a,b]\).
Cazul particular \(a=0\), \(b=1\) este cel mai important: dacă \(U\sim\Unif(0,1)\), atunci \(f_U(x)=\Ind_{[0,1]}(x)\) și \(F_U(x)=x\) pentru \(x\in[0,1]\). Aceasta este repartiția produsă de generatoarele de numere aleatoare ale calculatoarelor (funcția runif în R). Orice repartiție uniformă se obține din \(\Unif(0,1)\) printr-o transformare de locație și scală.
Propoziția 3(Legătura dintre U(0,1) și U(a,b))
Dacă \(U\sim\Unif(0,1)\) și \(a<b\), atunci \(V=a+(b-a)U\sim\Unif(a,b)\). Reciproc, dacă \(V\sim\Unif(a,b)\), atunci \(\dfrac{V-a}{b-a}\sim\Unif(0,1)\).
Demonstrație. Pentru \(x\in[a,b]\), deoarece \(b-a>0\), \[
F_V(x)=\PP\big(a+(b-a)U\le x\big)=\PP\Big(U\le\frac{x-a}{b-a}\Big)=F_U\Big(\frac{x-a}{b-a}\Big)=\frac{x-a}{b-a},
\] căci \(\frac{x-a}{b-a}\in[0,1]\). Pentru \(x<a\) argumentul lui \(F_U\) este negativ, deci \(F_V(x)=0\), iar pentru \(x>b\) este mai mare decât \(1\), deci \(F_V(x)=1\). Așadar \(V\) are funcția de repartiție din Propoziția 2. Reciproca se demonstrează analog.■
Transformarea \(u\mapsto a+(b-a)u\) este compusă dintr-o scalare (înmulțirea cu \(b-a\), care „întinde” intervalul \([0,1]\) la lungimea \(b-a\)) și o translație (adunarea lui \(a\)). Acest tip de transformare, \(x\mapsto\mu+\sigma x\), se numește transformare de locație și scală și îl vom reîntâlni la repartiția normală.
2.2 Media și varianța
Propoziția 4(Media și varianța repartiției uniforme)
Dacă \(V\sim\Unif(a,b)\), atunci \[
\E[V]=\frac{a+b}{2},\qquad \Var(V)=\frac{(b-a)^2}{12}.
\]
Demonstrație.Calcul direct. Avem \[
\E[V]=\int_{-\infty}^{+\infty}x\,\frac{1}{b-a}\Ind_{[a,b]}(x)\dd x=\frac{1}{b-a}\cdot\frac{x^2}{2}\Big|_a^b=\frac{b^2-a^2}{2(b-a)}=\frac{a+b}{2}
\] și \[
\E[V^2]=\frac{1}{b-a}\int_a^b x^2\dd x=\frac{b^3-a^3}{3(b-a)}=\frac{a^2+ab+b^2}{3},
\] deci \[
\Var(V)=\frac{a^2+ab+b^2}{3}-\frac{(a+b)^2}{4}=\frac{4a^2+4ab+4b^2-3a^2-6ab-3b^2}{12}=\frac{(b-a)^2}{12}.
\]
Prin transformare. Pentru \(U\sim\Unif(0,1)\), \(\E[U]=\int_0^1x\dd x=\frac12\) și \(\Var(U)=\int_0^1x^2\dd x-\frac14=\frac13-\frac14=\frac1{12}\). Cum \(V\) are aceeași repartiție ca \(a+(b-a)U\) (Propoziția 3), \(\E[V]=a+(b-a)\E[U]=a+\frac{b-a}{2}=\frac{a+b}{2}\) și \(\Var(V)=(b-a)^2\Var(U)=\frac{(b-a)^2}{12}\).■
Media este mijlocul intervalului, cum era de așteptat din simetria densității, iar varianța depinde doar de lungimea intervalului, nu și de poziția lui. Momentele de ordin superior se calculează la fel de ușor: \(\E[U^k]=\int_0^1x^k\dd x=\frac{1}{k+1}\) pentru \(U\sim\Unif(0,1)\) și, în general, \(\E[V^k]=\dfrac{b^{k+1}-a^{k+1}}{(k+1)(b-a)}\) pentru \(V\sim\Unif(a,b)\).
Exemplul 1(Așteptarea în stație)
Din stație pleacă un autobuz la fiecare \(15\) minute, începând cu ora \(7{:}00\). Un călător ajunge în stație la un moment repartizat uniform între \(7{:}00\) și \(7{:}30\). Care este probabilitatea ca el să aștepte a) mai puțin de \(5\) minute; b) mai mult de \(10\) minute?
Fie \(X\sim\Unif(0,30)\) numărul de minute după ora \(7{:}00\) la care ajunge călătorul. a) Călătorul așteaptă mai puțin de \(5\) minute dacă ajunge în intervalul \((10,15)\) sau \((25,30)\), deci probabilitatea este \(\PP(10<X<15)+\PP(25<X<30)=\frac{5}{30}+\frac{5}{30}=\frac13 .\) b) Așteaptă mai mult de \(10\) minute dacă ajunge în \((0,5)\) sau \((15,20)\): probabilitatea este tot \(\frac{10}{30}=\frac13\).
În R, funcțiile asociate repartiției uniforme sunt dunif (densitatea), punif (funcția de repartiție), qunif (funcția cuantilă) și runif (generarea de valori aleatoare), cu argumentele min\(=a\) și max\(=b\). Aceeași convenție de denumire (prefixele d, p, q, r) se aplică tuturor repartițiilor din R.
punif(0.3, min =0, max =2) # P(U <= 0.3) pentru U ~ U(0, 2)#> [1] 0.15qunif(0.9, min =0, max =2) # cuantila de ordin 0.9#> [1] 1.8set.seed(1); v <-1+3*runif(1e5) # V = a + (b - a) U ~ U(1, 4)c(medie =mean(v), teor =5/2, var =var(v), teor =9/12)#> medie teor var teor #> 2.499 2.500 0.754 0.750
3 Universalitatea repartiției uniforme
Rezultatul următor arată că, pornind de la o singură variabilă \(\Unif(0,1)\), putem construi o variabilă cu orice funcție de repartiție dorită și, invers, că orice variabilă continuă poate fi transformată într-o variabilă uniformă. Este principiul pe care se bazează majoritatea algoritmilor de simulare.
Teorema 5(Universalitatea repartiției uniforme)
Fie \(X\) o variabilă aleatoare a cărei funcție de repartiție \(F\) este continuă și strict crescătoare (deci bijectivă de la suportul lui \(X\) la \((0,1)\)). Atunci:
dacă \(U\sim\Unif(0,1)\), variabila \(F^{-1}(U)\) are aceeași repartiție ca \(X\);
\(F(X)\sim\Unif(0,1)\).
Demonstrație.
Cum \(F\) este continuă și strict crescătoare, există inversa \(F^{-1}\), tot strict crescătoare. Fie \(Y=F^{-1}(U)\). Aplicând funcția crescătoare \(F\) ambilor membri ai inegalității, evenimentele \(\{F^{-1}(U)\le x\}\) și \(\{U\le F(x)\}\) coincid, deci \[
\PP(Y\le x)=\PP\big(F^{-1}(U)\le x\big)=\PP\big(U\le F(x)\big)=F(x),
\] deoarece \(F(x)\in[0,1]\) și \(F_U(u)=u\) pe \([0,1]\). Astfel \(F^{-1}(U)\) și \(X\) au aceeași funcție de repartiție.
Fie \(Y=F(X)\); cum \(F:\R\to[0,1]\), avem \(Y\in[0,1]\). Pentru \(y\in(0,1)\), aplicând funcția crescătoare \(F^{-1}\), \[
\PP(Y\le y)=\PP\big(F(X)\le y\big)=\PP\big(X\le F^{-1}(y)\big)=F\big(F^{-1}(y)\big)=y .
\] Pentru \(y<0\) avem \(\PP(Y\le y)=0\), iar pentru \(y>1\), \(\PP(Y\le y)=1\). Deci \(Y\) are funcția de repartiție a lui \(\Unif(0,1)\).
■
Observație
Rezultatul teoremei de universalitate rămâne valabil în general (pentru orice funcție de repartiție \(F\), inclusiv pentru variabile discrete) dacă în locul inversei folosim funcția cuantilă definită în Cursul 4, \[
F^{-1}(u)=\inf\{x\in\R : F(x)\ge u\},\qquad u\in(0,1).
\] Dacă \(F\) este continuă și strict crescătoare, \(F^{-1}\) este chiar inversa lui \(F\). Partea b) necesită însă continuitatea lui \(F\): pentru o variabilă discretă, \(F(X)\) ia doar un număr cel mult numărabil de valori și nu poate fi uniformă.
Partea a) a teoremei conduce la metoda inversei (sau metoda transformării inverse) pentru simulare. Pentru a genera \(n\) observații dintr-o repartiție cu funcția de repartiție \(F\):
generăm \(u_1,\dots,u_n\) din \(\Unif(0,1)\) (în R: runif(n));
calculăm \(x_i=F^{-1}(u_i)\), \(i=1,\dots,n\).
Valorile \(x_1,\dots,x_n\) sunt observații din repartiția dorită; histograma lor aproximează densitatea \(f=F'\).
Exemplul 2(Simularea repartiției logistice)
În Exemplul 3 din Cursul 4 am arătat că densitatea logistică \(f(x)=\frac{e^x}{(1+e^x)^2}\) are funcția de repartiție \(F(x)=\frac{e^x}{1+e^x}\), \(x\in\R\), continuă și strict crescătoare. Rezolvăm ecuația \(F(x)=u\), cu \(u\in(0,1)\): \[
\frac{e^x}{1+e^x}=u\iff e^x=u+ue^x\iff e^x=\frac{u}{1-u}\iff x=\ln\frac{u}{1-u}.
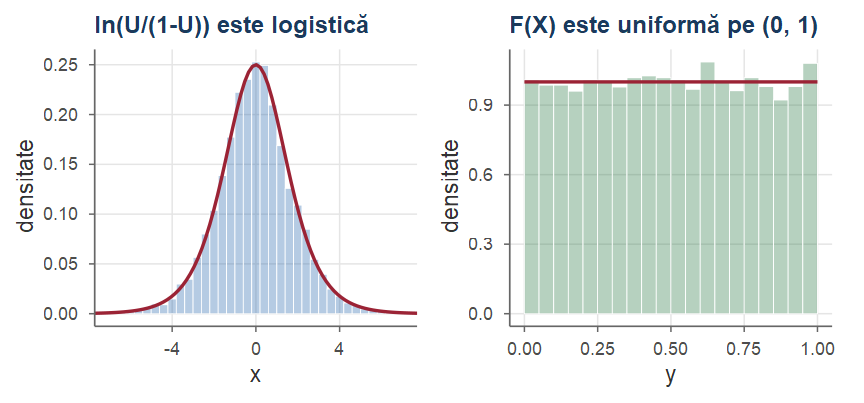
\] Deci \(F^{-1}(u)=\ln\frac{u}{1-u}\), iar dacă \(U\sim\Unif(0,1)\), variabila \(\ln\frac{U}{1-U}\) are repartiție logistică. Pentru a simula \(n\) observații logistice, generăm \(n\) observații uniforme și le aplicăm funcția \(u\mapsto\ln\frac{u}{1-u}\) (panoul din stânga al Figura 2).
set.seed(7)xe <-rexp(10000, 1)q1 <-ggplot(data.frame(x = x), aes(x)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.4, fill = culori[["albastru"]],alpha =0.35, colour ="white", linewidth =0.2) +stat_function(fun = dlogis, colour = culori[["rosu"]], linewidth =0.8) +coord_cartesian(xlim =c(-7, 7)) +labs(title ="ln(U/(1-U)) este logistică", x ="x", y ="densitate")q2 <-ggplot(data.frame(y =1-exp(-xe)), aes(y)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.05, boundary =0,fill = culori[["verde"]], alpha =0.35, colour ="white", linewidth =0.2) +annotate("segment", x =0, xend =1, y =1, yend =1, colour = culori[["rosu"]], linewidth =0.8) +labs(title ="F(X) este uniformă pe (0, 1)", x ="y", y ="densitate")q1 + q2
Figura 2: Cele două direcții ale teoremei de universalitate. Stânga: histograma valorilor \(\ln\frac{U}{1-U}\), \(U\sim\Unif(0,1)\), și densitatea logistică. Dreapta: histograma valorilor \(F(X)=1-e^{-X}\) pentru \(10000\) de observații \(X\) cu densitatea \(e^{-x}\), \(x>0\), și densitatea \(\Unif(0,1)\).
Metoda inversei funcționează și pentru variabile discrete, folosind funcția cuantilă.
Exemplul 3(Simularea unei variabile Bernoulli)
Fie \(X\sim\Bern(p)\), cu \(\PP(X=1)=p\) și \(\PP(X=0)=1-p\). Funcția de repartiție este \(F(x)=0\) pentru \(x<0\), \(F(x)=1-p\) pentru \(0\le x<1\) și \(F(x)=1\) pentru \(x\ge1\). Funcția cuantilă \(F^{-1}(u)=\inf\{x: F(x)\ge u\}\) este \[
F^{-1}(u)=\begin{cases}0, & 0<u\le 1-p,\\ 1, & 1-p<u<1.\end{cases}
\] Așadar \(F^{-1}(U)=1\) exact când \(U>1-p\). Cum și \(1-U\sim\Unif(0,1)\), putem folosi echivalent regula: generăm \(U\sim\Unif(0,1)\); dacă \(U<p\), punem \(X=1\), altfel \(X=0\). Aceasta este exact intuiția „aruncării unei monede” cu probabilitatea de succes \(p\).
Mai general, dacă \(X\) ia valorile \(x_1<x_2<\dots<x_m\) cu probabilitățile \(p_1,\dots,p_m\), atunci \(F^{-1}(U)=x_k\) exact când \(p_1+\dots+p_{k-1}<U\le p_1+\dots+p_k\): împărțim intervalul \((0,1)\) în subintervale consecutive de lungimi \(p_1,\dots,p_m\) și returnăm \(x_k\) dacă \(U\) cade în al \(k\)-lea subinterval.
O variabilă aleatoare \(X\) are repartiție exponențială de parametru \(\lambda>0\), și notăm \(X\sim\Exp(\lambda)\), dacă densitatea ei este \[
f(x)=\lambda e^{-\lambda x}\,\Ind_{(0,\infty)}(x)=\begin{cases}\lambda e^{-\lambda x}, & x>0,\\ 0, & x\le0.\end{cases}
\] Parametrul \(\lambda\) se numește rata (sau intensitatea) repartiției.
Funcția \(f\) este într-adevăr o densitate: \(f\ge0\) și \(\int_0^\infty\lambda e^{-\lambda x}\dd x=\big(-e^{-\lambda x}\big)\big|_0^\infty=0-(-1)=1\). Repartiția exponențială modelează timpul de așteptare până la producerea unui eveniment: durata de viață a unei componente electronice, timpul până la sosirea următorului client, durata unei convorbiri, timpul până la dezintegrarea unui atom radioactiv.
Propoziția 7(Funcția de repartiție a lui Exp(λ))
Dacă \(X\sim\Exp(\lambda)\), atunci \[
F(x)=\begin{cases}0, & x\le0,\\ 1-e^{-\lambda x}, & x>0,\end{cases}
\qquad\text{și}\qquad \PP(X>a)=e^{-\lambda a},\quad a\ge0 .
\]
Demonstrație. Pentru \(x>0\), \(F(x)=\int_{-\infty}^x\lambda e^{-\lambda t}\Ind_{(0,\infty)}(t)\dd t=\int_0^x\lambda e^{-\lambda t}\dd t=\big(-e^{-\lambda t}\big)\big|_0^x=1-e^{-\lambda x}\), iar pentru \(x\le0\), \(F(x)=0\). Apoi \(\PP(X>a)=1-F(a)=e^{-\lambda a}\).■
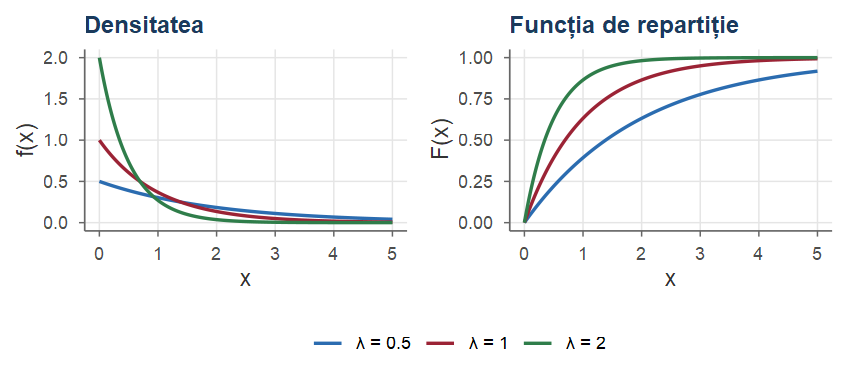
Funcția \(a\mapsto\PP(X>a)=e^{-\lambda a}\) este probabilitatea de supraviețuire: probabilitatea ca \(X\) să depășească pragul \(a\) scade exponențial. Cu cât \(\lambda\) este mai mare, cu atât scăderea este mai rapidă și valorile lui \(X\) sunt mai mici (Figura 3).
Arată codul R
xx <-seq(0, 5, length.out =400)de <-do.call(rbind, lapply(c(0.5, 1, 2), function(l)data.frame(x = xx, f =dexp(xx, l), F =pexp(xx, l), lambda =paste0("λ = ", l))))e1 <-ggplot(de, aes(x, f, colour = lambda)) +geom_line() +labs(title ="Densitatea", x ="x", y ="f(x)", colour =NULL)e2 <-ggplot(de, aes(x, F, colour = lambda)) +geom_line() +labs(title ="Funcția de repartiție", x ="x", y ="F(x)", colour =NULL)e1 + e2 +plot_layout(guides ="collect")
Figura 3: Densitatea (stânga) și funcția de repartiție (dreapta) repartiției \(\Exp(\lambda)\) pentru \(\lambda\in\{0.5,1,2\}\). Cu cât rata \(\lambda\) este mai mare, cu atât masa de probabilitate este mai concentrată lângă \(0\).
Propoziția 8(Media și varianța repartiției exponențiale)
Dacă \(X\sim\Exp(\lambda)\), atunci \[
\E[X]=\frac1\lambda,\qquad \Var(X)=\frac{1}{\lambda^2}.
\]
Demonstrație. Integrăm prin părți, folosind \(\lambda e^{-\lambda x}=\big(-e^{-\lambda x}\big)'\) și faptul că \(x^ke^{-\lambda x}\to0\) când \(x\to\infty\): \[
\E[X]=\int_0^\infty x\,\lambda e^{-\lambda x}\dd x=\int_0^\infty x\big(-e^{-\lambda x}\big)'\dd x=\big(-xe^{-\lambda x}\big)\Big|_0^\infty+\int_0^\infty e^{-\lambda x}\dd x=0+\frac1\lambda .
\] Analog, \[
\begin{aligned}
\E[X^2]&=\int_0^\infty x^2\big(-e^{-\lambda x}\big)'\dd x=\big(-x^2e^{-\lambda x}\big)\Big|_0^\infty+\int_0^\infty 2xe^{-\lambda x}\dd x\\
&=\frac2\lambda\int_0^\infty x\,\lambda e^{-\lambda x}\dd x=\frac{2}{\lambda}\E[X]=\frac{2}{\lambda^2},
\end{aligned}
\] deci \(\Var(X)=\frac{2}{\lambda^2}-\frac{1}{\lambda^2}=\frac{1}{\lambda^2}\).■
Astfel, dacă \(\lambda\) este numărul mediu de evenimente pe unitatea de timp (rata), atunci \(1/\lambda\) este timpul mediu de așteptare. Mediana repartiției este soluția ecuației \(1-e^{-\lambda x}=1/2\), adică \(x_{1/2}=\frac{\ln2}{\lambda}\approx\frac{0.693}{\lambda}\), mai mică decât media \(1/\lambda\) (densitatea are o coadă lungă spre dreapta).
Observație
Dacă \(X\sim\Exp(\lambda)\) și \(c>0\), atunci \(cX\sim\Exp(\lambda/c)\), deoarece \(\PP(cX>x)=\PP(X>x/c)=e^{-(\lambda/c)x}\). În particular \(\lambda X\sim\Exp(1)\): toate repartițiile exponențiale se obțin din \(\Exp(1)\) prin schimbarea unității de măsură a timpului.
4.2 Simularea prin metoda inversei
Pe \((0,\infty)\) funcția \(F(x)=1-e^{-\lambda x}\) este continuă și strict crescătoare, cu valori în \((0,1)\). Rezolvând \(1-e^{-\lambda x}=u\) obținem \(e^{-\lambda x}=1-u\), adică \[
F^{-1}(u)=-\frac{\ln(1-u)}{\lambda},\qquad u\in(0,1).
\] Conform Teoremei 5, dacă \(U\sim\Unif(0,1)\), atunci \(-\frac{1}{\lambda}\ln(1-U)\sim\Exp(\lambda)\). Cum și \(1-U\sim\Unif(0,1)\), rezultă și \[
X=-\frac{\ln U}{\lambda}\sim\Exp(\lambda).
\]
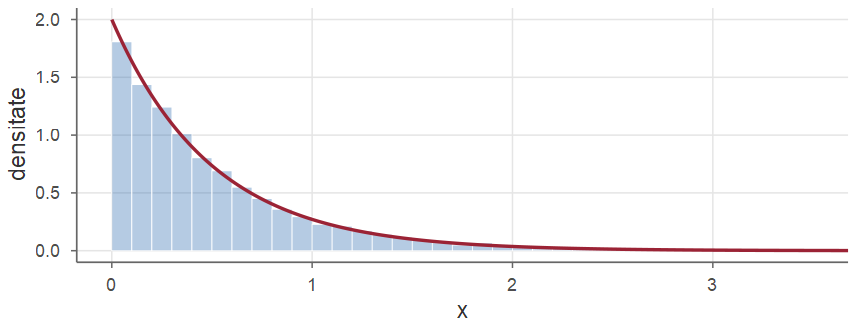
Figura 4: Metoda inversei: histograma a \(10000\) de valori \(-\ln(U)/2\), cu \(U\sim\Unif(0,1)\), și densitatea exactă a repartiției \(\Exp(2)\).
4.3 Proprietatea lipsei de memorie
Definiția 9(Proprietatea lipsei de memorie)
Spunem că o variabilă aleatoare \(X\ge0\), cu \(\PP(X>t)>0\) pentru orice \(t\ge0\), are proprietatea lipsei de memorie dacă \[
\PP(X>s+t\mid X>s)=\PP(X>t),\qquad\text{pentru orice } s,t\ge0 .
\tag{1}\]
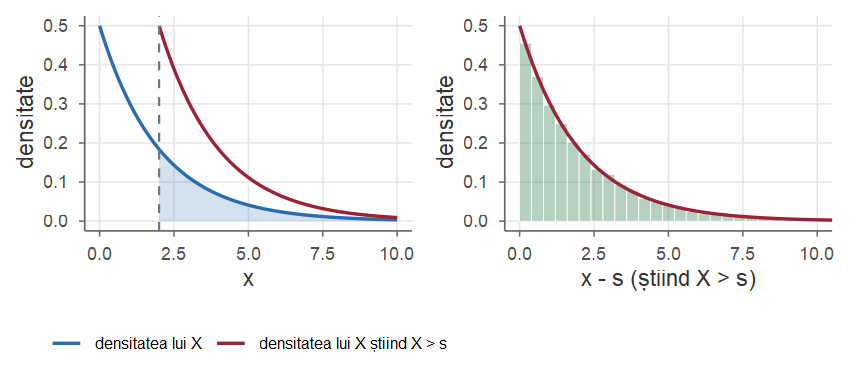
Dacă \(X\) este durata de viață a unei componente, relația (1) spune că probabilitatea ca o componentă care a funcționat deja \(s\) ore să mai funcționeze încă cel puțin \(t\) ore este aceeași cu probabilitatea ca o componentă nouă să funcționeze cel puțin \(t\) ore. Componenta „nu îmbătrânește”: vârsta ei nu contează, ea nu își „amintește” cât timp a funcționat. Echivalent, repartiția duratei de viață reziduale \(X-s\), condiționat de \(\{X>s\}\), este aceeași cu repartiția lui \(X\).
Teorema 10(Lipsa de memorie caracterizează repartiția exponențială)
Dacă \(X\sim\Exp(\lambda)\), atunci \(X\) are proprietatea lipsei de memorie.
Reciproc, dacă \(X\ge0\) este o variabilă aleatoare continuă cu proprietatea lipsei de memorie, atunci există \(\lambda>0\) astfel încât \(X\sim\Exp(\lambda)\).
Demonstrație.
Cum \(s+t\ge s\), avem \(\{X>s+t\}\subseteq\{X>s\}\), deci \(\{X>s+t\}\cap\{X>s\}=\{X>s+t\}\) și \[
\begin{aligned}
\PP(X>s+t\mid X>s)&=\frac{\PP(X>s+t,\,X>s)}{\PP(X>s)}=\frac{\PP(X>s+t)}{\PP(X>s)}=\frac{1-F(s+t)}{1-F(s)}\\
&=\frac{e^{-\lambda(s+t)}}{e^{-\lambda s}}=e^{-\lambda t}=\PP(X>t).
\end{aligned}
\]
Fie \(G(t)=\PP(X>t)=1-F(t)\), \(t\ge0\), funcția de supraviețuire; \(G\) este continuă (căci \(X\) este continuă), descrescătoare, \(G(0)=1\), \(G(t)>0\) și \(G(t)\to0\) când \(t\to\infty\). Relația (1) se scrie \(G(s+t)/G(s)=G(t)\), adică \[
G(s+t)=G(s)\,G(t),\qquad s,t\ge0 .
\] Aceasta este (varianta multiplicativă a) ecuației funcționale a lui Cauchy. Aplicând-o repetat, \(G(nt)=G(t)^n\) pentru orice \(n\in\N\) și \(t\ge0\). Luând \(t=1/n\) obținem \(G(1)=G(1/n)^n\), deci \(G(1/n)=G(1)^{1/n}\) și apoi \(G(m/n)=G(1/n)^m=G(1)^{m/n}\) pentru orice \(m,n\in\N\), \(n\ge1\). Notăm \(\lambda=-\ln G(1)\). Avem \(0<G(1)<1\): \(G(1)>0\) prin ipoteză, iar dacă \(G(1)=1\) ar rezulta \(G(m)=1\) pentru orice \(m\), în contradicție cu \(G(m)\to0\). Deci \(\lambda\in(0,\infty)\) și \[
G(q)=e^{-\lambda q}\qquad\text{pentru orice } q\ge0 \text{ rațional.}
\] Pentru \(t\ge0\) oarecare, alegem un șir de raționali \(q_k\to t\); din continuitatea lui \(G\), \(G(t)=\lim_k e^{-\lambda q_k}=e^{-\lambda t}\). Așadar \(\PP(X>t)=e^{-\lambda t}\), adică \(X\sim\Exp(\lambda)\).
■
Arată codul R
lam <-0.5; s <-2xx <-seq(0, 10, length.out =500)dm <-rbind(data.frame(x = xx, y =dexp(xx, lam), tip ="densitatea lui X"),data.frame(x = xx, y =ifelse(xx > s, dexp(xx - s, lam), NA),tip ="densitatea lui X știind X > s"))m1 <-ggplot(dm, aes(x, y, colour = tip)) +geom_area(data =subset(dm, tip =="densitatea lui X"& x >= s), aes(x, y),fill = culori[["albastru"]], alpha =0.2, inherit.aes =FALSE) +geom_line(na.rm =TRUE) +geom_vline(xintercept = s, linetype =2, colour = culori[["gri"]]) +scale_colour_manual(values =unname(culori[c("albastru", "rosu")])) +labs(x ="x", y ="densitate", colour =NULL) +theme(legend.position ="bottom", legend.text =element_text(size =8))set.seed(11)xm <-rexp(40000, lam); rest <- xm[xm > s] - sm2 <-ggplot(data.frame(r = rest), aes(r)) +geom_histogram(aes(y =after_stat(density)), binwidth =0.4, boundary =0,fill = culori[["verde"]], alpha =0.35, colour ="white", linewidth =0.2) +stat_function(fun =function(t) dexp(t, lam), colour = culori[["rosu"]], linewidth =0.8) +coord_cartesian(xlim =c(0, 10)) +labs(x ="x - s (știind X > s)", y ="densitate")m1 + m2
Figura 5: Lipsa de memorie pentru \(X\sim\Exp(0.5)\) și \(s=2\). Stânga: densitatea lui \(X\) (albastru) și densitatea condiționată a lui \(X\) știind \(X>s\) (roșu), care este densitatea lui \(X\) translatată cu \(s\). Dreapta: histograma valorilor \(X-s\) pentru observațiile simulate cu \(X>s\) coincide cu densitatea \(\Exp(0.5)\).
Exemplul 4(Durata de viață a unui bec)
Durata de funcționare (în ore) a unui bec este repartizată exponențial, cu media de \(1000\) de ore, deci \(\lambda=1/1000\).
Probabilitatea ca becul să funcționeze mai mult de \(1500\) de ore este \(\PP(X>1500)=e^{-1.5}\approx0.2231\).
Știind că becul a funcționat deja \(1000\) de ore, probabilitatea ca el să mai funcționeze cel puțin încă \(500\) de ore este, conform lipsei de memorie, \(\PP(X>1500\mid X>1000)=\PP(X>500)=e^{-0.5}\approx0.6065\).
Jumătate dintre becuri se ard înainte de mediana \(x_{1/2}=1000\ln2\approx693.1\) ore, deși durata medie este de \(1000\) de ore.
Observație
Proprietatea lipsei de memorie este o idealizare. Ea este rezonabilă pentru componente care se defectează din cauze „accidentale” (șocuri externe), dar nu pentru sisteme care se uzează: un motor vechi are, de regulă, o probabilitate mai mare de a se defecta în ora următoare decât unul nou (compară cu Exercițiul 8 din Cursul 4, unde așteptarea anterioară mărește șansa unei sosiri iminente). Printre repartițiile discrete pe \(\{1,2,\dots\}\), proprietatea lipsei de memorie caracterizează repartiția geometrică; repartiția exponențială este analogul ei continuu (vezi și Exercițiul 4).
4.4 Legătura cu procesul Poisson
Să presupunem că anumite evenimente (apeluri la un centru telefonic, sosiri de clienți, dezintegrări radioactive) se produc aleator în timp, astfel încât numărul \(N(t)\) de evenimente din intervalul \([0,t]\) are repartiția \(\Pois(\lambda t)\), unde \(\lambda>0\) este numărul mediu de evenimente pe unitatea de timp. (Modelul, numit proces Poisson, presupune în plus că numerele de evenimente din intervale disjuncte sunt independente.) Fie \(T\) momentul producerii primului eveniment. Atunci \(T>t\) dacă și numai dacă în \([0,t]\) nu s-a produs niciun eveniment, deci \[
\PP(T>t)=\PP\big(N(t)=0\big)=e^{-\lambda t}\frac{(\lambda t)^0}{0!}=e^{-\lambda t},\qquad t\ge0 .
\] Prin urmare \(T\sim\Exp(\lambda)\): într-un proces Poisson de rată \(\lambda\), timpul de așteptare până la primul eveniment este exponențial de parametru \(\lambda\). Se poate arăta că și timpii dintre evenimente consecutive sunt independenți și \(\Exp(\lambda)\); lipsa de memorie reflectă faptul că procesul „o ia de la capăt” în orice moment.
Exemplul 5(Apeluri la un centru telefonic)
La un centru telefonic sosesc în medie \(3\) apeluri pe oră, conform unui proces Poisson. Probabilitatea ca în următoarea jumătate de oră să nu sosească niciun apel este \(\PP(T>0.5)=e^{-3\cdot0.5}=e^{-1.5}\approx0.2231\), iar timpul mediu de așteptare până la primul apel este \(1/3\) oră, adică \(20\) de minute.
De unde provine, de fapt, repartiția exponențială? Un calculator nu „vede” timpul continuu, ci o succesiune de tacte de ceas. Împărțim deci unitatea de timp în \(n\) tacte de lungime \(1/n\) și presupunem că în fiecare tact se produce un eveniment cu probabilitatea \(\lambda/n\), independent de celelalte tacte (în medie, \(\lambda\) evenimente pe unitatea de timp). Am întâlnit acest șir de probe Bernoulli în Cursul 3: numărul de evenimente din \([0,t]\) este binomial, aproximativ \(\Pois(\lambda t)\) pentru \(n\) mare (Teorema 17 din Cursul 3), iar numărul \(K_n\) al tactului în care se produce primul eveniment este \(\Geom(\lambda/n)\) (Definiția 13 din Cursul 3). Timpul de așteptare până la primul eveniment este deci \(T_n=K_n/n\); când tactele devin din ce în ce mai scurte, el devine exponențial; pentru detalii, vezi (Chan 2021, sec. 4.5.3).
Propoziția 11(Repartiția exponențială ca limită a repartiției geometrice)
Fie \(\lambda>0\) și, pentru \(n>\lambda\), fie \(K_n\sim\Geom(\lambda/n)\) și \(T_n=K_n/n\). Atunci, pentru orice \(t\ge0\), \[
\lim_{n\to\infty}\PP(T_n>t)=e^{-\lambda t}=\PP(T>t),\qquad\text{unde } T\sim\Exp(\lambda).
\]
Demonstrație. Cum \(K_n\) ia valori întregi, \(\{T_n>t\}=\{K_n>nt\}=\{K_n>\lfloor nt\rfloor\}\): primele \(\lfloor nt\rfloor\) tacte nu aduc niciun eveniment. Prin urmare \[
\PP(T_n>t)=\Big(1-\frac\lambda n\Big)^{\lfloor nt\rfloor}=\Big[\Big(1-\frac\lambda n\Big)^{n}\Big]^{\lfloor nt\rfloor/n}\xrightarrow[n\to\infty]{}\big(e^{-\lambda}\big)^{t}=e^{-\lambda t},
\] deoarece \(\big(1-\frac\lambda n\big)^n\to e^{-\lambda}\), iar din \(nt-1<\lfloor nt\rfloor\le nt\) rezultă \(\lfloor nt\rfloor/n\to t\).■
Exercițiul 4 parcurge drumul invers (discretizarea unei variabile exponențiale produce o variabilă geometrică), iar lipsa de memorie a repartiției exponențiale este moștenită de la repartiția geometrică (Propoziția 14 din Cursul 3). Simulăm modelul cu tacte pentru centrul telefonic din Exemplul 5: \(\lambda=3\) apeluri pe oră și \(n=1000\) de tacte pe oră.
set.seed(2026)lambda <-3; n <-1000; ore <-4000# 1000 de tacte pe oră, 4000 de oretact <-which(rbinom(ore * n, 1, lambda / n) ==1) # tactele cu apelastept <-diff(c(0, tact)) / n # timpii dintre apeluri, în orec(medie =mean(astept), P =mean(astept >0.5)) # Exp(3): 1/3 și exp(-1.5)#> medie P #> 0.3352 0.2206nr <-tabulate(ceiling(tact / n), nbins = ore) # apeluri în fiecare orăc(medie =mean(nr), varianta =var(nr)) # Pois(3): 3 și 3#> medie varianta #> 2.982 2.948
Același șir de probe Bernoulli produce ambele repartiții: timpii dintre apeluri se comportă ca o variabilă \(\Exp(3)\) (media \(\approx1/3\), \(\PP(T>0.5)\approx e^{-1.5}\approx0.2231\)), iar numărul de apeluri dintr-o oră ca o variabilă \(\Pois(3)\) (media și varianța \(\approx3\)).
5 Repartiția normală
Repartiția normală a apărut istoric ca aproximare a repartiției binomiale (de Moivre, 1733) și ca model pentru erorile de măsurare (Gauss, Laplace). Importanța ei excepțională provine din teorema limită centrală (Cursul 7): suma unui număr mare de variabile aleatoare independente, fiecare cu o contribuție mică, are o repartiție aproximativ normală. De aceea multe mărimi naturale (înălțimi, erori de măsură, note la examene cu mulți itemi) au histograme în formă de „clopot”.
Notă istorică
Curba „în formă de clopot” apare pentru prima dată la Abraham de Moivre (1733), ca limită a probabilităților binomiale. Carl Friedrich Gauss a folosit-o în 1809 în teoria erorilor de observație astronomică, iar Pierre-Simon Laplace a demonstrat primele versiuni generale ale teoremei limită centrale. Denumirea de repartiție „normală” s-a impus spre sfârșitul secolului al XIX-lea, iar în multe țări este numită repartiția lui Gauss.
5.1 Definiție; normala standard
Definiția 12(Repartiția normală)
Spunem că o variabilă aleatoare \(X\) este repartizată normal (sau gaussian) de parametri \(\mu\in\R\) și \(\sigma^2>0\), și notăm \(X\sim\Norm(\mu,\sigma^2)\), dacă admite densitatea \[
f(x)=\frac{1}{\sqrt{2\pi}\,\sigma}\,e^{-\frac{(x-\mu)^2}{2\sigma^2}},\qquad x\in\R .
\] În cazul particular \(\mu=0\), \(\sigma^2=1\), spunem că \(X\) este normală standard, \(X\sim\Norm(0,1)\). Densitatea normalei standard se notează cu \(\varphi\), iar funcția ei de repartiție cu \(\Phi\): \[
\varphi(x)=\frac{1}{\sqrt{2\pi}}e^{-x^2/2},\qquad \Phi(x)=\int_{-\infty}^x\varphi(t)\dd t=\int_{-\infty}^x\frac{1}{\sqrt{2\pi}}e^{-t^2/2}\dd t,\qquad x\in\R .
\]
Vom vedea imediat că \(\mu\) este media, iar \(\sigma^2\) varianța lui \(X\). Funcția \(\Phi\)nu are o formă compactă: primitiva lui \(e^{-x^2/2}\) nu se poate exprima prin funcții elementare. Valorile lui \(\Phi\) se calculează numeric (în R: pnorm) sau se citesc din tabele.
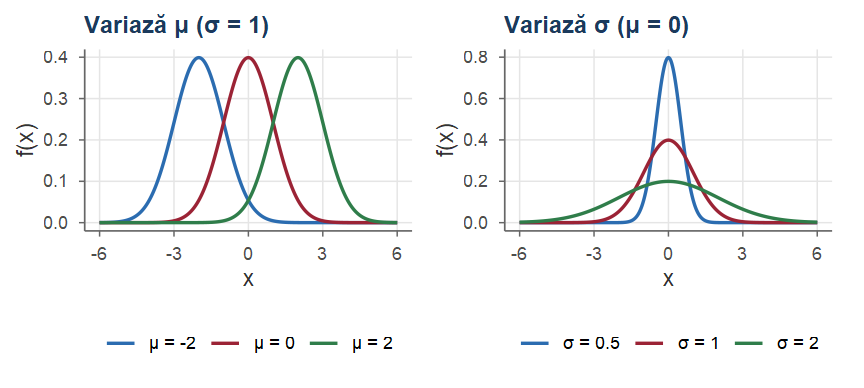
Densitatea \(\varphi\) este o funcție pară, \(\varphi(z)=\varphi(-z)\) pentru orice \(z\in\R\), deci graficul ei este simetric față de axa verticală; ea atinge maximul \(\varphi(0)=1/\sqrt{2\pi}\approx0.399\) în \(0\) și are puncte de inflexiune în \(\pm1\). Densitatea generală se obține din \(\varphi\) printr-o translație cu \(\mu\) și o scalare cu \(\sigma\): \(f(x)=\frac1\sigma\varphi\big(\frac{x-\mu}{\sigma}\big)\) (Figura 6).
Arată codul R
xx <-seq(-6, 6, length.out =500)dmu <-do.call(rbind, lapply(c(-2, 0, 2), function(m)data.frame(x = xx, y =dnorm(xx, m, 1), p =paste0("μ = ", m))))dsg <-do.call(rbind, lapply(c(0.5, 1, 2), function(s)data.frame(x = xx, y =dnorm(xx, 0, s), p =paste0("σ = ", s))))n1 <-ggplot(dmu, aes(x, y, colour = p)) +geom_line() +labs(title ="Variază μ (σ = 1)", x ="x", y ="f(x)", colour =NULL)n2 <-ggplot(dsg, aes(x, y, colour = p)) +geom_line() +labs(title ="Variază σ (μ = 0)", x ="x", y ="f(x)", colour =NULL)n1 + n2
Figura 6: Densități normale. Stânga: \(\sigma=1\) și \(\mu\in\{-2,0,2\}\) (\(\mu\) este parametru de locație: translatează graficul). Dreapta: \(\mu=0\) și \(\sigma\in\{0.5,1,2\}\) (\(\sigma\) este parametru de scală: aplatizează sau ascute graficul).
5.2 Integrala lui Gauss
Faptul că \(\varphi\) este o densitate nu este evident: trebuie arătat că \(\int_{-\infty}^{\infty}e^{-x^2/2}\dd x=\sqrt{2\pi}\). Demonstrația clasică trece prin coordonate polare, deci are nevoie de formula schimbării de variabilă în integrala dublă, pe care o reamintim.
Teorema 13(Schimbarea de variabilă în integrala multiplă)
Fie \(G\subseteq\R^n\) o mulțime deschisă și \(g=(g_1,\dots,g_n):G\to\R^n\) o funcție injectivă, cu derivate parțiale continue, al cărei determinant jacobian\(\det J_g(x)=\det\big(\frac{\partial g_i}{\partial x_j}(x)\big)_{1\le i,j\le n}\) este nenul pe \(G\). Atunci, pentru orice funcție \(f\) nenegativă sau integrabilă pe \(g(G)\), \[
\int_{g(G)}f(y)\dd y=\int_G f\big(g(x)\big)\,\big|\det J_g(x)\big|\dd x .
\]
Propoziția 14(Densitatea normală standard)
Funcția \(\varphi\) este o densitate de probabilitate: \(\varphi(x)>0\) pentru orice \(x\in\R\) și \[
\int_{-\infty}^{+\infty}e^{-x^2/2}\dd x=\sqrt{2\pi},\qquad\text{deci}\qquad\int_{-\infty}^{+\infty}\varphi(x)\dd x=1 .
\tag{2}\]
Demonstrație. Fie \(I=\int_{-\infty}^{+\infty}e^{-x^2/2}\dd x\) (integrala este convergentă, deoarece \(e^{-x^2/2}\le e^{1/2-|x|}\)). Scriem \(I^2\) ca produs a două integrale și aplicăm teorema lui Fubini: \[
I^2=\Big(\int_{-\infty}^{+\infty}e^{-x^2/2}\dd x\Big)\Big(\int_{-\infty}^{+\infty}e^{-y^2/2}\dd y\Big)=\iint_{\R^2}e^{-\frac{x^2+y^2}{2}}\dd x\dd y .
\] Trecem la coordonate polare, \(g(r,\theta)=(r\cos\theta,r\sin\theta)\), definită pe \(G=(0,\infty)\times(0,2\pi)\); \(g\) este injectivă și \(g(G)\) diferă de \(\R^2\) doar printr-o semidreaptă, de arie zero. Matricea jacobiană și determinantul ei sunt \[
J_g(r,\theta)=\begin{pmatrix}\frac{\partial g_1}{\partial r} & \frac{\partial g_1}{\partial\theta}\\[1mm] \frac{\partial g_2}{\partial r} & \frac{\partial g_2}{\partial\theta}\end{pmatrix}=\begin{pmatrix}\cos\theta & -r\sin\theta\\ \sin\theta & r\cos\theta\end{pmatrix},\qquad \det J_g(r,\theta)=r\cos^2\theta+r\sin^2\theta=r .
\] Intuitiv, dreptunghiul infinitezimal \(\dd x\dd y\) corespunde „sectorului” de arie \(r\dd r\dd\theta\). Cum \(x^2+y^2=r^2\), Teorema 13 dă \[
I^2=\int_0^{2\pi}\!\!\int_0^\infty e^{-r^2/2}\,r\dd r\dd\theta=2\pi\int_0^\infty re^{-r^2/2}\dd r=2\pi\Big(-e^{-r^2/2}\Big)\Big|_0^\infty=2\pi .
\] Cum \(I>0\), rezultă \(I=\sqrt{2\pi}\) și \(\int_{\R}\varphi=\frac{1}{\sqrt{2\pi}}\,I=1\).■
5.3 Simetrie, media și varianța normalei standard
Propoziția 15(Simetria funcției Φ)
Pentru orice \(z\in\R\), \[
\Phi(-z)=1-\Phi(z).
\] În consecință, dacă \(Z\sim\Norm(0,1)\), atunci și \(-Z\sim\Norm(0,1)\), iar pentru \(z>0\), \(\PP(|Z|\le z)=2\Phi(z)-1\).
Demonstrație. Cu schimbarea de variabilă \(u=-t\) și folosind paritatea lui \(\varphi\), \[
\Phi(-z)=\int_{-\infty}^{-z}\varphi(t)\dd t=\int_z^{\infty}\varphi(-u)\dd u=\int_z^\infty\varphi(u)\dd u=1-\int_{-\infty}^z\varphi(u)\dd u=1-\Phi(z).
\] Apoi \(\PP(-Z\le z)=\PP(Z\ge-z)=1-\Phi(-z)=\Phi(z)\), deci \(-Z\) are funcția de repartiție \(\Phi\). În fine, \(\PP(|Z|\le z)=\Phi(z)-\Phi(-z)=2\Phi(z)-1\).■
Datorită simetriei, tabelele lui \(\Phi\) conțin de obicei doar valorile pentru \(z\ge0\). Câteva valori care trebuie reținute: \(\Phi(0)=0.5\), \(\Phi(1)\approx0.8413\), \(\Phi(1.645)\approx0.95\), \(\Phi(1.96)\approx0.975\), \(\Phi(2)\approx0.9772\), \(\Phi(2.576)\approx0.995\).
Propoziția 16(Momentele normalei standard)
Dacă \(Z\sim\Norm(0,1)\), atunci \(\E[Z]=0\) și \(\Var(Z)=1\). Mai general, \(\E[Z^{n+1}]=n\,\E[Z^{n-1}]\) pentru \(n\ge1\), de unde \[
\E[Z^{2k+1}]=0,\qquad \E[Z^{2k}]=(2k-1)(2k-3)\cdots3\cdot1,\qquad k\ge1 .
\] În particular, \(\E[Z^3]=0\) și \(\E[Z^4]=3\).
Demonstrație. Toate momentele există, deoarece \(|z|^ne^{-z^2/2}\) este integrabilă pe \(\R\). Funcția \(z\mapsto z\varphi(z)\) este impară, deci \(\E[Z]=\int_{\R} z\varphi(z)\dd z=0\); la fel pentru toate momentele de ordin impar. Pentru recurență folosim \(\varphi'(z)=-z\varphi(z)\) și integrăm prin părți: \[
\begin{aligned}
\E[Z^{n+1}]&=\int_{-\infty}^{\infty}z^n\cdot z\varphi(z)\dd z=\int_{-\infty}^{\infty}z^n\big(-\varphi(z)\big)'\dd z\\
&=\big(-z^n\varphi(z)\big)\Big|_{-\infty}^{\infty}+n\int_{-\infty}^{\infty}z^{n-1}\varphi(z)\dd z=n\,\E[Z^{n-1}].
\end{aligned}
\] Pentru \(n=1\) obținem \(\E[Z^2]=1\cdot\E[Z^0]=1\), deci \(\Var(Z)=\E[Z^2]-(\E[Z])^2=1\). Pentru \(n=3\), \(\E[Z^4]=3\E[Z^2]=3\), și așa mai departe.■
5.4 Cazul general: standardizare
Propoziția 17(Locație și scală pentru repartiția normală)
Fie \(\mu\in\R\) și \(\sigma>0\).
Dacă \(Z\sim\Norm(0,1)\), atunci \(X=\mu+\sigma Z\sim\Norm(\mu,\sigma^2)\), iar \(\E[X]=\mu\) și \(\Var(X)=\sigma^2\).
Reciproc, dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci variabila standardizată\(Z=\dfrac{X-\mu}{\sigma}\sim\Norm(0,1)\).
Funcția de repartiție și densitatea lui \(X\sim\Norm(\mu,\sigma^2)\) sunt \[
F(x)=\Phi\Big(\frac{x-\mu}{\sigma}\Big),\qquad f(x)=\frac1\sigma\,\varphi\Big(\frac{x-\mu}{\sigma}\Big).
\]
Demonstrație. Fie \(X=\mu+\sigma Z\). Cum \(\sigma>0\), \[
F_X(x)=\PP(\mu+\sigma Z\le x)=\PP\Big(Z\le\frac{x-\mu}{\sigma}\Big)=\Phi\Big(\frac{x-\mu}{\sigma}\Big).
\] Derivând funcția compusă (regula \((h\circ u)'=h'(u)\,u'\)), \[
f_X(x)=\frac{\dd}{\dd x}\Phi\Big(\frac{x-\mu}{\sigma}\Big)=\varphi\Big(\frac{x-\mu}{\sigma}\Big)\cdot\frac1\sigma=\frac{1}{\sqrt{2\pi}\,\sigma}e^{-\frac{(x-\mu)^2}{2\sigma^2}},
\] care este densitatea \(\Norm(\mu,\sigma^2)\). Aceasta demonstrează a) și c); media și varianța rezultă din Propoziția 16: \(\E[X]=\mu+\sigma\E[Z]=\mu\), \(\Var(X)=\sigma^2\Var(Z)=\sigma^2\). Pentru b), dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci \(\PP\big(\frac{X-\mu}{\sigma}\le z\big)=\PP(X\le\mu+\sigma z)=F(\mu+\sigma z)=\Phi(z)\), conform c).■
Așadar orice variabilă normală se obține din normala standard printr-o scalare (cu \(\sigma\)) și o translație (cu \(\mu\)), iar orice calcul de probabilități pentru \(\Norm(\mu,\sigma^2)\) se reduce la \(\Phi\). Aceasta este procedura de standardizare: dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci \[
\PP(a\le X\le b)=\PP\Big(\frac{a-\mu}{\sigma}\le\frac{X-\mu}{\sigma}\le\frac{b-\mu}{\sigma}\Big)=\Phi\Big(\frac{b-\mu}{\sigma}\Big)-\Phi\Big(\frac{a-\mu}{\sigma}\Big).
\tag{3}\] Mai întâi translatăm în origine (scădem \(\mu\)), apoi scalăm la varianța \(1\) (împărțim la \(\sigma\)).
Corolarul 18(Transformări liniare ale variabilelor normale)
Dacă \(X\sim\Norm(\mu,\sigma^2)\) și \(a,b\in\R\), \(a\ne0\), atunci \[
aX+b\sim\Norm\big(a\mu+b,\ a^2\sigma^2\big).
\]
Demonstrație. Scriem \(X=\mu+\sigma Z\) cu \(Z\sim\Norm(0,1)\). Atunci \(aX+b=(a\mu+b)+a\sigma Z\). Dacă \(a>0\), concluzia rezultă din Propoziția 17 a) cu parametrul de scală \(a\sigma\). Dacă \(a<0\), scriem \(aX+b=(a\mu+b)+|a|\sigma(-Z)\) și folosim faptul că \(-Z\sim\Norm(0,1)\) (Propoziția 15).■
5.5 Regula 68–95–99.7
Teorema 19(Regula 68-95-99.7)
Dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci \[
\begin{aligned}
\PP(|X-\mu|\le\sigma)&=2\Phi(1)-1\approx0.6827,\\
\PP(|X-\mu|\le2\sigma)&=2\Phi(2)-1\approx0.9545,\\
\PP(|X-\mu|\le3\sigma)&=2\Phi(3)-1\approx0.9973.
\end{aligned}
\]
Demonstrație. Cu \(Z=(X-\mu)/\sigma\sim\Norm(0,1)\), \(\PP(|X-\mu|\le k\sigma)=\PP(|Z|\le k)=2\Phi(k)-1\) (Propoziția 15); valorile numerice se obțin din tabel sau cu pnorm.■
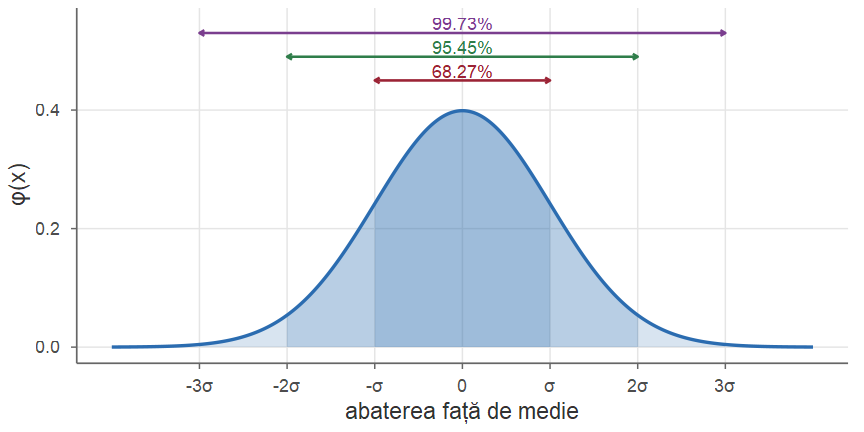
Regula spune că o variabilă normală se află la mai puțin de o abatere standard de medie cu probabilitatea de aproximativ \(68\%\), la mai puțin de două abateri standard cu probabilitatea de aproximativ \(95\%\) și practic sigur (cu probabilitatea \(99.7\%\)) la mai puțin de trei abateri standard (Figura 7). Valori aflate la mai mult de \(3\sigma\) de medie sunt foarte rare; în controlul calității, ele semnalează de obicei o anomalie.
Arată codul R
xx <-seq(-4, 4, length.out =801)dz <-data.frame(x = xx, y =dnorm(xx))g <-ggplot(dz, aes(x, y))for (k in3:1) { g <- g +geom_area(data =subset(dz, abs(x) <= k), fill = culori[["albastru"]], alpha =0.18)}lev <-data.frame(k =1:3, y =c(0.03, 0.03, 0.03))g +geom_line() +annotate("segment", x =-1:(-3), xend =1:3, y =c(0.45, 0.49, 0.53), yend =c(0.45, 0.49, 0.53),colour =unname(culori[c("rosu", "verde", "mov")]), linewidth =0.6,arrow =arrow(ends ="both", length =unit(0.1, "cm"))) +annotate("text", x =0, y =c(0.465, 0.505, 0.545), size =3.2,label =c("68.27%", "95.45%", "99.73%"),colour =unname(culori[c("rosu", "verde", "mov")])) +scale_x_continuous(breaks =-3:3, labels =c("-3σ", "-2σ", "-σ", "0", "σ", "2σ", "3σ")) +labs(x ="abaterea față de medie", y ="φ(x)")
Figura 7: Regula 68–95–99.7 pentru normala standard: aria de sub densitate pe \([-1,1]\), \([-2,2]\) și \([-3,3]\) este aproximativ \(0.68\), \(0.95\), respectiv \(0.997\).
Exemplul 6(Standardizare)
Fie \(X\sim\Norm(-1,4)\), deci \(\mu=-1\) și \(\sigma=2\). Calculăm \(\PP(|X|<3)\). Standardizând, \[
\begin{aligned}
\PP(|X|<3)&=\PP(-3<X<3)=\PP\Big(\frac{-3-(-1)}{2}<\frac{X-(-1)}{2}<\frac{3-(-1)}{2}\Big)\\
&=\PP\Big(-1<\frac{X+1}{2}<2\Big),
\end{aligned}
\] iar \(\frac{X+1}{2}\sim\Norm(0,1)\). Deci \(\PP(|X|<3)=\Phi(2)-\Phi(-1)=\Phi(2)+\Phi(1)-1\approx0.9772+0.8413-1=0.8186\).
Același rezultat se poate aproxima folosind doar regula 68–95–99.7: cu \(Z\sim\Norm(0,1)\), \(\PP(-1<Z<2)=\PP(-1<Z<1)+\PP(1\le Z<2)\approx0.68+\frac{0.95-0.68}{2}=0.815\), deoarece, din simetrie, aria dintre \(1\) și \(2\) este jumătate din aria \(\PP(1\le|Z|<2)\approx0.95-0.68\).
Exemplul 7(Coeficientul de inteligență)
Scorurile IQ sunt construite astfel încât să fie aproximativ \(\Norm(100,15^2)\). Proporția persoanelor cu IQ peste \(130\) este \(\PP(X>130)=1-\Phi\big(\frac{130-100}{15}\big)=1-\Phi(2)\approx0.0228\). Pragul depășit de doar \(10\%\) din populație este cuantila de ordin \(0.9\): din \(\Phi(z)=0.9\) obținem \(z_{0.9}\approx1.2816\), deci \(x_{0.9}=\mu+\sigma z_{0.9}\approx100+15\cdot1.2816\approx119.2\).
În general, cuantila de ordin \(\alpha\) a repartiției \(\Norm(\mu,\sigma^2)\) este \(x_\alpha=\mu+\sigma z_\alpha\), unde \(z_\alpha=\Phi^{-1}(\alpha)\) este cuantila normalei standard.
pnorm(2) -pnorm(-1) # P(-1 < Z < 2)#> [1] 0.8186pnorm(3, mean =-1, sd =2) -pnorm(-3, mean =-1, sd =2) # direct#> [1] 0.81861-pnorm(130, mean =100, sd =15) # P(IQ > 130)#> [1] 0.02275qnorm(0.9, mean =100, sd =15) # cuantila de ordin 0.9#> [1] 119.2round(2*pnorm(1:3) -1, 4) # regula 68-95-99.7#> [1] 0.6827 0.9545 0.9973
Atenție!
În R, repartiția normală este parametrizată prin abaterea standard\(\sigma\) (argumentul sd), nu prin varianța \(\sigma^2\). Pentru \(X\sim\Norm(-1,4)\) se scrie pnorm(x, mean = -1, sd = 2), nu sd = 4.
5.6 De ce apare repartiția normală atât de des?
La începutul secțiunii am afirmat că suma multor contribuții aleatoare mici și independente este aproximativ normală. Enunțul precis și demonstrația (Teorema Limită Centrală) vor fi date în Cursul 7; deocamdată vrem să vedem fenomenul pe cel mai simplu exemplu: adunăm variabile uniforme, a căror densitate, un dreptunghi, nu seamănă deloc cu un clopot; pentru detalii, vezi (Chan 2021, sec. 4.6.4).
Exemplul 8(Suma a două variabile uniforme independente)
Fie \(U_1,U_2\sim\Unif(0,1)\) independente și \(S_2=U_1+U_2\in[0,2]\). Perechea \((U_1,U_2)\) este un punct ales la întâmplare în pătratul \([0,1]^2\), astfel încât probabilitatea unui eveniment este aria regiunii corespunzătoare din pătrat (justificarea riguroasă va fi dată în Cursul 6). Pentru \(0\le s\le1\), regiunea \(\{u_1+u_2\le s\}\) este un triunghi dreptunghic cu ambele catete de lungime \(s\); pentru \(1<s\le2\), complementara ei este un astfel de triunghi, cu catetele de lungime \(2-s\). Deci \[
F_{S_2}(s)=\begin{cases}\dfrac{s^2}{2}, & 0\le s\le1,\\[2mm] 1-\dfrac{(2-s)^2}{2}, & 1<s\le2,\end{cases}
\qquad
f_{S_2}(s)=F_{S_2}'(s)=\begin{cases}s, & 0\le s\le1,\\[1mm] 2-s, & 1<s\le2.\end{cases}
\] Am obținut densitatea triunghiulară din Exercițiul 5 din Cursul 4: adunând două „dreptunghiuri” rezultă un „triunghi”. Valorile din jurul lui \(1\) sunt cele mai probabile fiindcă pot fi obținute în cele mai multe moduri, exact ca suma \(7\) la aruncarea a două zaruri (Exemplul 12 din Cursul 1).
Mai general, fie \(U_1,\dots,U_n\sim\Unif(0,1)\) independente și \(S_n=U_1+\dots+U_n\). Din Propoziția 4, din liniaritatea mediei și din aditivitatea varianței pentru variabile independente (Propoziția 12 din Cursul 4), \(\E[S_n]=\frac n2\) și \(\Var(S_n)=\frac n{12}\), deci suma standardizată\[
Z_n=\frac{S_n-n/2}{\sqrt{n/12}}
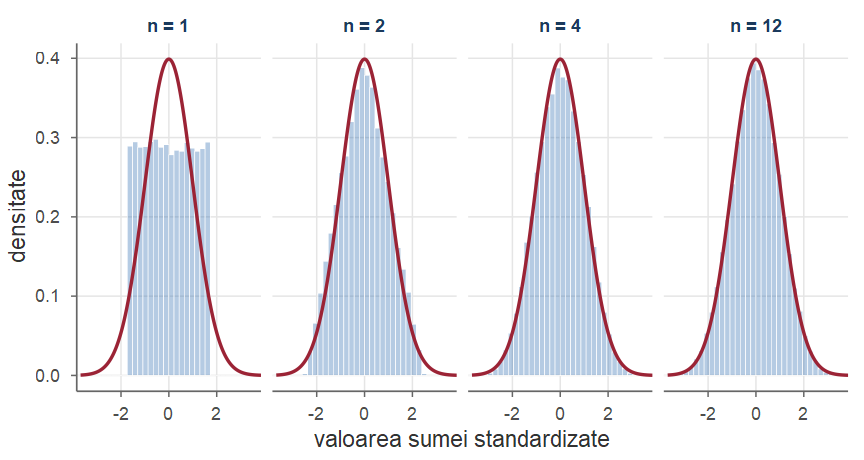
\] are media \(0\) și varianța \(1\) pentru orice \(n\); odată cu \(n\) se schimbă doar forma repartiției (Figura 8): dreptunghi pentru \(n=1\), triunghi pentru \(n=2\), iar de la \(n=4\) aproape un clopot.
Figura 8: Histogramele sumei standardizate \(Z_n\) a \(n\) variabile independente \(\Unif(0,1)\), pentru \(n\in\{1,2,4,12\}\) (câte \(40000\) de valori simulate), și densitatea \(\varphi\) a repartiției \(\Norm(0,1)\) (roșu).
Comparăm câteva probabilități ale lui \(Z_n\), estimate prin simulare, cu cele date de pnorm:
set.seed(2026); B <-1e5# B = numărul de simulăriz_n <-function(n) # suma standardizată a n uniforme (rowSums(matrix(runif(B * n), nrow = B)) - n /2) /sqrt(n /12)prob <-function(z) c(mean(z <=-1), mean(z <=1), mean(abs(z) <=2))tab <-rbind(t(sapply(c(1, 2, 4, 12), function(n) prob(z_n(n)))),c(pnorm(-1), pnorm(1), 2*pnorm(2) -1))dimnames(tab) <-list(c("n = 1", "n = 2", "n = 4", "n = 12", "N(0,1)"),c("P(Z <= -1)", "P(Z <= 1)", "P(|Z| <= 2)"))round(tab, 4)
Pentru \(n=12\), probabilitățile simulate diferă de cele normale cu mai puțin de \(0.002\).
Observație
Fenomenul nu ține de repartiția uniformă: același clopot se obține pornind de la aproape orice repartiție cu varianță finită, motiv pentru care mărimile care însumează multe efecte mici și independente (zgomotul unui senzor, eroarea totală a unei măsurători) sunt modelate cu repartiția normală. Pentru \(n=12\) avem \(Z_{12}=U_1+\dots+U_{12}-6\), formulă folosită mult timp pentru a genera rapid numere aproximativ normale; astăzi funcția rnorm folosește implicit metoda inversei (Secțiunea 3), care este exactă.
6 Alte repartiții continue: Gamma și Beta
6.1 Funcția Gamma și repartiția Gamma
Definiția 20(Funcția Gamma)
Pentru \(\alpha>0\), funcția Gamma (a lui Euler) este \[
\Gamma(\alpha)=\int_0^\infty x^{\alpha-1}e^{-x}\dd x .
\]
Propoziția 21(Proprietățile funcției Gamma)
Funcția Gamma are proprietățile: a) \(\Gamma(1)=1\); b) \(\Gamma(\alpha+1)=\alpha\,\Gamma(\alpha)\) pentru orice \(\alpha>0\); c) \(\Gamma(n)=(n-1)!\) pentru \(n\in\N\), \(n\ge1\); d) \(\Gamma(1/2)=\sqrt\pi\).
Demonstrație.
\(\int_0^\infty e^{-x}\dd x=1\). b) Integrând prin părți, \(\Gamma(\alpha+1)=\int_0^\infty x^\alpha\big(-e^{-x}\big)'\dd x=\big(-x^\alpha e^{-x}\big)\big|_0^\infty+\alpha\int_0^\infty x^{\alpha-1}e^{-x}\dd x=\alpha\Gamma(\alpha)\). c) rezultă din a) și b) prin inducție. d) Cu schimbarea de variabilă \(x=t^2/2\), \(\dd x=t\dd t\), și folosind (2), \[
\Gamma(1/2)=\int_0^\infty x^{-1/2}e^{-x}\dd x=\int_0^\infty\frac{\sqrt2}{t}e^{-t^2/2}\,t\dd t=\sqrt2\int_0^\infty e^{-t^2/2}\dd t=\sqrt2\cdot\frac{\sqrt{2\pi}}{2}=\sqrt\pi .
\]
■
Funcția Gamma prelungește deci factorialul la argumente reale. Cu schimbarea de variabilă \(x=\lambda t\) obținem formula foarte utilă \[
\int_0^\infty t^{\alpha-1}e^{-\lambda t}\dd t=\frac{\Gamma(\alpha)}{\lambda^\alpha},\qquad \alpha,\lambda>0,
\tag{4}\] care arată că funcția de mai jos este o densitate.
Definiția 22(Repartiția Gamma)
Fie \(\alpha>0\) și \(\lambda>0\). O variabilă aleatoare \(X\) are repartiția Gamma de parametri \(\alpha\) (parametru de formă) și \(\lambda\) (rată), și notăm \(X\sim\GammaD(\alpha,\lambda)\), dacă are densitatea \[
f(x)=\frac{\lambda^\alpha}{\Gamma(\alpha)}\,x^{\alpha-1}e^{-\lambda x},\qquad x>0,
\] și \(f(x)=0\) pentru \(x\le0\).
Propoziția 23(Media și varianța repartiției Gamma)
Dacă \(X\sim\GammaD(\alpha,\lambda)\), atunci \(\E[X^k]=\dfrac{\Gamma(\alpha+k)}{\Gamma(\alpha)\lambda^k}\) pentru \(k\ge1\); în particular \[
\E[X]=\frac{\alpha}{\lambda},\qquad \Var(X)=\frac{\alpha}{\lambda^2}.
\]
Demonstrație. Din (4), \(\E[X^k]=\frac{\lambda^\alpha}{\Gamma(\alpha)}\int_0^\infty x^{\alpha+k-1}e^{-\lambda x}\dd x=\frac{\lambda^\alpha}{\Gamma(\alpha)}\cdot\frac{\Gamma(\alpha+k)}{\lambda^{\alpha+k}}\). Cu \(\Gamma(\alpha+1)=\alpha\Gamma(\alpha)\) și \(\Gamma(\alpha+2)=(\alpha+1)\alpha\Gamma(\alpha)\) rezultă \(\E[X]=\alpha/\lambda\), \(\E[X^2]=\alpha(\alpha+1)/\lambda^2\) și \(\Var(X)=\alpha/\lambda^2\).■
Cazuri particulare importante:
pentru \(\alpha=1\) obținem \(\GammaD(1,\lambda)=\Exp(\lambda)\);
pentru \(\alpha=n\in\N\), repartiția \(\GammaD(n,\lambda)\) (numită și repartiția Erlang) este repartiția sumei a \(n\) variabile independente \(\Exp(\lambda)\), adică a timpului de așteptare până la al \(n\)-lea eveniment într-un proces Poisson de rată \(\lambda\) (vom demonstra acest fapt în Cursul 6);
pentru \(\alpha=n/2\) și \(\lambda=1/2\) obținem repartiția hi-pătrat cu \(n\) grade de libertate, \(\chisq{n}=\GammaD(n/2,1/2)\), fundamentală în statistică (Cursul 8).
6.2 Repartiția Beta
Definiția 24(Repartiția Beta)
Fie \(a,b>0\). O variabilă aleatoare \(X\) are repartiția Beta de parametri \(a\) și \(b\), și notăm \(X\sim\BetaD(a,b)\), dacă are densitatea \[
f(x)=\frac{1}{B(a,b)}\,x^{a-1}(1-x)^{b-1},\qquad 0<x<1,
\] și \(f(x)=0\) în rest, unde \(B(a,b)=\int_0^1x^{a-1}(1-x)^{b-1}\dd x\) este funcția Beta.
Se poate demonstra (folosind, din nou, o schimbare de variabilă într-o integrală dublă) că \[
B(a,b)=\frac{\Gamma(a)\Gamma(b)}{\Gamma(a+b)} .
\] Repartiția Beta este un model flexibil pentru mărimi aleatoare cuprinse între \(0\) și \(1\): proporții, probabilități, rate de succes. Pentru \(a=b=1\) obținem \(\BetaD(1,1)=\Unif(0,1)\); pentru \(a=b\) densitatea este simetrică față de \(1/2\); pentru \(a,b<1\) densitatea are forma literei U. Repartiția Beta joacă un rol central în statistica bayesiană (Cursul 11). Densitatea din Exemplul 2 din Cursul 4, \(\frac38(4x-2x^2)\) pe \((0,2)\), este densitatea lui \(2Y\) cu \(Y\sim\BetaD(2,2)\).
Propoziția 25(Media și varianța repartiției Beta)
Dacă \(X\sim\BetaD(a,b)\), atunci \[
\E[X]=\frac{a}{a+b},\qquad \Var(X)=\frac{ab}{(a+b)^2(a+b+1)}.
\]
Demonstrație.\(\E[X]=\frac{1}{B(a,b)}\int_0^1x^{a}(1-x)^{b-1}\dd x=\frac{B(a+1,b)}{B(a,b)}=\frac{\Gamma(a+1)\Gamma(b)}{\Gamma(a+b+1)}\cdot\frac{\Gamma(a+b)}{\Gamma(a)\Gamma(b)}=\frac{a}{a+b}\). Analog, \(\E[X^2]=\frac{B(a+2,b)}{B(a,b)}=\frac{a(a+1)}{(a+b)(a+b+1)}\), iar varianța se obține prin \(\E[X^2]-(\E[X])^2\).■
Arată codul R
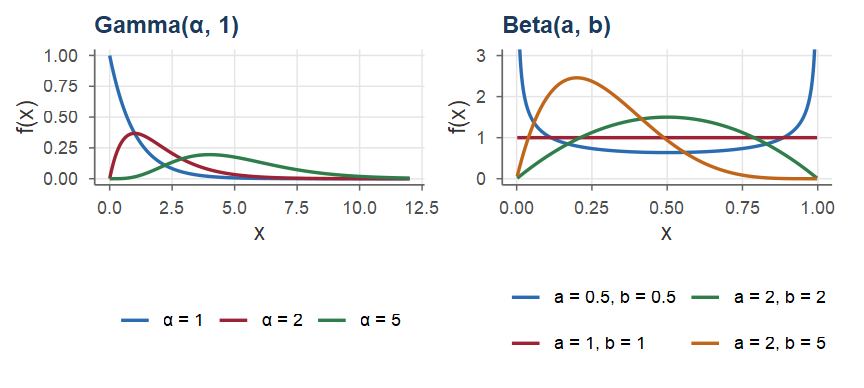
xg <-seq(0.001, 12, length.out =500)dg <-do.call(rbind, lapply(c(1, 2, 5), function(a)data.frame(x = xg, y =dgamma(xg, shape = a, rate =1), p =paste0("α = ", a))))xb <-seq(0.002, 0.998, length.out =500)pr <-list(c(0.5, 0.5), c(1, 1), c(2, 2), c(2, 5))db <-do.call(rbind, lapply(pr, function(v)data.frame(x = xb, y =dbeta(xb, v[1], v[2]), p =paste0("a = ", v[1], ", b = ", v[2]))))g1 <-ggplot(dg, aes(x, y, colour = p)) +geom_line() +labs(title ="Gamma(α, 1)", x ="x", y ="f(x)", colour =NULL)g2 <-ggplot(db, aes(x, y, colour = p)) +geom_line() +coord_cartesian(ylim =c(0, 3)) +labs(title ="Beta(a, b)", x ="x", y ="f(x)", colour =NULL) +guides(colour =guide_legend(nrow =2))g1 + g2
Figura 9: Stânga: densitățile \(\GammaD(\alpha,1)\) pentru \(\alpha\in\{1,2,5\}\) (pentru \(\alpha=1\) se obține \(\Exp(1)\)). Dreapta: densitățile \(\BetaD(a,b)\) pentru câteva perechi de parametri; \(\BetaD(1,1)\) este repartiția uniformă.
7 Transformări de variabile aleatoare
În multe probleme cunoaștem repartiția unei variabile \(X\) și ne interesează repartiția unei funcții \(Y=g(X)\): aria \(Y=\pi X^2\) a unui disc cu raza aleatoare \(X\), energia cinetică \(\frac12mV^2\) a unei particule cu viteza aleatoare \(V\), valoarea \(Y=e^X\) a unei investiții al cărei randament logaritmic este \(X\). Dacă ne interesează doar media lui \(Y\), formula \(\E[g(X)]=\int g(x)f_X(x)\dd x\) (Teorema 10 din Cursul 4) este suficientă; pentru probabilități, cuantile sau densitate avem nevoie de repartiția lui \(Y\).
În cazul discret problema este simplă: \(\PP(Y=y)=\sum_{x:\,g(x)=y}\PP(X=x)\). În cazul continuu nu putem proceda punct cu punct (toate probabilitățile punctuale sunt nule), dar putem lucra cu funcția de repartiție.
7.1 Metoda funcției de repartiție
Pentru a determina densitatea lui \(Y=g(X)\), unde \(X\) are densitatea \(f_X\):
exprimăm \(F_Y(y)=\PP(g(X)\le y)\) ca probabilitate a unui eveniment referitor la \(X\), \(\PP\big(X\in\{x: g(x)\le y\}\big)\), și o calculăm cu ajutorul lui \(F_X\) sau \(f_X\);
derivăm: \(f_Y(y)=F_Y'(y)\).
Dacă \(g\) este strict crescătoare, pasul 1 este imediat: \(\PP(g(X)\le y)=\PP(X\le g^{-1}(y))=F_X(g^{-1}(y))\), iar densitatea se obține derivând funcția compusă.
Exemplul 9(Modulul unei variabile normale)
Fie \(Z\sim\Norm(0,1)\) și \(Y=|Z|\). Determinăm a) \(\E[Y]\) și \(\Var(Y)\); b) funcția de repartiție și densitatea lui \(Y\).
Din Teorema 10 din Cursul 4 și paritatea integrandului, \[
\begin{aligned}
\E[Y]&=\int_{-\infty}^{\infty}|z|\frac{1}{\sqrt{2\pi}}e^{-z^2/2}\dd z=2\int_0^\infty z\frac{1}{\sqrt{2\pi}}e^{-z^2/2}\dd z\\
&=\sqrt{\frac2\pi}\Big(-e^{-z^2/2}\Big)\Big|_0^\infty=\sqrt{\frac2\pi}\approx0.7979 .
\end{aligned}
\] Cum \(Y^2=Z^2\), \(\E[Y^2]=\E[Z^2]=1\), deci \(\Var(Y)=1-\frac2\pi\approx0.3634\).
\(Y\ge0\), deci \(F_Y(y)=0\) pentru \(y<0\). Pentru \(y\ge0\), folosind Propoziția 15, \[
F_Y(y)=\PP(|Z|\le y)=\PP(-y\le Z\le y)=\Phi(y)-\Phi(-y)=2\Phi(y)-1 .
\] Derivând, \(f_Y(y)=2\varphi(y)=\sqrt{\frac2\pi}e^{-y^2/2}\) pentru \(y>0\) și \(f_Y(y)=0\) pentru \(y<0\). Densitatea lui \(|Z|\) este deci „jumătatea dreaptă” a clopotului lui Gauss, dublată (repartiția semi-normală). Ca aplicație, dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci abaterea medie absolută este \(\E|X-\mu|=\sigma\E|Z|=\sigma\sqrt{2/\pi}\approx0.798\,\sigma\), cu aproximativ \(20\%\) mai mică decât abaterea standard.
Exemplul 10(Pătratul unei variabile uniforme)
Fie \(U\sim\Unif(0,1)\) și \(Y=U^2\in[0,1]\). Pentru \(y\in[0,1]\), \(F_Y(y)=\PP(U^2\le y)=\PP(U\le\sqrt y)=\sqrt y\), deci \(f_Y(y)=\frac{1}{2\sqrt y}\) pentru \(0<y\le1\). Regăsim densitatea nemărginită din Exemplul 1 din Cursul 4: faptul că densitatea explodează în \(0\) reflectă faptul că ridicarea la pătrat „comprimă” valorile mici ale lui \(U\) spre \(0\) (de exemplu, \(U\le0.1\) implică \(Y\le0.01\)).
7.2 Formula schimbării de variabilă
Teorema 26(Densitatea unei funcții strict monotone de X)
Fie \(X\) o variabilă aleatoare continuă cu densitatea \(f_X\), nulă în afara unui interval deschis \(I\), și fie \(g:I\to\R\) o funcție strict monotonă și derivabilă, cu \(g'(x)\ne0\) pe \(I\). Atunci \(Y=g(X)\) este o variabilă continuă, cu densitatea \[
f_Y(y)=f_X\big(g^{-1}(y)\big)\,\Big|\frac{\dd}{\dd y}g^{-1}(y)\Big|,\qquad y\in g(I),
\tag{5}\] și \(f_Y(y)=0\) pentru \(y\notin g(I)\).
Demonstrație. Notăm \(h=g^{-1}:g(I)\to I\); \(h\) este strict monotonă și derivabilă, cu \(h'(y)=1/g'(h(y))\).
Cazul \(g\) strict crescătoare. Atunci \(h\) este crescătoare și, pentru \(y\in g(I)\), \(F_Y(y)=\PP(g(X)\le y)=\PP(X\le h(y))=F_X(h(y))\). Derivând funcția compusă, \(f_Y(y)=f_X(h(y))\,h'(y)\), iar \(h'(y)>0\), deci \(h'(y)=|h'(y)|\).
Cazul \(g\) strict descrescătoare. Aplicarea lui \(h\) (descrescătoare) inversează inegalitatea: \(F_Y(y)=\PP(g(X)\le y)=\PP(X\ge h(y))=1-F_X(h(y))\), căci \(\PP(X=h(y))=0\). Derivând, \(f_Y(y)=-f_X(h(y))\,h'(y)=f_X(h(y))\,|h'(y)|\), deoarece acum \(h'(y)<0\).■
Factorul \(|\frac{\dd}{\dd y}g^{-1}(y)|=1/|g'(x)|\) (cu \(x=g^{-1}(y)\)) are o interpretare simplă: probabilitatea \(f_X(x)\dd x\) a unui interval mic din jurul lui \(x\) se regăsește în intervalul din jurul lui \(y=g(x)\), de lungime \(|g'(x)|\dd x\); densitatea (probabilitate pe unitatea de lungime) se împarte deci la \(|g'(x)|\). Formula (5) este cazul unidimensional al Teoremei 13; varianta ei multidimensională va fi folosită pentru vectori aleatori în Cursul 6.
Corolarul 27(Transformări afine)
Dacă \(X\) are densitatea \(f_X\) și \(a\ne0\), \(b\in\R\), atunci \(Y=aX+b\) are densitatea \[
f_Y(y)=\frac{1}{|a|}\,f_X\Big(\frac{y-b}{a}\Big),\qquad y\in\R .
\]
De exemplu, pentru \(X\sim\Norm(\mu,\sigma^2)\), corolarul redă imediat Corolarul 18, iar pentru \(X\sim\Exp(\lambda)\) și \(a=c>0\), \(b=0\) redă \(cX\sim\Exp(\lambda/c)\).
Exemplul 11(Repartiția log-normală)
Fie \(X\sim\Norm(\mu,\sigma^2)\) și \(Y=e^X\). Funcția \(g(x)=e^x\) este strict crescătoare de la \(\R\) la \((0,\infty)\), cu \(g^{-1}(y)=\ln y\) și \(\frac{\dd}{\dd y}\ln y=\frac1y\). Din (5), \[
f_Y(y)=\frac{1}{\sqrt{2\pi}\,\sigma}\,e^{-\frac{(\ln y-\mu)^2}{2\sigma^2}}\cdot\frac1y=\frac{1}{y\,\sigma\sqrt{2\pi}}\,e^{-\frac{(\ln y-\mu)^2}{2\sigma^2}},\qquad y>0 .
\] Spunem că \(Y\) are repartiție log-normală de parametri \(\mu\) și \(\sigma^2\) (\(\ln Y\) este normală). Ea modelează mărimi pozitive rezultate din efecte multiplicative: prețuri ale acțiunilor, venituri, dimensiuni ale particulelor.
Media se calculează cu Teorema 10 din Cursul 4, fără a folosi \(f_Y\). Pentru \(Z\sim\Norm(0,1)\) și \(t\in\R\), completând pătratul, \(tz-\frac{z^2}{2}=\frac{t^2}{2}-\frac{(z-t)^2}{2}\), deci \[
\E[e^{tZ}]=\int_{-\infty}^{\infty}e^{tz}\frac{e^{-z^2/2}}{\sqrt{2\pi}}\dd z=e^{t^2/2}\int_{-\infty}^{\infty}\frac{e^{-(z-t)^2/2}}{\sqrt{2\pi}}\dd z=e^{t^2/2},
\] ultima integrală fiind integrala densității \(\Norm(t,1)\). Cu \(X=\mu+\sigma Z\) obținem \(\E[Y]=e^\mu\E[e^{\sigma Z}]=e^{\mu+\sigma^2/2}\) și \(\E[Y^2]=\E[e^{2X}]=e^{2\mu+2\sigma^2}\), deci \[
\E[Y]=e^{\mu+\sigma^2/2},\qquad \Var(Y)=\big(e^{\sigma^2}-1\big)e^{2\mu+\sigma^2}.
\] Mediana lui \(Y\) este \(e^\mu\) (deoarece \(\PP(Y\le e^\mu)=\PP(X\le\mu)=1/2\)), mai mică decât media: repartiția log-normală are o coadă lungă spre dreapta. Observăm și că \(\E[e^X]=e^{\mu+\sigma^2/2}>e^{\E[X]}\).
7.3 Transformări care nu sunt monotone
Dacă \(g\) nu este monotonă, formula (5) nu se aplică direct, dar metoda funcției de repartiție funcționează în continuare. Exemplul cel mai important este pătratul unei variabile normale standard.
Exemplul 12(Pătratul normalei standard: repartiția hi-pătrat cu un grad de libertate)
Fie \(Z\sim\Norm(0,1)\) și \(Y=Z^2\). Funcția \(g(z)=z^2\) nu este monotonă pe \(\R\). Pentru \(y\le0\), \(F_Y(y)=0\). Pentru \(y>0\), \[
F_Y(y)=\PP(Z^2\le y)=\PP(-\sqrt y\le Z\le\sqrt y)=\Phi(\sqrt y)-\Phi(-\sqrt y)=2\Phi(\sqrt y)-1 .
\] Derivând, \[
f_Y(y)=2\varphi(\sqrt y)\cdot\frac{1}{2\sqrt y}=\frac{1}{\sqrt{2\pi}}\,y^{-1/2}e^{-y/2},\qquad y>0 .
\] Comparând cu Definiția 22 și folosind \(\Gamma(1/2)=\sqrt\pi\), recunoaștem densitatea \(\GammaD(1/2,1/2)\): \(\frac{(1/2)^{1/2}}{\Gamma(1/2)}=\frac{1}{\sqrt{2\pi}}\). Așadar \(Z^2\sim\chisq{1}\) (repartiția hi-pătrat cu un grad de libertate), cu \(\E[Y]=\E[Z^2]=1\) și \(\Var(Y)=\E[Z^4]-1=3-1=2\). Această repartiție stă la baza testelor \(\chi^2\) din partea a doua a cursului (Cursul 8).
Mai general, dacă ecuația \(g(x)=y\) are un număr finit de soluții \(x_1(y),\dots,x_m(y)\) și \(g'(x_i)\ne0\), atunci \[
f_Y(y)=\sum_{i=1}^m\frac{f_X\big(x_i(y)\big)}{\big|g'\big(x_i(y)\big)\big|},
\] deoarece fiecare soluție contribuie cu masa de probabilitate din vecinătatea ei. Pentru \(g(z)=z^2\), soluțiile sunt \(\pm\sqrt y\), \(|g'(\pm\sqrt y)|=2\sqrt y\) și regăsim \(f_Y(y)=\frac{\varphi(\sqrt y)+\varphi(-\sqrt y)}{2\sqrt y}\).
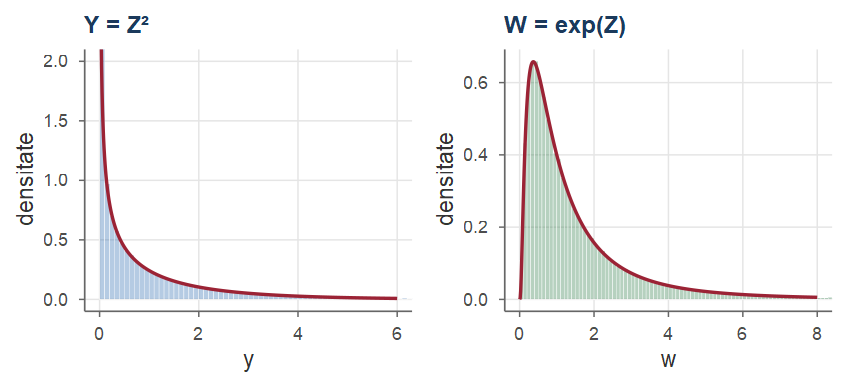
În practică, este util să verificăm prin simulare formula obținută pentru densitatea unei transformări: generăm multe valori ale lui \(X\), le aplicăm \(g\) și comparăm histograma cu densitatea calculată (Figura 10).
Figura 10: Verificarea prin simulare a densităților obținute prin transformare, pentru \(10^5\) valori \(Z\sim\Norm(0,1)\). Stânga: histograma lui \(Y=Z^2\) și densitatea \(\chisq{1}\), \(\frac{1}{\sqrt{2\pi}}y^{-1/2}e^{-y/2}\) (nemărginită în \(0\)). Dreapta: histograma lui \(W=e^Z\) și densitatea log-normală.
Atenție!
Formula (5) se aplică doar funcțiilor strict monotone pe suportul lui \(X\). O greșeală frecventă este aplicarea ei pentru \(Y=Z^2\) cu \(g^{-1}(y)=\sqrt y\), ceea ce ar da \(f_Y(y)=\varphi(\sqrt y)/(2\sqrt y)\), o funcție a cărei integrală este \(1/2\), nu \(1\): s-a pierdut contribuția ramurii \(z<0\). În caz de dubiu, folosiți metoda funcției de repartiție și verificați că densitatea obținută are integrala \(1\).
8 Asimetria și aplatizarea unei repartiții
Media și varianța arată unde se află „centrul” unei repartiții și cât de împrăștiate sunt valorile, dar nu spun nimic despre formă: \(\Norm(1,1)\) și \(\Exp(1)\) au aceeași medie și aceeași varianță, însă prima este simetrică, iar a doua are o coadă lungă spre dreapta. Forma se descrie cu momentele centrate de ordin \(3\) și \(4\) (Definiția 11 din Cursul 4), calculate pentru variabila standardizată; pentru detalii, vezi (Chan 2021, sec. 4.6.3).
Definiția 28(Coeficientul de asimetrie și coeficientul de aplatizare)
Fie \(X\) o variabilă aleatoare cu \(\E[X^4]<\infty\), cu media \(\mu\) și abaterea standard \(\sigma>0\), și fie \(Z=(X-\mu)/\sigma\) variabila standardizată. Numerele \[
\gamma_X=\E[Z^3]=\frac{\E\big[(X-\mu)^3\big]}{\sigma^3},\qquad
\kappa_X=\E[Z^4]=\frac{\E\big[(X-\mu)^4\big]}{\sigma^4}
\] se numesc coeficientul de asimetrie (engl. skewness), respectiv coeficientul de aplatizare (engl. kurtosis) al lui \(X\). Diferența \(\kappa_X-3\) se numește exces.
Dacă înlocuim \(X\) cu \(aX+b\), unde \(a>0\), variabila standardizată rămâne aceeași: \(\gamma_X\) și \(\kappa_X\) nu depind de unitatea de măsură sau de origine, ci doar de forma repartiției.
Asimetria. Pentru o densitate simetrică față de \(\mu\) avem \(\gamma_X=0\). O valoare \(\gamma_X>0\) indică o coadă mai lungă spre dreapta (valori mult mai mari decât media apar rar, dar apar: timpi de răspuns, venituri, dimensiuni de fișiere), iar \(\gamma_X<0\) o coadă mai lungă spre stânga.
Aplatizarea. Puterea a patra face ca \(\kappa_X\) să fie dominat de abaterile mari: în ciuda numelui, coeficientul măsoară cât de grele sunt cozile. Reperul este repartiția normală, cu \(\kappa=3\): un exces pozitiv înseamnă valori extreme mai frecvente decât la normală, iar un exces negativ, mai rare.
Propoziția 29(Asimetria și aplatizarea repartițiilor uzuale)
Coeficienții de asimetrie și de aplatizare nu depind de parametrii repartiției: \[
\begin{array}{l|ccc}
& \Norm(\mu,\sigma^2) & \Unif(a,b) & \Exp(\lambda)\\ \hline
\text{asimetria }\gamma & 0 & 0 & 2\\
\text{aplatizarea }\kappa & 3 & 9/5 & 9
\end{array}
\]
Demonstrație. Coeficienții nu se schimbă la transformări \(x\mapsto ax+b\) cu \(a>0\), deci este suficient să facem calculul pentru \(\Norm(0,1)\), \(\Unif(-1,1)\) și \(\Exp(1)\). Pentru \(Z\sim\Norm(0,1)\) avem \(\E[Z^3]=0\) și \(\E[Z^4]=3\) (Propoziția 16). Pentru \(V\sim\Unif(-1,1)\) densitatea este pară, deci \(\E[V]=\E[V^3]=0\), iar \(\E[V^2]=\frac12\int_{-1}^1x^2\dd x=\frac13\) și \(\E[V^4]=\frac12\int_{-1}^1x^4\dd x=\frac15\), de unde \(\gamma=0\) și \(\kappa=\frac{1/5}{(1/3)^2}=\frac95\). Pentru \(X\sim\Exp(1)\) avem \(\mu=\sigma=1\) și \(\E[X^k]=\int_0^\infty x^ke^{-x}\dd x=\Gamma(k+1)=k!\) (Propoziția 21), deci \[
\begin{aligned}
\gamma&=\E[(X-1)^3]=\E[X^3]-3\E[X^2]+3\E[X]-1=6-6+3-1=2,\\
\kappa&=\E[(X-1)^4]=\E[X^4]-4\E[X^3]+6\E[X^2]-4\E[X]+1=24-24+12-4+1=9 .
\end{aligned}
\]■
Repartiția uniformă, simetrică și fără cozi, are exces negativ, iar cea exponențială este puternic asimetrică și are cozi grele. Același calcul dă pentru \(\GammaD(\alpha,\lambda)\) valorile \(\gamma=2/\sqrt\alpha\) și \(\kappa=3+6/\alpha\), care tind la \(0\) și la \(3\) când \(\alpha\) crește: \(\GammaD(n,\lambda)\) este repartiția sumei a \(n\) variabile exponențiale independente, iar sumele se apropie de repartiția normală (Secțiunea 5.6).
Pentru un eșantion \(x_1,\dots,x_n\), coeficienții se estimează înlocuind mediile teoretice cu medii aritmetice:
Valorile empirice sunt apropiate de cele teoretice (\(2/\sqrt{10}\approx0.63\) și \(3.6\) pentru \(\GammaD(10,1)\)). În analiza datelor, cei doi coeficienți oferă o verificare rapidă a normalității: dacă forma(x) este departe de \((0,3)\), metodele care presupun normalitatea trebuie folosite cu prudență, ca în exemplul următor.
Exemplul 13(Alarme false la monitorizarea unui server)
Un sistem de monitorizare semnalează o anomalie ori de câte ori timpul de răspuns \(X\) al unui server depășește pragul \(\mu+3\sigma\), ales pe baza regulii 68–95–99.7 (Teorema 19). Dacă \(X\) ar fi repartizat normal, o alarmă falsă s-ar produce cu probabilitatea \(1-\Phi(3)\approx0.00135\), adică aproximativ o dată la \(741\) de cereri. Dacă însă \(X\sim\Exp(\lambda)\), atunci \(\mu=\sigma=1/\lambda\) și \[
\PP(X>\mu+3\sigma)=\PP(X>4/\lambda)=e^{-4}\approx0.0183,
\] adică o alarmă falsă la aproximativ \(55\) de cereri, de aproape \(14\) ori mai des. Valorile \(\gamma=2\) și \(\kappa=9\) avertizează tocmai asupra acestui fapt: regulile construite pentru repartiția normală nu se aplică unor date asimetrice, cu cozi grele.
9 Tabel sinteză al repartițiilor continue
Tabelul 1 reunește repartițiile continue studiate în acest curs și în Cursul 4. În coloana R este dat sufixul numelui funcțiilor: dnume (densitatea), pnume (funcția de repartiție), qnume (funcția cuantilă), rnume (generarea de valori aleatoare); de exemplu dnorm, pnorm, qnorm, rnorm.
Tabelul 1: Repartiții continue uzuale: densitatea și suportul, media, varianța și numele funcțiilor R corespunzătoare (se adaugă prefixele d, p, q, r; primul argument este \(x\), \(q\), \(p\), respectiv numărul de valori generate).
Lipsa de memorie: \(\PP(X>s+t\mid X>s)=\PP(X>t)\); o caracterizează pe \(\Exp(\lambda)\) printre repartițiile continue; \(\Exp(\lambda)\) este limita timpului de așteptare geometric \(K_n/n\), \(K_n\sim\Geom(\lambda/n)\).
\(\Norm(\mu,\sigma^2)\): \(f=\frac{1}{\sigma\sqrt{2\pi}}e^{-(x-\mu)^2/(2\sigma^2)}\); \(\int_{\R} e^{-x^2/2}\dd x=\sqrt{2\pi}\); \(\Phi(-z)=1-\Phi(z)\); \(\E[Z^{2k}]=(2k-1)(2k-3)\cdots1\); sumele standardizate de variabile independente sunt aproximativ \(\Norm(0,1)\).
Regula 68–95–99.7: \(\PP(|X-\mu|\le k\sigma)\approx0.6827,\ 0.9545,\ 0.9973\) pentru \(k=1,2,3\); nu se aplică repartițiilor asimetrice sau cu cozi grele. Asimetria \(\gamma=\E[Z^3]\) și aplatizarea \(\kappa=\E[Z^4]\) ale variabilei standardizate: \((0,3)\) pentru normală, \((0,9/5)\) pentru uniformă, \((2,9)\) pentru exponențială.
Transformări: \(F_Y(y)=\PP(g(X)\le y)\), apoi \(f_Y=F_Y'\); pentru \(g\) strict monotonă, \(f_Y(y)=f_X(g^{-1}(y))\,|(g^{-1})'(y)|\); \(Z^2\sim\chisq{1}\), \(e^{X}\) log-normală.
Legătura cu cursurile următoare. Până acum am studiat câte o singură variabilă aleatoare. În Cursul 6 trecem la vectori aleatori: repartiția comună a mai multor variabile, independența, covarianța și media condiționată; tot acolo determinăm repartiția sumei a două variabile independente și arătăm că suma a \(n\) variabile independente \(\Exp(\lambda)\) este \(\GammaD(n,\lambda)\). Teorema Limită Centrală din Cursul 7 explică riguros de ce repartiția normală apare atât de des: suma standardizată a unui număr mare de variabile independente este aproximativ \(\Norm(0,1)\). În Cursul 8, repartițiile \(\chi^2\), Student și Fisher, pe care se bazează statistica inferențială, se construiesc din repartițiile normală și Gamma studiate astăzi.
10 Exerciții rezolvate
Exercițiul 1(Rădăcinile unei ecuații cu coeficient aleator)
Fie \(U\sim\Unif(0,5)\). Care este probabilitatea ca ecuația \(4x^2+4Ux+U+2=0\) să aibă ambele rădăcini reale?
Soluție
Rădăcinile sunt reale dacă și numai dacă discriminantul este nenegativ: \(16U^2-16(U+2)\ge0\iff U^2-U-2\ge0\iff(U-2)(U+1)\ge0\). Cum \(U\ge0\), avem \(U+1>0\), deci condiția devine \(U\ge2\). Prin urmare \(\PP(U\ge2)=\frac{5-2}{5}=\frac35 .\)
Exercițiul 2(Bățul rupt)
Un băț de lungime \(1\) se rupe într-un punct ales uniform. Fie \(L\) lungimea bucății mai lungi. Determinați repartiția lui \(L\), \(\E[L]\), \(\Var(L)\) și probabilitatea ca bucata mai lungă să fie de cel puțin două ori mai lungă decât cea scurtă.
Soluție
Fie \(U\sim\Unif(0,1)\) punctul de rupere; \(L=\max(U,1-U)\in[1/2,1]\). Pentru \(x\in[1/2,1]\), \[
F_L(x)=\PP(U\le x,\ 1-U\le x)=\PP(1-x\le U\le x)=x-(1-x)=2x-1 .
\] Aceasta este funcția de repartiție a lui \(\Unif(1/2,1)\) (Propoziția 2 cu \(a=1/2\), \(b=1\)). Deci \(\E[L]=\frac34\) și \(\Var(L)=\frac{(1/2)^2}{12}=\frac1{48}\). Bucata lungă este de cel puțin două ori mai lungă decât cea scurtă dacă \(L\ge2(1-L)\), adică \(L\ge2/3\): \(\PP(L\ge2/3)=\frac{1-2/3}{1/2}=\frac23\).
Exercițiul 3(Durata de viață a unui server)
Durata de funcționare (în ani) a unui server până la prima defecțiune este \(X\sim\Exp(\lambda)\) cu \(\E[X]=5\) ani. a) Calculați \(\PP(X>5)\) și \(\PP(3<X<7)\). b) Știind că serverul funcționează de \(4\) ani, care este probabilitatea să mai funcționeze cel puțin \(5\) ani? c) Determinați mediana și cuantila de ordin \(0.9\).
Soluție
Din \(\E[X]=1/\lambda=5\) obținem \(\lambda=0.2\).
Exercițiul 4(Partea întreagă a unei variabile exponențiale)
Fie \(X\sim\Exp(\lambda)\) și \(N=\lfloor X\rfloor\) partea întreagă a lui \(X\). Determinați repartiția lui \(N\) și \(\E[N]\).
Soluție
\(N\) ia valori în \(\{0,1,2,\dots\}\) și, pentru \(k\ge0\), \[
\PP(N=k)=\PP(k\le X<k+1)=e^{-\lambda k}-e^{-\lambda(k+1)}=\big(e^{-\lambda}\big)^k\big(1-e^{-\lambda}\big).
\] Cu \(p=1-e^{-\lambda}\), \(\PP(N=k)=(1-p)^kp\), deci \(N+1\sim\Geom(p)\) (numărul de încercări până la primul succes). Rezultă \(\E[N]=\frac1p-1=\frac{e^{-\lambda}}{1-e^{-\lambda}}=\frac{1}{e^{\lambda}-1}\). Discretizarea unei variabile exponențiale produce o variabilă geometrică, ceea ce explică de ce ambele repartiții au proprietatea lipsei de memorie.
Exercițiul 5(Note la examen)
Notele la un examen sunt aproximativ \(\Norm(6.5,\,1.5^2)\). a) Ce proporție de studenți obțin peste \(8\)? b) Ce proporție obțin note între \(5\) și \(9\)? c) Care este nota minimă a celor mai buni \(10\%\) dintre studenți?
Exercițiul 6(Determinarea parametrilor din două cuantile)
Durata unei intervenții (în minute) este \(X\sim\Norm(\mu,\sigma^2)\). Se știe că \(10\%\) dintre intervenții durează mai puțin de \(60\) de minute și \(5\%\) durează mai mult de \(90\) de minute. Determinați \(\mu\) și \(\sigma\).
Soluție
Condițiile sunt \(\Phi\big(\frac{60-\mu}{\sigma}\big)=0.1\) și \(\Phi\big(\frac{90-\mu}{\sigma}\big)=0.95\). Cum \(z_{0.1}=-z_{0.9}\approx-1.2816\) și \(z_{0.95}\approx1.6449\), obținem sistemul liniar \[
\begin{cases}60-\mu=-1.2816\,\sigma,\\ 90-\mu=1.6449\,\sigma.\end{cases}
\] Scăzând ecuațiile, \(30=2.9265\,\sigma\), deci \(\sigma\approx10.25\) și \(\mu=60+1.2816\,\sigma\approx73.14\) minute.
s <-30/ (qnorm(0.95) -qnorm(0.1)); m <-60-qnorm(0.1) * sc(mu = m, sigma = s, P60 =pnorm(60, m, s), P90 =1-pnorm(90, m, s))#> mu sigma P60 P90 #> 73.14 10.25 0.10 0.05
Exercițiul 7(Toleranțe de fabricație)
Diametrul (în mm) al unor bile de rulment este \(\Norm(10,\,0.02^2)\). O bilă este acceptată dacă diametrul ei este în intervalul \([9.95,\,10.05]\). a) Ce proporție de bile este acceptată? b) Cât de mică trebuie să fie abaterea standard pentru ca \(99\%\) dintre bile să fie acceptate?
Vrem \(2\Phi(0.05/\sigma)-1=0.99\), adică \(\Phi(0.05/\sigma)=0.995\), deci \(0.05/\sigma=z_{0.995}\approx2.5758\) și \(\sigma\approx0.0194\) mm.
Exercițiul 8(Inversa unei variabile uniforme)
Fie \(U\sim\Unif(0,1)\) și \(Y=1/U\). Determinați densitatea lui \(Y\) și arătați că \(\E[Y]=\infty\).
Soluție
Funcția \(g(u)=1/u\) este strict descrescătoare pe \((0,1)\), cu \(g((0,1))=(1,\infty)\), \(g^{-1}(y)=1/y\) și \(\big|\frac{\dd}{\dd y}\frac1y\big|=\frac1{y^2}\). Din (5), \(f_Y(y)=1\cdot\frac{1}{y^2}\) pentru \(y>1\) și \(0\) în rest (o repartiție Pareto). Verificare cu metoda funcției de repartiție: \(F_Y(y)=\PP(U\ge1/y)=1-1/y\) pentru \(y\ge1\). Media nu este finită: \(\E[Y]=\int_1^\infty y\cdot\frac1{y^2}\dd y=\int_1^\infty\frac{\dd y}{y}=+\infty\) (sau direct, \(\E[1/U]=\int_0^1\frac{\dd u}{u}=\infty\)). Deși \(U\) este mărginită, inversa ei are o coadă foarte grea.
Exercițiul 9(Rădăcina pătrată a unei variabile exponențiale)
Fie \(X\sim\Exp(1)\) și \(Y=\sqrt X\). Determinați densitatea lui \(Y\), \(\PP(Y>1)\) și \(\E[Y]\).
Soluție
Pe \((0,\infty)\), \(g(x)=\sqrt x\) este strict crescătoare, \(g^{-1}(y)=y^2\), \(\frac{\dd}{\dd y}y^2=2y\). Deci \(f_Y(y)=e^{-y^2}\cdot2y\) pentru \(y>0\). Apoi \(\PP(Y>1)=\PP(X>1)=e^{-1}\approx0.3679\) (nu avem nevoie de \(f_Y\)), iar din Teorema 10 din Cursul 4 și definiția funcției Gamma, \[
\E[Y]=\E[X^{1/2}]=\int_0^\infty x^{1/2}e^{-x}\dd x=\Gamma(3/2)=\tfrac12\Gamma(1/2)=\frac{\sqrt\pi}{2}\approx0.8862 .
\]
Exercițiul 10(Log-normala în practică)
Randamentul logaritmic anual al unei investiții este \(X\sim\Norm(0,1)\) (în unități convenabile), iar factorul de creștere este \(Y=e^X\). Calculați \(\PP(Y>2)\), mediana și media lui \(Y\) și verificați prin simulare.
Soluție
\(\PP(Y>2)=\PP(X>\ln2)=1-\Phi(0.6931)\approx0.2441\). Mediana este \(e^0=1\), iar media \(\E[Y]=e^{1/2}\approx1.6487\) (Exemplul 11). Media este influențată de valorile foarte mari, rare, ale lui \(Y\).
Folosind metoda inversei, scrieți un algoritm de simulare pentru repartiția Cauchy, cu densitatea \(f(x)=\frac{1}{\pi(1+x^2)}\), și comparați cuantilele empirice cu cele teoretice.
Soluție
Funcția de repartiție este \(F(x)=\int_{-\infty}^x\frac{\dd t}{\pi(1+t^2)}=\frac12+\frac1\pi\arctan x\), continuă și strict crescătoare. Din \(\frac12+\frac1\pi\arctan x=u\) obținem \(F^{-1}(u)=\tan\big(\pi(u-\tfrac12)\big)\). Deci, dacă \(U\sim\Unif(0,1)\), atunci \(\tan\big(\pi(U-\frac12)\big)\) are repartiție Cauchy. Echivalent: dacă \(\Theta\sim\Unif(-\pi/2,\pi/2)\), atunci \(\tan\Theta\) este Cauchy (panta unei drepte prin origine cu unghi uniform aleator).
Cuantilele sunt reproduse bine, dar media aritmetică a valorilor simulate nu se stabilizează când \(n\) crește, deoarece \(\E[X]\) nu există (Exemplul 8 din Cursul 4).
Exercițiul 12(Integrale calculate cu funcția Gamma)
Calculați \(\int_0^\infty x^4e^{-2x}\dd x\). b) Fie \(X\sim\GammaD(\alpha,\lambda)\) cu \(\alpha>1\). Calculați \(\E[1/X]\).
Soluție
Din (4) cu \(\alpha=5\), \(\lambda=2\): \(\int_0^\infty x^4e^{-2x}\dd x=\frac{\Gamma(5)}{2^5}=\frac{4!}{32}=\frac{24}{32}=0.75\).
\(\E[1/X]=\frac{\lambda^\alpha}{\Gamma(\alpha)}\int_0^\infty x^{\alpha-2}e^{-\lambda x}\dd x=\frac{\lambda^\alpha}{\Gamma(\alpha)}\cdot\frac{\Gamma(\alpha-1)}{\lambda^{\alpha-1}}=\frac{\lambda}{\alpha-1}\), folosind \(\Gamma(\alpha)=(\alpha-1)\Gamma(\alpha-1)\) (integrala converge pentru \(\alpha>1\)). Observăm că \(\E[1/X]=\frac{\lambda}{\alpha-1}\ne\frac{1}{\E[X]}=\frac\lambda\alpha\).
Fie \(U\sim\Unif(-1,3)\). Calculați \(\PP(|U|<1)\), \(\E[U^2]\) și densitatea lui \(|U|\). (Răspuns: \(1/2\); \(7/3\); \(f(y)=1/2\) pe \((0,1)\) și \(1/4\) pe \((1,3)\).)
Fie \(X\sim\Exp(\lambda)\). Arătați că \(\PP(X>\E[X])=e^{-1}\) pentru orice \(\lambda\) și determinați \(\lambda\) astfel încât mediana să fie \(2\). (Răspuns: \(\lambda=\ln2/2\).)
Fie \(X\sim\Norm(10,4)\). Calculați \(\PP(X>13)\), \(\PP(|X-10|<3)\) și cuantila de ordin \(0.95\). (Răspuns: \(0.0668\); \(0.8664\); \(13.29\).)
Fie \(U\sim\Unif(0,1)\). Determinați densitatea lui \(Y=U^3\) și a lui \(W=-2\ln U\). Recunoașteți repartiția lui \(W\). (Răspuns: \(f_Y(y)=\frac13y^{-2/3}\) pe \((0,1)\); \(W\sim\Exp(1/2)=\chisq{2}\).)
Fie \(\Theta\sim\Unif(-\pi/2,\pi/2)\). Arătați că \(\tan\Theta\) are repartiția Cauchy, folosind formula schimbării de variabilă.
Fie \(X\sim\Exp(\lambda)\) și \(Y=e^X\). Determinați densitatea lui \(Y\) și valorile lui \(\lambda\) pentru care \(\E[Y]<\infty\). (Răspuns: \(f_Y(y)=\lambda y^{-\lambda-1}\), \(y>1\); \(\lambda>1\), \(\E[Y]=\frac{\lambda}{\lambda-1}\).)
Arătați că dacă \(X\sim\GammaD(\alpha,\lambda)\) și \(c>0\), atunci \(cX\sim\GammaD(\alpha,\lambda/c)\). Deduceți că \(2\lambda X\sim\chisq{2n}\) dacă \(X\sim\GammaD(n,\lambda)\).
Folosind metoda inversei, scrieți o funcție R care generează \(n\) valori cu densitatea \(f(x)=3x^2\) pe \((0,1)\) și verificați prin simulare că media este \(3/4\) și varianța \(3/80\).
Bibliografie
Bertsekas, Dimitri P., and John N. Tsitsiklis. 2008. Introduction to Probability. 2nd ed. Athena Scientific.
Blitzstein, Joseph K., and Jessica Hwang. 2019. Introduction to Probability. 2nd ed. CRC Press.
Chan, Stanley H. 2021. Introduction to Probability for Data Science. Michigan Publishing.