Un sistem de recomandare compară notele date de doi utilizatori, un server înregistrează pentru fiecare cerere și timpul de procesare, și dimensiunea răspunsului, un receptor vede semnalul transmis doar împreună cu zgomotul canalului. În toate aceste situații nu ne interesează fiecare mărime în parte, ci legătura dintre ele. Cursul de astăzi studiază mai multe variabile aleatoare simultan — vectorii aleatori — și instrumentele cu care descriem dependența lor: repartiția comună, repartițiile condiționate, media condiționată, covarianța și corelația.
Obiective. La sfârșitul cursului studentul trebuie să poată:
lucra cu repartiția comună a unui vector \((X,Y)\), dată printr-un tabel sau printr-o densitate, și deduce din ea repartițiile marginale și pe cele condiționate;
verifica independența a două variabile aleatoare, inclusiv prin criteriul de factorizare;
aplica formula probabilității totale și formula lui Bayes în cazurile discret, continuu și hibrid;
calcula medii condiționate și folosi legea mediei iterate și legea varianței totale, de exemplu pentru sume cu un număr aleator de termeni;
calcula și interpreta covarianța, coeficientul de corelație și matricea de covarianță a unui vector aleator și determina repartiția unei sume de variabile independente;
reprezenta în R o repartiție comună ca matrice, calcula cov și cor pentru date și simula vectori normali cu o corelație dată.
Structura. Recapitulare; vectori aleatori și funcția de repartiție comună; cazul discret; cazul continuu; medii ale funcțiilor de vectori aleatori și media condiționată; covarianță și corelație (corelația ca un cosinus, repartiția normală bidimensională, matricea de covarianță, simularea vectorilor normali corelați); sume de variabile aleatoare independente; exerciții rezolvate și exerciții propuse. Pentru aprofundare: (Blitzstein and Hwang 2019, cap. 7 și 9), (Bertsekas and Tsitsiklis 2008, cap. 2–4), (Chan 2021, cap. 5).
În cursurile precedente (Cursul 3, Cursul 4, Cursul 5) am studiat variabilele aleatoare individual: o singură mărime numerică asociată unui experiment aleator, descrisă prin funcția de masă, densitatea sau funcția de repartiție. În aplicații însă observăm aproape întotdeauna mai multe mărimi simultan: înălțimea și greutatea unei persoane, numărul de clienți care intră într-un magazin și suma totală cheltuită de aceștia, semnalul transmis pe un canal și semnalul recepționat, duratele de viață ale componentelor unui sistem. Întrebările interesante privesc atunci legătura dintre aceste mărimi: dacă știm valoarea uneia, ce putem spune despre cealaltă? Cât de puternic „variază împreună”?
Dacă \(X\) și \(Y\) sunt două variabile aleatoare definite pe același câmp de probabilitate, cunoașterea repartiției fiecăreia ne permite să calculăm probabilități de tipul \(\PP(X\in A)\) sau \(\PP(Y\in B)\), dar nu și probabilități care implică ambele variabile, cum ar fi \(\PP(X+Y\le 1)\) sau \(\PP(X<Y)\). Pentru acestea trebuie să privim perechea \((X,Y)\) ca un singur obiect, un vector aleator, și să studiem:
repartiția comună a lui \((X,Y)\), care permite calculul probabilităților \(\PP((X,Y)\in C)\), \(C\subseteq\R^2\);
repartițiile marginale, adică repartițiile lui \(X\) și ale lui \(Y\) luate separat (ne interesăm doar de o variabilă, ignorând-o pe cealaltă);
repartițiile condiționate, adică repartiția lui \(X\) știind că \(Y\) a luat o anumită valoare (sau că \(Y\in B\)).
Tratăm mai întâi cazul discret, apoi cazul continuu, introducem media condiționată și cele două formule fundamentale asociate (legea mediei iterate și legea varianței totale), apoi covarianța și coeficientul de corelație, care măsoară dependența liniară dintre două variabile. Încheiem cu sumele de variabile aleatoare independente.
1 Recapitulare
Vectorii aleatori nu cer idei cu totul noi: condiționarea, independența, media și varianța din cursurile precedente sunt transpuse de la evenimente și de la o singură variabilă la perechi de variabile. Reamintim rezultatele pe care le folosim.
Rezultate din Cursurile 2–5 folosite azi
Probabilitatea condiționată\(\PP(A\mid B)=\PP(A\cap B)/\PP(B)\) (Definiția 1 din Cursul 2) și regula înmulțirii \(\PP(A\cap B)=\PP(B)\,\PP(A\mid B)\) (Teorema 3 din Cursul 2): din ele obținem repartițiile condiționate.
Formula probabilității totale\(\PP(A)=\sum_i\PP(A\mid B_i)\PP(B_i)\) pentru o partiție \((B_i)_i\) (Teorema 5 din Cursul 2) și formula lui Bayes (Teorema 7 din Cursul 2): astăzi le scriem pentru funcții de masă și pentru densități.
Independența evenimentelor, \(\PP(A\cap B)=\PP(A)\PP(B)\) (Definiția 8 din Cursul 2), și a variabilelor aleatoare discrete (Definiția 19 din Cursul 3).
Varianța\(\Var(X)=\E[X^2]-(\E[X])^2\) (Definiția 28 din Cursul 3), \(\Var(aX+b)=a^2\Var(X)\) (Teorema 29 din Cursul 3) și varianța sumei a două variabile independente, \(\Var(X+Y)=\Var(X)+\Var(Y)\) (Teorema 30 din Cursul 3).
Variabile continue: densitatea, cu \(\PP(X\in A)=\int_Af(x)\dd x\) (Definiția 1 din Cursul 4), relația \(F'=f\) dintre funcția de repartiție și densitate (Teorema 6 din Cursul 4), media \(\E[X]=\int_{\R}xf(x)\dd x\) (Definiția 8 din Cursul 4) și \(\E[g(X)]=\int_{\R}g(x)f(x)\dd x\) (Teorema 10 din Cursul 4).
Repartiții continue uzuale: \(\Unif(a,b)\), cu media \(\frac{a+b}{2}\) și varianța \(\frac{(b-a)^2}{12}\) (Propoziția 4 din Cursul 5); \(\Exp(\lambda)\), cu media \(\frac1\lambda\) și varianța \(\frac1{\lambda^2}\) (Propoziția 8 din Cursul 5); \(\Norm(\mu,\sigma^2)\) (Definiția 12 din Cursul 5), cu \(\mu+\sigma Z\sim\Norm(\mu,\sigma^2)\) pentru \(Z\sim\Norm(0,1)\) (Propoziția 17 din Cursul 5); \(\GammaD(\alpha,\lambda)\), cu media \(\frac\alpha\lambda\) și varianța \(\frac{\alpha}{\lambda^2}\) (Propoziția 23 din Cursul 5).
2 Vectori aleatori. Funcția de repartiție comună
Definiția 1(Vector aleator)
Fie \((\Omega,\F,\PP)\) un câmp de probabilitate și \(X,Y:\Omega\to\R\) două variabile aleatoare. Aplicația \[
(X,Y):\Omega\to\R^2,\qquad \omega\mapsto \big(X(\omega),Y(\omega)\big)
\] se numește vector aleator (bidimensional) sau cuplu de variabile aleatoare. Analog, pentru \(X_1,\dots,X_n\) variabile aleatoare pe același câmp, \((X_1,\dots,X_n):\Omega\to\R^n\) este un vector aleator \(n\)-dimensional.
Cel mai general obiect care descrie comportamentul comun al lui \(X\) și \(Y\) este funcția de repartiție comună.
Definiția 2(Funcția de repartiție comună)
Funcția de repartiție a vectorului aleator \((X,Y)\) este funcția \(F_{X,Y}:\R^2\to[0,1]\), \[
F_{X,Y}(x,y)=\PP(X\le x,\ Y\le y),\qquad (x,y)\in\R^2,
\] unde virgula desemnează intersecția evenimentelor: \(\{X\le x,\,Y\le y\}=\{X\le x\}\cap\{Y\le y\}\).
Propoziția 3(Proprietăți ale funcției de repartiție comune)
Funcția de repartiție comună \(F=F_{X,Y}\) are următoarele proprietăți:
\(F\) este nedescrescătoare în fiecare argument;
\(\lim_{x\to-\infty}F(x,y)=\lim_{y\to-\infty}F(x,y)=0\) și \(\lim_{x,y\to+\infty}F(x,y)=1\);
funcțiile de repartiție marginale se obțin prin trecere la limită: \(F_X(x)=\lim_{y\to\infty}F(x,y)\), \(F_Y(y)=\lim_{x\to\infty}F(x,y)\);
pentru orice \(a<b\) și \(c<d\), \[
\PP(a<X\le b,\ c<Y\le d)=F(b,d)-F(a,d)-F(b,c)+F(a,c).
\tag{1}\]
Demonstrație. Proprietățile 1–3 rezultă din monotonia și continuitatea măsurii de probabilitate, exact ca în cazul unidimensional (Cursul 3). Pentru 4, notăm \(D=\{X\le b, Y\le d\}\), \(A=\{X\le a, Y\le d\}\), \(C=\{X\le b, Y\le c\}\). Atunci \(\{a<X\le b,\ c<Y\le d\}=D\setminus(A\cup C)\), cu \(A\cup C\subseteq D\), iar \(A\cap C=\{X\le a, Y\le c\}\). Prin urmare \(\PP(a<X\le b, c<Y\le d)=\PP(D)-\PP(A)-\PP(C)+\PP(A\cap C)\), adică relația (1).■
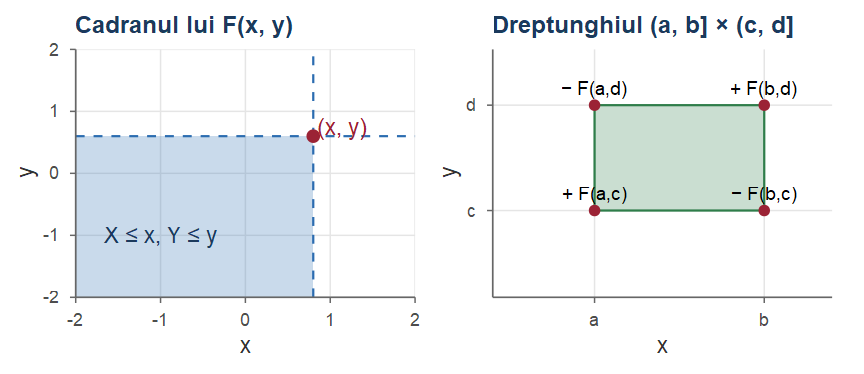
Interpretarea geometrică a funcției de repartiție comune și a relației (1) este ilustrată în Figura 1: \(F_{X,Y}(x,y)\) este probabilitatea ca punctul aleator \((X,Y)\) să cadă în „cadranul” din stânga-jos al punctului \((x,y)\), iar probabilitatea unui dreptunghi se obține prin includere–excludere din patru astfel de cadrane.
Figura 1: Stânga: evenimentul \(\{X\le x, Y\le y\}\) a cărui probabilitate este \(F_{X,Y}(x,y)\). Dreapta: probabilitatea dreptunghiului \((a,b]\times(c,d]\) se obține din valorile lui \(F\) în cele patru colțuri, cu semnele indicate.
3 Cazul discret
În această secțiune \(X\) și \(Y\) sunt variabile aleatoare discrete, cu \(X(\Omega)=\{x_1,x_2,\dots,x_m\}\) și \(Y(\Omega)=\{y_1,y_2,\dots,y_n\}\) (tot ce urmează rămâne valabil și pentru mulțimi numărabile de valori). Atunci cuplul \((X,Y)\) ia valori în mulțimea finită \(\{(x_i,y_j)\mid 1\le i\le m,\ 1\le j\le n\}\).
3.1 Funcția de masă comună și repartițiile marginale
Definiția 4(Funcția de masă comună)
Funcția de masă (repartiția comună) a vectorului aleator discret \((X,Y)\) este \[
p_{X,Y}(x,y)=\PP(X=x,\ Y=y),\qquad (x,y)\in\R^2 .
\] Uneori se folosește și notația \(f_{X,Y}(x,y)=\PP(X=x,Y=y)\).
Funcția de masă comună verifică:
\(p_{X,Y}(x,y)\ge 0\) pentru orice \(x,y\);
\(\displaystyle\sum_{x}\sum_{y}p_{X,Y}(x,y)=1\) (masa totală este 1).
Cunoașterea ei permite calculul probabilității oricărui eveniment legat de \((X,Y)\): pentru \(A\subseteq\R^2\), \[
\PP\big((X,Y)\in A\big)=\sum_{(x,y)\in A}p_{X,Y}(x,y),
\] suma făcându-se după punctele \((x,y)\in A\) care sunt valori posibile ale vectorului. Geometric, ne putem imagina câte o „bețișoară” de înălțime \(p_{X,Y}(x_i,y_j)\) în fiecare nod \((x_i,y_j)\) al unei grile, iar \(\PP((X,Y)\in A)\) este suma înălțimilor bețișoarelor situate deasupra regiunii \(A\).
Repartiția comună se reprezintă sub forma unui tabel cu dublă intrare, în care pe marginile tabelului (ultima coloană și ultima linie) se trec sumele pe linii, respectiv pe coloane: \[
\begin{array}{c|ccccc|c}
X\backslash Y & y_1 & \cdots & y_j & \cdots & y_n & \Sigma\\ \hline
x_1 & p_{X,Y}(x_1,y_1) & \cdots & p_{X,Y}(x_1,y_j) & \cdots & p_{X,Y}(x_1,y_n) & \PP(X=x_1)\\
\vdots & \vdots & & \vdots & & \vdots & \vdots\\
x_i & p_{X,Y}(x_i,y_1) & \cdots & p_{X,Y}(x_i,y_j) & \cdots & p_{X,Y}(x_i,y_n) & \PP(X=x_i)\\
\vdots & \vdots & & \vdots & & \vdots & \vdots\\
x_m & p_{X,Y}(x_m,y_1) & \cdots & p_{X,Y}(x_m,y_j) & \cdots & p_{X,Y}(x_m,y_n) & \PP(X=x_m)\\ \hline
\Sigma & \PP(Y=y_1) & \cdots & \PP(Y=y_j) & \cdots & \PP(Y=y_n) & 1
\end{array}
\] Sumele de pe margini sunt chiar repartițiile lui \(X\) și \(Y\) — de aici și numele de repartiții marginale.
Definiția 5(Repartiții marginale (cazul discret))
Se numește repartiția marginală a lui \(X\) funcția de masă \[
p_X(x)=\PP(X=x)=\sum_{y}\PP(X=x,\ Y=y)=\sum_y p_{X,Y}(x,y).
\] În mod similar, repartiția marginală a lui \(Y\) este \(p_Y(y)=\PP(Y=y)=\sum_{x}p_{X,Y}(x,y)\).
Formula din definiție este o consecință directă a aditivității probabilității. Într-adevăr, evenimentele \(\{Y=y\}\), \(y\in Y(\Omega)\), sunt disjuncte două câte două și au reuniunea \(\Omega\), deci \[
\PP(X=x)=\PP(\{X=x\}\cap\Omega)=\PP\Big(\bigcup_y\{X=x,\,Y=y\}\Big)=\sum_y\PP(X=x,\ Y=y).
\]
Atenție!
Repartiția comună determină repartițiile marginale, dar reciproca este falsă: vectori aleatori cu repartiții comune diferite pot avea aceleași marginale. De exemplu, dacă \(X,Y\sim\Bern(1/2)\), atât repartiția cu \(p_{X,Y}(0,0)=p_{X,Y}(1,1)=1/2\) (adică \(Y=X\)), cât și cea cu \(p_{X,Y}(x,y)=1/4\) pentru toate cele patru perechi au aceleași marginale. Marginalele nu conțin informație despre legătura dintre \(X\) și \(Y\).
3.2 Repartiții condiționate
Fie \(A\in\F\) un eveniment cu \(\PP(A)>0\). Știind că \(A\) s-a realizat, probabilitățile evenimentelor \(\{X=x\}\) se modifică după regula probabilității condiționate (Cursul 2).
Definiția 6(Repartiția condiționată la un eveniment)
Fie \(X\) o variabilă aleatoare discretă și \(A\) un eveniment cu \(\PP(A)>0\). Funcția de masă a lui \(X\) condiționată de \(A\) este \[
p_{X\mid A}(x)=\PP(X=x\mid A)=\frac{\PP(\{X=x\}\cap A)}{\PP(A)}.
\]
Aceasta este într-adevăr o funcție de masă: cum evenimentele \(\{X=x\}\cap A\) sunt disjuncte două câte două, iar reuniunea lor este \(A\), avem \(\PP(A)=\sum_x\PP(\{X=x\}\cap A)\) și, împărțind prin \(\PP(A)>0\), \[
\sum_x p_{X\mid A}(x)=\sum_x\frac{\PP(\{X=x\}\cap A)}{\PP(A)}=1 .
\]
Exemplul 1(Zarul, știind că rezultatul este par)
Fie \(X\) rezultatul aruncării unui zar echilibrat și \(A\) evenimentul „rezultatul este par”, \(\PP(A)=1/2\). Pentru \(x\in\{1,\dots,6\}\), \[
p_{X\mid A}(x)=\frac{\PP(X=x,\ \text{par})}{\PP(\text{par})}=
\begin{cases}\dfrac{1/6}{1/2}=\dfrac13, & x\in\{2,4,6\},\\[2mm] 0, & x\in\{1,3,5\}.\end{cases}
\] Așadar \(X\mid A\) este uniform repartizată pe \(\{2,4,6\}\).
Cel mai important caz particular este \(A=\{Y=y\}\), unde \(Y\) este o altă variabilă aleatoare discretă.
Definiția 7(Repartiția condiționată a lui X la Y=y)
Fie \(X,Y\) variabile aleatoare discrete și \(y\) cu \(p_Y(y)=\PP(Y=y)>0\). Funcția de masă condiționată a lui \(X\) la \(Y=y\) este \[
p_{X\mid Y}(x\mid y)=\PP(X=x\mid Y=y)=\frac{\PP(X=x,\ Y=y)}{\PP(Y=y)}=\frac{p_{X,Y}(x,y)}{p_Y(y)} .
\tag{2}\] Analog, \(p_{Y\mid X}(y\mid x)=p_{X,Y}(x,y)/p_X(x)\) pentru \(p_X(x)>0\).
Pentru \(y\) fixat, \(p_{X\mid Y}(\cdot\mid y)\) este o funcție de \(x\): se obține luând coloana \(y\) a tabelului repartiției comune și normalizând-o (împărțind la suma ei, \(p_Y(y)\)), astfel încât suma să devină 1. Forma coloanei se păstrează; doar scara se schimbă.
Din (2) rezultă regula de înmulțire\[
p_{X,Y}(x,y)=p_X(x)\,p_{Y\mid X}(y\mid x)=p_Y(y)\,p_{X\mid Y}(x\mid y),
\tag{3}\] analogul relației \(\PP(A\cap B)=\PP(A)\PP(B\mid A)=\PP(B)\PP(A\mid B)\) pentru \(A=\{X=x\}\), \(B=\{Y=y\}\). Această relație este foarte utilă atunci când modelul este descris „în etape”: se cunoaște repartiția lui \(X\) și, pentru fiecare valoare a lui \(X\), repartiția lui \(Y\).
Propoziția 8(Formula probabilității totale și formula lui Bayes (cazul discret))
Fie \(X,Y\) variabile aleatoare discrete.
Dacă \(A_1,\dots,A_n\) formează o partiție a lui \(\Omega\) cu \(\PP(A_i)>0\), atunci \(p_X(x)=\sum_{i=1}^n p_{X\mid A_i}(x)\,\PP(A_i)\). În particular, pentru \(A_j=\{Y=y_j\}\), \[
p_X(x)=\sum_y p_{X\mid Y}(x\mid y)\,p_Y(y).
\]
(Formula lui Bayes) Pentru \(p_Y(y)>0\), \[
p_{X\mid Y}(x\mid y)=\frac{p_X(x)\,p_{Y\mid X}(y\mid x)}{p_Y(y)}=\frac{p_X(x)\,p_{Y\mid X}(y\mid x)}{\sum_{x'}p_X(x')\,p_{Y\mid X}(y\mid x')} .
\]
Demonstrație.
este formula probabilității totale \(\PP(B)=\sum_i\PP(B\mid A_i)\PP(A_i)\) aplicată evenimentului \(B=\{X=x\}\). (ii) Din regula de înmulțire (3), \(p_{X\mid Y}(x\mid y)=p_{X,Y}(x,y)/p_Y(y)=p_X(x)p_{Y\mid X}(y\mid x)/p_Y(y)\), iar numitorul se scrie cu (i), cu rolurile lui \(X\) și \(Y\) inversate.
■
Exemplul 2(Profesorul și întrebările studenților)
Presupunem că un profesor răspunde incorect în \(25\%\) din cazuri, independent de la o întrebare la alta, și că pe parcursul unui curs poate primi \(0\), \(1\) sau \(2\) întrebări, fiecare variantă cu probabilitatea \(1/3\). Fie \(X\) numărul de întrebări și \(Y\) numărul de răspunsuri greșite. Determinăm repartiția comună a lui \((X,Y)\), cu \(X(\Omega)=Y(\Omega)=\{0,1,2\}\).
Modelul este dat „în etape”: \(X\) este uniformă pe \(\{0,1,2\}\), iar știind \(X=x\), numărul de greșeli este binomial, \(Y\mid X=x\sim\Bin(x,1/4)\). Cu regula de înmulțire: \[
\begin{aligned}
\PP(X=0,Y=0)&=\tfrac13, & \PP(X=1,Y=0)&=\tfrac13\cdot\tfrac34=\tfrac14,\\
\PP(X=1,Y=1)&=\tfrac13\cdot\tfrac14=\tfrac1{12}, & \PP(X=2,Y=0)&=\tfrac13\big(\tfrac34\big)^2=\tfrac3{16},\\
\PP(X=2,Y=1)&=\tfrac13\tbinom21\tfrac14\cdot\tfrac34=\tfrac18, & \PP(X=2,Y=2)&=\tfrac13\big(\tfrac14\big)^2=\tfrac1{48},
\end{aligned}
\] iar celelalte probabilități sunt nule (\(Y\le X\)). Tabelul repartiției comune este \[
\begin{array}{c|ccc|c}
X\backslash Y & 0 & 1 & 2 & \Sigma\\ \hline
0 & 1/3 & 0 & 0 & 1/3\\
1 & 1/4 & 1/12 & 0 & 1/3\\
2 & 3/16 & 1/8 & 1/48 & 1/3\\ \hline
\Sigma & 37/48 & 5/24 & 1/48 & 1
\end{array}
\] Marginala lui \(Y\) se obține cu formula probabilității totale: de exemplu \(\PP(Y=0)=\frac13+\frac14+\frac3{16}=\frac{37}{48}\). Cu formula lui Bayes putem răspunde la întrebări „inverse”: știind că profesorul nu a greșit niciodată la un curs, probabilitatea să nu fi primit nicio întrebare este \(\PP(X=0\mid Y=0)=\frac{1/3}{37/48}=\frac{16}{37}\approx 0.43\).
Variabilele aleatoare discrete \(X\) și \(Y\) sunt independente, și notăm \(X\indep Y\), dacă \[
p_{X,Y}(x,y)=p_X(x)\,p_Y(y)\qquad\text{pentru orice }x,y,
\] adică evenimentele \(\{X=x\}\) și \(\{Y=y\}\) sunt independente pentru orice \(x,y\). Echivalent, \(p_{X\mid Y}(x\mid y)=p_X(x)\) pentru orice \(y\) cu \(p_Y(y)>0\): informația despre \(Y\) nu modifică repartiția lui \(X\).
În exemplul profesorului, \(X\) și \(Y\)nu sunt independente: \(\PP(X=0,Y=1)=0\ne\frac13\cdot\frac5{24}\). În tabel, independența înseamnă că fiecare celulă este produsul marginalelor corespunzătoare; o singură celulă nulă cu marginale nenule este suficientă pentru a infirma independența.
Exemplul 3(Găina și ouăle: descompunerea unei variabile Poisson)
O găină depune un număr aleator \(N\sim\Pois(\lambda)\) de ouă. Presupunem că fiecare ou eclozează cu probabilitatea \(p\in(0,1)\), independent de celelalte ouă. Fie \(X\) numărul de ouă care au eclozat și \(Y\) numărul de ouă care nu au eclozat, deci \(N=X+Y\). Vrem să determinăm repartiția comună a lui \((X,Y)\).
Din ipoteză, \(\PP(N=n)=e^{-\lambda}\lambda^n/n!\) și, știind \(N=n\), \(X\mid N=n\sim\Bin(n,p)\) (ouăle eclozează independent), iar \(Y\mid N=n\sim\Bin(n,1-p)\). Cu formula probabilității totale, pentru \(i,j\ge0\), \[
\PP(X=i,Y=j)=\sum_{n=0}^\infty \PP(X=i,Y=j\mid N=n)\,\PP(N=n).
\] Dacă \(n\ne i+j\), atunci \(\PP(X=i,Y=j\mid N=n)=0\), deci suma se reduce la termenul \(n=i+j\). În plus, știind \(N=i+j\), evenimentul \(\{X=i\}\) implică \(\{Y=j\}\), deci \(\PP(X=i,Y=j\mid N=i+j)=\PP(X=i\mid N=i+j)\). Obținem \[
\begin{aligned}
\PP(X=i,Y=j)&=\binom{i+j}{i}p^i(1-p)^j\cdot e^{-\lambda}\frac{\lambda^{i+j}}{(i+j)!}
=\frac{p^i(1-p)^j}{i!\,j!}\,e^{-\lambda}\lambda^i\lambda^j\\
&=e^{-\lambda p}\frac{(\lambda p)^i}{i!}\cdot e^{-\lambda(1-p)}\frac{(\lambda(1-p))^j}{j!},
\end{aligned}
\] unde am folosit \(\lambda=\lambda p+\lambda(1-p)\). Sumând după \(j\ge0\) găsim marginala lui \(X\): \[
\PP(X=i)=e^{-\lambda p}\frac{(\lambda p)^i}{i!}\sum_{j\ge0}e^{-\lambda(1-p)}\frac{(\lambda(1-p))^j}{j!}=e^{-\lambda p}\frac{(\lambda p)^i}{i!},
\] adică \(X\sim\Pois(\lambda p)\) și, analog, \(Y\sim\Pois(\lambda(1-p))\). Mai mult, \(\PP(X=i,Y=j)=\PP(X=i)\PP(Y=j)\) pentru orice \(i,j\), deci \(X\) și \(Y\) sunt independente — un rezultat deloc intuitiv, deoarece \(X+Y=N\).
Rezultatul din Exemplul 3 este cunoscut sub numele de descompunerea (subțierea) repartiției Poisson: dacă fiecare dintre cele \(N\sim\Pois(\lambda)\) „sosiri” este marcată independent cu probabilitatea \(p\), numerele de sosiri marcate și nemarcate sunt variabile Poisson independente, de parametri \(\lambda p\) și \(\lambda(1-p)\). Proprietatea inversă (suma a două variabile Poisson independente este tot Poisson) o vom demonstra în Secțiunea 7.
3.3 Media unei funcții de două variabile aleatoare discrete
Fie \(g:\R^2\to\R\) și \(Z=g(X,Y)\); de exemplu \(g(x,y)=3x+7y\), \(g(x,y)=xy\) sau \(g(x,y)=\max(x,y)\). Pentru a calcula \(\E[Z]\) nu este necesar să determinăm repartiția lui \(Z\): ca în cazul unidimensional (formula de transport din Cursul 3), putem folosi direct repartiția comună.
Teorema 10(Media unei funcții de un vector aleator discret)
Dacă \(X\) și \(Y\) sunt variabile aleatoare discrete și \(g:\R^2\to\R\), atunci (când seria converge absolut) \[
\E[g(X,Y)]=\sum_x\sum_y g(x,y)\,p_{X,Y}(x,y).
\] În particular, media este liniară: \(\E[aX+bY]=a\E[X]+b\E[Y]\) pentru orice \(a,b\in\R\).
Demonstrație. Grupând termenii după valorile \(z\) ale lui \(Z=g(X,Y)\), \(\sum_{x,y}g(x,y)p_{X,Y}(x,y)=\sum_z z\sum_{(x,y):\,g(x,y)=z}p_{X,Y}(x,y)=\sum_z z\,\PP(Z=z)=\E[Z]\). Pentru liniaritate luăm \(g(x,y)=ax+by\): \(\sum_{x,y}(ax+by)p_{X,Y}(x,y)=a\sum_x x\sum_y p_{X,Y}(x,y)+b\sum_y y\sum_x p_{X,Y}(x,y)=a\sum_x x\,p_X(x)+b\sum_y y\,p_Y(y)\).■
Exemplul 4(Un tabel de repartiție comună)
Considerăm vectorul \((X,Y)\) cu repartiția comună din tabelul de mai jos; marginalele sunt trecute pe margini. \[
\begin{array}{c|ccc|c}
X\backslash Y & -1 & 0 & 2 & \Sigma\\ \hline
1 & 1/18 & 3/18 & 2/18 & 6/18\\
2 & 2/18 & 0 & 3/18 & 5/18\\
3 & 0 & 4/18 & 3/18 & 7/18\\ \hline
\Sigma & 3/18 & 7/18 & 8/18 & 1
\end{array}
\] Vrem să determinăm repartițiile marginale, repartițiile condiționate \(X\mid Y=0\) și \(Y\mid X=1\) și să calculăm \(\E[XY]\) și \(\E[3X+2Y]\).
Marginalele (sumele pe linii, respectiv pe coloane): \[
X\sim\begin{pmatrix}1&2&3\\ \frac6{18}&\frac5{18}&\frac7{18}\end{pmatrix},\qquad
Y\sim\begin{pmatrix}-1&0&2\\ \frac3{18}&\frac7{18}&\frac8{18}\end{pmatrix}.
\]Condiționatele. Pentru \(X\mid Y=0\) normalizăm coloana \(y=0\): \(p_{X\mid Y}(x\mid 0)=p_{X,Y}(x,0)/\frac7{18}\), iar pentru \(Y\mid X=1\) normalizăm linia \(x=1\): \[
X\mid Y=0\sim\begin{pmatrix}1&2&3\\ \frac37&0&\frac47\end{pmatrix},\qquad
Y\mid X=1\sim\begin{pmatrix}-1&0&2\\ \frac16&\frac36&\frac26\end{pmatrix}.
\]Medii. Cu Teorema 10, \[
\E[XY]=1\cdot(-1)\cdot\tfrac1{18}+1\cdot2\cdot\tfrac2{18}+2\cdot(-1)\cdot\tfrac2{18}+2\cdot2\cdot\tfrac3{18}+3\cdot2\cdot\tfrac3{18}=\tfrac{-1+4-4+12+18}{18}=\tfrac{29}{18}
\] (termenii cu \(y=0\) sau cu probabilitate nulă lipsesc). Pentru \(\E[3X+2Y]\) putem determina repartiția lui \(Z=3X+2Y\), calculând valoarea lui \(3x+2y\) în fiecare celulă nenulă: \[
3X+2Y\sim\begin{pmatrix}1&3&4&7&9&10&13\\ \frac1{18}&\frac3{18}&\frac2{18}&\frac2{18}&\frac4{18}&\frac3{18}&\frac3{18}\end{pmatrix},
\] deci \(\E[3X+2Y]=\frac{1+9+8+14+36+30+39}{18}=\frac{137}{18}\), sau, mult mai simplu, prin liniaritate: \(\E[X]=\frac{6+10+21}{18}=\frac{37}{18}\), \(\E[Y]=\frac{-3+16}{18}=\frac{13}{18}\) și \(\E[3X+2Y]=3\cdot\frac{37}{18}+2\cdot\frac{13}{18}=\frac{137}{18}\).
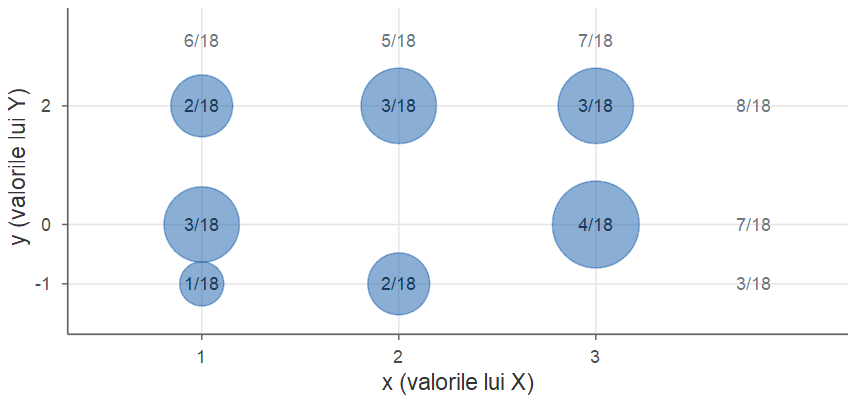
Calculele din Exemplul 4 se verifică ușor în R, reprezentând repartiția comună ca matrice; repartiția este ilustrată în Figura 2.
Figura 2: Repartiția comună din Exemplul 4: aria fiecărui disc este proporțională cu \(p_{X,Y}(x,y)\). Sumele pe linii și pe coloane (în gri) sunt repartițiile marginale.
3.4 Media condiționată (cazul discret)
Odată ce am determinat repartiția condiționată a lui \(X\) (la un eveniment sau la \(Y=y\)), media ei se numește medie condiționată.
Definiția 11(Media condiționată (cazul discret))
Fie \(X\) o variabilă aleatoare discretă și \(A\in\F\) cu \(\PP(A)>0\). Media condiționată a lui \(X\) la \(A\) este \[
\E[X\mid A]=\sum_x x\,p_{X\mid A}(x),
\] iar pentru o funcție \(g\), \(\E[g(X)\mid A]=\sum_x g(x)\,p_{X\mid A}(x)\). În particular, pentru \(A=\{Y=y\}\) obținem media condiționată a lui \(X\) la \(Y=y\): \[
\E[X\mid Y=y]=\sum_x x\,p_{X\mid Y}(x\mid y).
\]
Exemplul 5(Medii condiționate pentru tabelul din exemplul anterior)
În Exemplul 4 am văzut că \(X\mid Y=0\sim\begin{pmatrix}1&2&3\\ 3/7&0&4/7\end{pmatrix}\), deci \(\E[X\mid Y=0]=1\cdot\frac37+2\cdot 0+3\cdot\frac47=\frac{15}7\), iar din \(Y\mid X=1\sim\begin{pmatrix}-1&0&2\\ 1/6&3/6&2/6\end{pmatrix}\) rezultă \(\E[Y\mid X=1]=-\frac16+\frac46=\frac12\). Procedând la fel pentru celelalte valori ale lui \(Y\): \[
X\mid Y=-1\sim\begin{pmatrix}1&2&3\\ \frac13&\frac23&0\end{pmatrix},\qquad
X\mid Y=2\sim\begin{pmatrix}1&2&3\\ \frac28&\frac38&\frac38\end{pmatrix},
\] deci \(\E[X\mid Y=-1]=\frac53\) și \(\E[X\mid Y=2]=\frac{17}8\). Media condiționată \(\E[X\mid Y=y]\) este deci o funcție de \(y\), \(g(y)=\E[X\mid Y=y]\). Dacă în locul lui \(y\) punem variabila aleatoare \(Y\), obținem o nouă variabilă aleatoare, \(g(Y)\), care ia valoarea \(g(y)\) cu probabilitatea \(\PP(Y=y)\): \[
\E[X\mid Y]=g(Y)\sim\begin{pmatrix}\frac53&\frac{15}7&\frac{17}8\\[1mm] \frac3{18}&\frac7{18}&\frac8{18}\end{pmatrix}.
\] Observăm că \(\E\big[\E[X\mid Y]\big]=\frac53\cdot\frac3{18}+\frac{15}7\cdot\frac7{18}+\frac{17}8\cdot\frac8{18}=\frac{5+15+17}{18}=\frac{37}{18}=\E[X]\). Nu este o coincidență, după cum arată propoziția următoare.
Propoziția 12(Formula probabilității totale pentru medii (cazul discret))
Dacă \(X\) și \(Y\) sunt variabile aleatoare discrete (și \(\E|X|<\infty\)), atunci \[
\E[X]=\sum_y\E[X\mid Y=y]\,\PP(Y=y).
\]
În mod analog se definește varianța condiționată, ca varianța repartiției condiționate: \[
\begin{aligned}
\Var(X\mid A)&=\E\big[(X-\E[X\mid A])^2\mid A\big]=\E[X^2\mid A]-\big(\E[X\mid A]\big)^2,\\
\Var(X\mid Y=y)&=\E[X^2\mid Y=y]-\big(\E[X\mid Y=y]\big)^2 .
\end{aligned}
\] Vom reveni asupra mediei și varianței condiționate, în cadrul general, în Secțiunea 5.
4 Cazul continuu
4.1 Densitatea comună
În cazul continuu, rolul funcției de masă comune este preluat de o densitate în plan: probabilitățile nu mai sunt sume de „bețișoare”, ci volume de sub o suprafață.
Definiția 13(Densitatea comună)
Fie \(X\) și \(Y\) două variabile aleatoare pe \((\Omega,\F,\PP)\). Spunem că perechea \((X,Y)\) formează un cuplu de variabile aleatoare continue (absolut continue) dacă există o funcție \(f_{X,Y}:\R^2\to[0,\infty)\) astfel încât \[
\PP\big((X,Y)\in A\big)=\iint_A f_{X,Y}(x,y)\dd x\dd y\qquad\text{pentru orice } A\subseteq\R^2 \text{ (boreliană)}.
\] Funcția \(f_{X,Y}\) se numește densitatea comună a lui \((X,Y)\).
Două cazuri particulare sunt esențiale. Pentru un dreptunghi \(A=[a,b]\times[c,d]\), \[
\PP(a\le X\le b,\ c\le Y\le d)=\int_a^b\int_c^d f_{X,Y}(x,y)\dd y\dd x,
\] iar pentru \(A=\R^2\) obținem condiția de normalizare \[
\int_{-\infty}^{+\infty}\int_{-\infty}^{+\infty}f_{X,Y}(x,y)\dd x\dd y=1 .
\] Reciproc, orice funcție \(f\ge0\) cu integrala pe \(\R^2\) egală cu 1 este densitatea unui vector aleator.
Interpretare. Pentru un dreptunghi mic \([x,x+\mathrm{d}x]\times[y,y+\mathrm{d}y]\), \[
\PP\big(X\in[x,x+\mathrm{d}x],\ Y\in[y,y+\mathrm{d}y]\big)=\int_x^{x+\mathrm{d}x}\int_y^{y+\mathrm{d}y}f_{X,Y}(u,v)\dd v\dd u\approx f_{X,Y}(x,y)\,\mathrm{d}x\,\mathrm{d}y ,
\] deci \(f_{X,Y}(x,y)\) este probabilitatea pe unitatea de arie în jurul punctului \((x,y)\). Ca și în cazul unidimensional, \(f_{X,Y}(x,y)\) nu este o probabilitate și poate depăși valoarea 1. Densitatea comună conține toată informația despre \(X\) și \(Y\): cunoașterea ei permite calculul oricărei probabilități \(\PP((X,Y)\in A)\). Analogia cu cazul discret este: \(\sum\ \to\ \int\) și \(p_{X,Y}(x,y)\ \to\ f_{X,Y}(x,y)\dd x\dd y\).
Propoziția 14(Densitățile marginale)
Dacă \((X,Y)\) are densitatea comună \(f_{X,Y}\), atunci \(X\) și \(Y\) sunt variabile aleatoare continue, cu densitățile (numite densități marginale) \[
f_X(x)=\int_{\R}f_{X,Y}(x,y)\dd y,\qquad f_Y(y)=\int_{\R}f_{X,Y}(x,y)\dd x .
\]
Demonstrație. Pentru \(B\subseteq\R\), evenimentul \(\{X\in B\}\) coincide cu \(\{(X,Y)\in B\times\R\}\) (banda verticală deasupra lui \(B\)). Prin urmare \[
\PP(X\in B)=\PP\big((X,Y)\in B\times\R\big)=\iint_{B\times\R}f_{X,Y}(x,y)\dd y\dd x=\int_B\Big(\int_{\R} f_{X,Y}(x,y)\dd y\Big)\dd x .
\] Cum aceasta are loc pentru orice \(B\), prin identificare cu \(\PP(X\in B)=\int_B f_X(x)\dd x\) rezultă formula pentru \(f_X\). Pentru \(f_Y\) raționamentul este analog.■
Funcția de repartiție comună (Definiția 2) se exprimă prin densitate ca \[
F_{X,Y}(x,y)=\PP(X\le x,\ Y\le y)=\int_{-\infty}^{x}\int_{-\infty}^{y}f_{X,Y}(u,v)\dd v\dd u ,
\] iar reciproc, în punctele de continuitate ale lui \(f_{X,Y}\), densitatea se obține prin derivare parțială mixtă: \[
f_{X,Y}(x,y)=\frac{\partial^2 F_{X,Y}}{\partial x\,\partial y}(x,y).
\]
4.2 Repartiția uniformă pe o mulțime din plan
Exemplul 6(Întâlnirea lui Ionel cu Maria)
Ionel și Maria își dau întâlnire la ora 12 și ajung la locul de întâlnire cu întârzieri aleatoare, cuprinse între 0 și 1 oră. Notăm cu \(X\) și \(Y\) întârzierea lui Ionel, respectiv a Mariei, și presupunem că perechea \((X,Y)\) este „aleasă la întâmplare” în pătratul \([0,1]^2\), adică are densitatea constantă \[
f_{X,Y}(x,y)=\begin{cases}c,&(x,y)\in[0,1]^2,\\ 0,&\text{altfel.}\end{cases}
\] Din \(f_{X,Y}\ge0\) rezultă \(c\ge0\), iar din normalizare \(\int_0^1\int_0^1c\dd x\dd y=c=1\). Densitățile marginale sunt \(f_X(x)=\int_0^1 1\dd y=1\) pentru \(x\in[0,1]\), deci \(X\sim\Unif(0,1)\) și, analog, \(Y\sim\Unif(0,1)\).
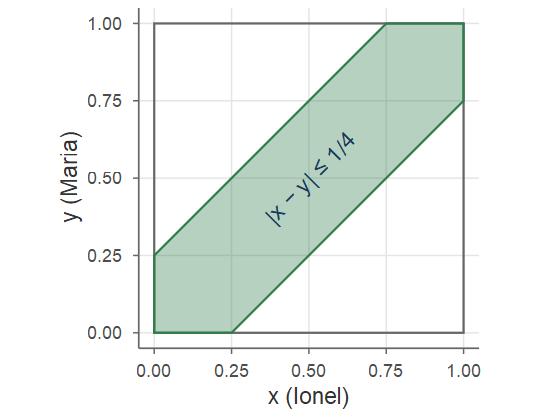
Dacă fiecare îl așteaptă pe celălalt cel mult un sfert de oră, ei se întâlnesc dacă \(|X-Y|\le 1/4\). Regiunea corespunzătoare (Figura 3) este pătratul unitate din care lipsesc două triunghiuri dreptunghice isoscele cu catetele \(3/4\), deci \[
\PP\big(|X-Y|\le\tfrac14\big)=1-2\cdot\frac12\Big(\frac34\Big)^2=1-\frac9{16}=\frac7{16}=0.4375 .
\]
Arată codul R
banda <-data.frame(x =c(0, 1/4, 1, 1, 3/4, 0), y =c(0, 0, 3/4, 1, 1, 1/4))ggplot() +annotate("rect", xmin =0, xmax =1, ymin =0, ymax =1, fill =NA, colour ="grey40") +geom_polygon(data = banda, aes(x, y), fill = culori[["verde"]], alpha =0.35,colour = culori[["verde"]]) +annotate("text", x =0.5, y =0.5, label ="|x − y| ≤ 1/4", angle =45,colour = culori[["bleumarin"]]) +coord_equal() +labs(x ="x (Ionel)", y ="y (Maria)")
Figura 3: Problema întâlnirii (Exemplul 6): pentru \((X,Y)\) uniform în pătratul unitate, probabilitatea întâlnirii este aria benzii \(|x-y|\le 1/4\).
În exemplul de mai sus nu am folosit nimic specific pătratului: ideea de a alege „la întâmplare” un punct dintr-o regiune se formalizează astfel.
Definiția 15(Repartiția uniformă pe o mulțime din plan)
Fie \(S\subseteq\R^2\) o mulțime (triunghi, dreptunghi, disc etc.) cu arie finită și nenulă. Spunem că vectorul \((X,Y)\) este repartizat uniform pe \(S\), și scriem \((X,Y)\sim\Unif(S)\), dacă are densitatea \[
f_{X,Y}(x,y)=\begin{cases}\dfrac{1}{\mathrm{Aria}(S)},&(x,y)\in S,\\[2mm] 0,&\text{altfel,}\end{cases}\qquad\text{adică } f_{X,Y}=\frac{1}{\mathrm{Aria}(S)}\Ind_S .
\]
Constanta rezultă din normalizare: dacă \(f_{X,Y}=c\,\Ind_S\), atunci \(1=\iint_{\R^2}c\,\Ind_S(x,y)\dd x\dd y=c\iint_S 1\dd x\dd y=c\cdot\mathrm{Aria}(S)\). Probabilitățile sunt rapoarte de arii: \[
\PP\big((X,Y)\in A\big)=\frac{1}{\mathrm{Aria}(S)}\iint_A\Ind_S(x,y)\dd x\dd y=\frac{\mathrm{Aria}(A\cap S)}{\mathrm{Aria}(S)},
\] ceea ce corespunde modelului geometric de probabilitate.
Exemplul 7(Problema acului lui Buffon)
O suprafață este marcată cu linii paralele aflate la distanța \(d\) una de cealaltă. Aruncăm la întâmplare un ac de lungime \(l\le d\). Care este probabilitatea ca acul să intersecteze una dintre linii?
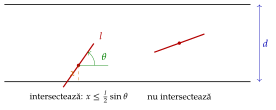
Poziția acului poate fi descrisă (vezi desenul de mai jos) prin două mărimi:
\(\Theta\), unghiul ascuțit format de axa acului cu dreptele paralele, \(\Theta\in[0,\pi/2]\);
\(X\), distanța de la mijlocul acului la cea mai apropiată dreaptă, \(X\in[0,d/2]\).
Faptul că acul este aruncat „la întâmplare” se traduce prin ipoteza \((X,\Theta)\sim\Unif(S)\), unde \(S=[0,d/2]\times[0,\pi/2]\), deci \(f_{X,\Theta}(x,\theta)=\frac{1}{(d/2)(\pi/2)}=\frac{4}{\pi d}\) pe \(S\). Pentru \(\theta\) fixat, jumătatea de ac dinspre cea mai apropiată dreaptă are proiecția pe direcția perpendiculară pe drepte egală cu \(\frac l2\sin\theta\), deci acul intersectează o dreaptă dacă și numai dacă \[
X\le\frac l2\sin\Theta .
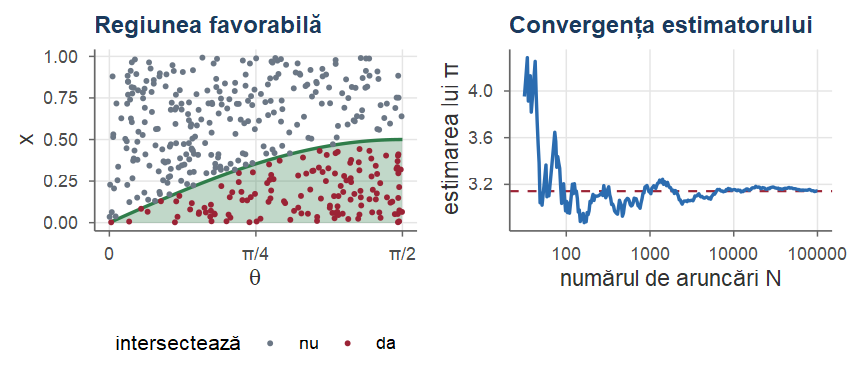
\] Notând \(B=\{(x,\theta)\in S\mid x\le\frac l2\sin\theta\}\) (regiunea de sub sinusoidă din Figura 4, stânga), obținem \[
\PP\Big(X\le\frac l2\sin\Theta\Big)=\iint_B\frac{4}{\pi d}\dd x\dd\theta=\frac4{\pi d}\int_0^{\pi/2}\int_0^{\frac l2\sin\theta}\dd x\dd\theta=\frac{4}{\pi d}\int_0^{\pi/2}\frac l2\sin\theta\dd\theta=\frac{2l}{\pi d}.
\] Rezultatul oferă o metodă experimentală (Monte Carlo) de estimare a lui \(\pi\): dacă din \(N\) aruncări \(n\) intersectează o linie, atunci \(\frac nN\approx\frac{2l}{\pi d}\), deci \(\pi\approx\frac{2lN}{nd}\).
Simularea din Figura 4 (dreapta) arată cum estimatorul \(\hat\pi_N=2lN/(n d)\) se apropie de \(\pi\) pe măsură ce numărul de aruncări crește; convergența este însă lentă (vom vedea în Cursul 7 de ce eroarea este de ordinul \(1/\sqrt N\)).
set.seed(1777) # anul în care Buffon a publicat problemaN <-1e5; l <-1; d <-2theta <-runif(N, 0, pi /2) # unghiul aculuixb <-runif(N, 0, d /2) # distanța mijloc – linia cea mai apropiatătaie <- xb <= l /2*sin(theta) # acul intersectează o linie?c(p_simulat =mean(taie), p_teoretic =2* l / (pi * d),pi_estimat =2* l * N / (d *sum(taie)))
th <-seq(0, pi /2, length.out =200)pb <-data.frame(theta = theta[1:400], x = xb[1:400], taie = taie[1:400])p1 <-ggplot() +geom_area(data =data.frame(th, h = l /2*sin(th)), aes(th, h),fill = culori[["verde"]], alpha =0.3) +geom_line(data =data.frame(th, h = l /2*sin(th)), aes(th, h), colour = culori[["verde"]]) +geom_point(data = pb, aes(theta, x, colour = taie), size =0.7) +scale_colour_manual(values =c(culori[["gri"]], culori[["rosu"]]),labels =c("nu", "da"), name ="intersectează") +scale_x_continuous(breaks =c(0, pi /4, pi /2), labels =c("0", "π/4", "π/2")) +labs(x =expression(theta), y ="x", title ="Regiunea favorabilă")nn <-10^seq(1.5, 5, length.out =300)est <-2* l * nn / (d *cumsum(taie)[round(nn)])p2 <-ggplot(data.frame(n = nn, est = est), aes(n, est)) +geom_hline(yintercept = pi, linetype =2, colour = culori[["rosu"]]) +geom_line() +scale_x_log10() +labs(x ="numărul de aruncări N", y ="estimarea lui π", title ="Convergența estimatorului")p1 + p2
Figura 4: Acul lui Buffon (\(l=1\), \(d=2\)). Stânga: dreptunghiul \(S\) al pozițiilor posibile și regiunea favorabilă \(B=\{x\le \frac{l}{2}\sin\theta\}\), cu 400 de aruncări simulate. Dreapta: estimarea lui \(\pi\) în funcție de numărul de aruncări (scară logaritmică).
4.3 Densități condiționate
Începem, ca în cazul discret, cu condiționarea la un eveniment.
Definiția 16(Densitatea condiționată la un eveniment)
Fie \(X\) o variabilă aleatoare continuă și \(A\in\F\) cu \(\PP(A)>0\). Numim densitatea condiționată a lui \(X\) la \(A\) funcția \(f_{X\mid A}\ge0\) care verifică \[
\PP(X\in B\mid A)=\int_B f_{X\mid A}(x)\dd x\qquad\text{pentru orice } B\subseteq\R .
\] Pentru \(B=\R\) obținem \(\int_{\R} f_{X\mid A}(x)\dd x=\PP(X\in\R\mid A)=1\), deci \(f_{X\mid A}\) este o densitate de probabilitate.
Un caz particular important este cel în care evenimentul se referă chiar la \(X\): \(A=\{X\in C\}\), cu \(\PP(X\in C)>0\). Atunci \[
\PP(X\in B\mid X\in C)=\frac{\PP(X\in B,\ X\in C)}{\PP(X\in C)}=\frac{\int_{B\cap C}f_X(x)\dd x}{\PP(X\in C)}=\int_B\frac{f_X(x)\Ind_C(x)}{\PP(X\in C)}\dd x,
\] și, prin identificare, \[
f_{X\mid\{X\in C\}}(x)=\begin{cases}\dfrac{f_X(x)}{\PP(X\in C)},& x\in C,\\[2mm] 0,&\text{altfel.}\end{cases}
\] Graficul densității condiționate se obține deci „tăind” densitatea lui \(X\) în afara lui \(C\) și renormalizând partea rămasă (înmulțind-o cu \(1/\PP(X\in C)\ge1\)).
Exemplul 8(Uniforma condiționată la un subinterval)
Fie \(X\sim\Unif(a,b)\) și \([c,d]\subseteq[a,b]\). Avem \(f_X(x)=\frac1{b-a}\Ind_{[a,b]}(x)\) și \(\PP(X\in[c,d])=\frac{d-c}{b-a}\), deci \[
f_{X\mid X\in[c,d]}(x)=\frac{\frac1{b-a}\Ind_{[a,b]}(x)}{\frac{d-c}{b-a}}\,\Ind_{[c,d]}(x)=\frac{1}{d-c}\Ind_{[c,d]}(x),
\] adică \(X\mid\{X\in[c,d]\}\sim\Unif(c,d)\): condiționată la un subinterval, o variabilă uniformă rămâne uniformă.
Propoziția 17(Formula probabilității totale pentru densități)
Fie \(A_1,\dots,A_n\) evenimente care formează o partiție a lui \(\Omega\), cu \(\PP(A_i)>0\), și \(X\) o variabilă aleatoare continuă astfel încât fiecare \(X\mid A_i\) are densitatea \(f_{X\mid A_i}\). Atunci \[
f_X(x)=\sum_{i=1}^n f_{X\mid A_i}(x)\,\PP(A_i).
\]
Demonstrație. Aplicăm formula probabilității totale evenimentului \(\{X\le x\}\): \[
\int_{-\infty}^x f_X(t)\dd t=\PP(X\le x)=\sum_{i=1}^n\PP(X\le x\mid A_i)\PP(A_i)=\sum_{i=1}^n\PP(A_i)\int_{-\infty}^x f_{X\mid A_i}(t)\dd t .
\] Derivând în raport cu \(x\) ambii membri, obținem \(f_X(x)=\sum_i f_{X\mid A_i}(x)\PP(A_i)\).■
Exemplul 9(Timpul de așteptare la metrou)
Metroul circulă la intervale de 15 minute, cu trenuri la \(7^{00}\), \(7^{15}\), \(7^{30}\) etc. Presupunem că ajungem în stație la un moment \(X\) uniform repartizat între \(7^{10}\) și \(7^{30}\). Vrem să determinăm densitatea timpului de așteptare \(Y\) (în minute) până la sosirea primului metrou.
Considerăm partiția \(A=\{7^{10}\le X\le 7^{15}\}\) („urcăm în metroul de la \(7^{15}\)”) și \(B=\{7^{15}<X\le 7^{30}\}\) („urcăm în metroul de la \(7^{30}\)”), cu \(\PP(A)=\frac5{20}=\frac14\) și \(\PP(B)=\frac{15}{20}=\frac34\). Știind că \(A\) s-a realizat, momentul sosirii este uniform pe \([7^{10},7^{15}]\) (Exemplul 8), deci timpul de așteptare \(Y=7^{15}-X\) este uniform pe \([0,5]\): \(f_{Y\mid A}(y)=\frac15\Ind_{[0,5]}(y)\). Analog, pe \(B\), \(Y=7^{30}-X\sim\Unif(0,15)\), \(f_{Y\mid B}(y)=\frac1{15}\Ind_{[0,15]}(y)\). Cu Propoziția 17, \[
f_Y(y)=f_{Y\mid A}(y)\PP(A)+f_{Y\mid B}(y)\PP(B)=\frac15\Ind_{[0,5]}(y)\cdot\frac14+\frac1{15}\Ind_{[0,15]}(y)\cdot\frac34=
\begin{cases}\frac1{10},&0\le y\le5,\\[1mm] \frac1{20},&5<y\le15,\\[1mm] 0,&\text{altfel.}\end{cases}
\] Densitatea este mai mare pe \([0,5]\): timpii scurți de așteptare apar atât când urcăm în metroul de la \(7^{15}\), cât și când urcăm în cel de la \(7^{30}\).
Trecem acum la condiționarea în raport cu valoarea unei alte variabile continue. Dificultatea este că \(\PP(Y=y)=0\), deci nu putem aplica direct definiția probabilității condiționate; definiția se face prin analogie cu cazul discret.
Definiția 18(Densitatea condiționată a lui X la Y=y)
Fie \(X\) și \(Y\) două variabile aleatoare continue cu densitatea comună \(f_{X,Y}\). Pentru \(y\) cu \(f_Y(y)>0\), densitatea condiționată a lui \(X\) la \(Y=y\) este \[
f_{X\mid Y}(x\mid y)=\frac{f_{X,Y}(x,y)}{f_Y(y)},\qquad x\in\R .
\]
Pentru \(y\) fixat, \(f_{X\mid Y}(\cdot\mid y)\) este o densitate de probabilitate: este nenegativă și, folosind \(f_Y(y)=\int f_{X,Y}(x,y)\dd x\), \[
\int_{-\infty}^{+\infty}f_{X\mid Y}(x\mid y)\dd x=\frac{\int_{-\infty}^{+\infty}f_{X,Y}(x,y)\dd x}{f_Y(y)}=\frac{f_Y(y)}{f_Y(y)}=1 .
\] Geometric, secționăm suprafața \(z=f_{X,Y}(x,y)\) cu planul vertical corespunzător valorii fixate \(y\) și normalizăm curba obținută ca să aibă aria 1 (Figura 9 ilustrează acest lucru pentru repartiția normală bidimensională). Cu ajutorul ei calculăm probabilități condiționate \[
\PP(X\in A\mid Y=y)=\int_A f_{X\mid Y}(x\mid y)\dd x,
\] iar relația din definiție se rescrie, simetric, ca regula de înmulțire\[
f_{X,Y}(x,y)=f_{X\mid Y}(x\mid y)\,f_Y(y)=f_{Y\mid X}(y\mid x)\,f_X(x).
\tag{4}\]
Exemplul 10(Repartiția uniformă pe disc)
Considerăm discul de rază \(r>0\) centrat în origine, \(D=\{(x,y)\in\R^2\mid x^2+y^2\le r^2\}\), și \((X,Y)\sim\Unif(D)\): \[
f_{X,Y}(x,y)=\frac{1}{\mathrm{Aria}(D)}\Ind_D(x,y)=\begin{cases}\dfrac{1}{\pi r^2},&x^2+y^2\le r^2,\\[2mm] 0,&\text{altfel.}\end{cases}
\] Vrem să calculăm \(f_{X\mid Y}(x\mid y)\); pentru aceasta avem nevoie mai întâi de densitatea marginală a lui \(Y\). Pentru \(y\in[-r,r]\) fixat, condiția \((x,y)\in D\) înseamnă \(x^2\le r^2-y^2\), adică \(-\sqrt{r^2-y^2}\le x\le\sqrt{r^2-y^2}\), deci \[
f_Y(y)=\int_{-\infty}^{+\infty}\frac{1}{\pi r^2}\Ind_D(x,y)\dd x=\frac1{\pi r^2}\int_{-\sqrt{r^2-y^2}}^{\sqrt{r^2-y^2}}1\dd x=\frac{2\sqrt{r^2-y^2}}{\pi r^2},\qquad y\in[-r,r],
\] și, prin simetrie, \(f_X(x)=\frac{2}{\pi r^2}\sqrt{r^2-x^2}\) pentru \(x\in[-r,r]\) (repartiția semicirculară). Densitatea condiționată este \[
f_{X\mid Y}(x\mid y)=\frac{\frac1{\pi r^2}\Ind_D(x,y)}{\frac{2}{\pi r^2}\sqrt{r^2-y^2}}=\frac{1}{2\sqrt{r^2-y^2}}\Ind_{[-\sqrt{r^2-y^2},\,\sqrt{r^2-y^2}]}(x),\qquad y\in(-r,r).
\] Așadar, știind \(Y=y\), \(X\) este uniform repartizată pe coarda orizontală a discului de la ordonata \(y\): \(X\mid Y=y\sim\Unif\big(-\sqrt{r^2-y^2},\sqrt{r^2-y^2}\big)\).
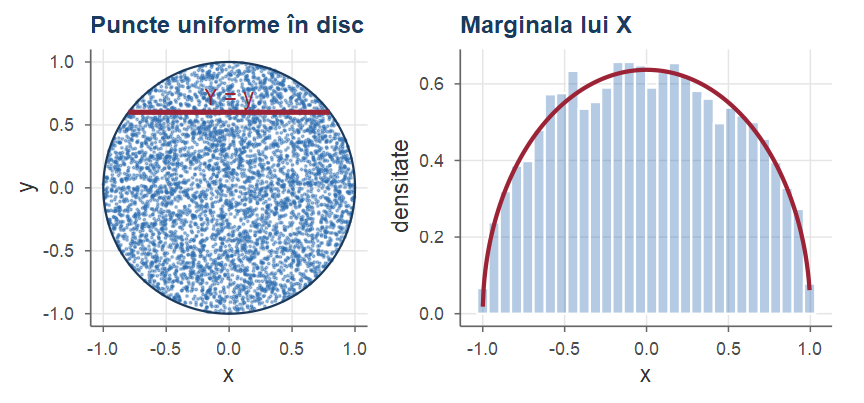
Rezultatul conduce la următorul algoritm de generare a unui punct uniform în disc: (1) generăm \(Y\) cu densitatea \(\frac{2}{\pi r^2}\sqrt{r^2-y^2}\) pe \([-r,r]\); (2) știind \(Y=y\), generăm \(X\) uniform pe \([-\sqrt{r^2-y^2},\sqrt{r^2-y^2}]\). Conform regulii de înmulțire (4), perechea \((X,Y)\) are densitatea \(f_{X\mid Y}f_Y=f_{X,Y}\), deci este \(\Unif(D)\). Pentru pasul (1) observăm că, dacă \(B\sim\BetaD(3/2,3/2)\) (densitate proporțională cu \(\sqrt{b(1-b)}\) pe \([0,1]\)), atunci \(Y=r(2B-1)\) are densitatea proporțională cu \(\sqrt{(r+y)(r-y)}=\sqrt{r^2-y^2}\).
set.seed(11)n <-5000; r <-1Y <- r * (2*rbeta(n, 1.5, 1.5) -1) # pasul 1: densitate semicircularăa <-sqrt(r^2- Y^2)X <-runif(n, -a, a) # pasul 2: uniformă pe coardăc(in_disc =mean(X^2+ Y^2<= r^2), # toate punctele sunt în discP_disc_mic =mean(X^2+ Y^2<= r^2/4)) # teoretic: aria(r/2) / aria(r) = 1/4
#>    in_disc P_disc_mic
#>     1.0000     0.2482
Arată codul R
cerc <-data.frame(t =seq(0, 2* pi, length.out =300))y0 <-0.6p1 <-ggplot(data.frame(X, Y), aes(X, Y)) +geom_point(size =0.25, alpha =0.4, colour = culori[["albastru"]]) +geom_path(data = cerc, aes(cos(t), sin(t)), colour = culori[["bleumarin"]]) +annotate("segment", x =-sqrt(1- y0^2), xend =sqrt(1- y0^2), y = y0, yend = y0,colour = culori[["rosu"]], linewidth =1.2) +annotate("text", x =0, y = y0 +0.12, label ="Y = y", colour = culori[["rosu"]]) +coord_equal() +labs(x ="x", y ="y", title ="Puncte uniforme în disc")p2 <-ggplot(data.frame(X), aes(X)) +geom_histogram(aes(y =after_stat(density)), bins =30, fill = culori[["albastru"]],alpha =0.35, colour ="white") +stat_function(fun =function(x) 2/ pi *sqrt(pmax(1- x^2, 0)), colour = culori[["rosu"]],linewidth =1, n =400) +labs(x ="x", y ="densitate", title ="Marginala lui X")p1 + p2
Figura 5: Repartiția uniformă pe discul unitate, generată cu algoritmul din Exemplul 10. Stânga: 5000 de puncte simulate și o coardă \(Y=y\) pe care \(X\) este uniformă. Dreapta: histograma valorilor lui \(X\) și densitatea marginală semicirculară \(f_X(x)=\frac{2}{\pi}\sqrt{1-x^2}\).
4.4 Independența variabilelor aleatoare
Definiția 19(Variabile aleatoare independente)
Variabilele aleatoare \(X\) și \(Y\) (discrete, continue sau de orice alt tip) sunt independente, și notăm \(X\indep Y\), dacă \[
\PP(X\in A,\ Y\in B)=\PP(X\in A)\,\PP(Y\in B)\qquad\text{pentru orice } A,B\subseteq\R .
\] Mai general, \(X_1,\dots,X_n\) sunt independente dacă \(\PP(X_1\in A_1,\dots,X_n\in A_n)=\prod_{i=1}^n\PP(X_i\in A_i)\) pentru orice \(A_1,\dots,A_n\).
Luând \(A=(-\infty,x]\) și \(B=(-\infty,y]\) obținem că, pentru variabile independente, \(F_{X,Y}(x,y)=F_X(x)F_Y(y)\) pentru orice \(x,y\) (se poate arăta că și reciproca este adevărată). Pentru variabile discrete, definiția este echivalentă cu Definiția 9. În cazul continuu avem următoarea caracterizare.
Propoziția 20(Independența variabilelor continue)
Fie \((X,Y)\) un cuplu de variabile continue cu densitatea comună \(f_{X,Y}\). Atunci \(X\indep Y\) dacă și numai dacă \[
f_{X,Y}(x,y)=f_X(x)\,f_Y(y)\qquad\text{pentru (aproape) orice } x,y,
\] echivalent, \(f_{X\mid Y}(x\mid y)=f_X(x)\) pentru orice \(y\) cu \(f_Y(y)>0\).
Demonstrație. Dacă \(f_{X,Y}=f_Xf_Y\), atunci \(\PP(X\in A,Y\in B)=\int_A\int_B f_X(x)f_Y(y)\dd y\dd x=\int_Af_X\cdot\int_Bf_Y=\PP(X\in A)\PP(Y\in B)\). Reciproc, dacă \(X\indep Y\), atunci \(F_{X,Y}(x,y)=F_X(x)F_Y(y)\), iar prin derivare parțială mixtă \(f_{X,Y}(x,y)=F_X'(x)F_Y'(y)=f_X(x)f_Y(y)\). Echivalența cu forma condiționată rezultă din \(f_{X,Y}=f_{X\mid Y}f_Y\).■
În practică, independența se recunoaște adesea direct din forma densității, fără a calcula marginalele.
Propoziția 21(Criteriul de factorizare)
Dacă densitatea comună a lui \((X,Y)\) se scrie sub forma \[
f_{X,Y}(x,y)=g(x)\,h(y)\qquad\text{pentru orice } x,y\in\R,
\] cu \(g,h\ge0\), atunci \(X\indep Y\). Mai mult, \(f_X\) este proporțională cu \(g\), iar \(f_Y\) cu \(h\).
Demonstrație. Notăm \(c_1=\int_{\R} g(x)\dd x\) și \(c_2=\int_{\R} h(y)\dd y\). Din normalizare, \(1=\iint_{\R^2}g(x)h(y)\dd x\dd y=c_1c_2\). Densitățile marginale sunt \(f_X(x)=\int_{\R} g(x)h(y)\dd y=c_2\,g(x)\) și \(f_Y(y)=\int_{\R} g(x)h(y)\dd x=c_1\,h(y)\), deci \(f_X(x)f_Y(y)=c_1c_2\,g(x)h(y)=g(x)h(y)=f_{X,Y}(x,y)\) și concluzia rezultă din Propoziția 20.■
Atenție!
Factorizarea trebuie să aibă loc pe tot planul, inclusiv în ceea ce privește funcțiile indicatoare. De exemplu, \(f_{X,Y}(x,y)=8xy\) pentru \(0\le y\le x\le1\)pare să se factorizeze, dar în realitate \(f_{X,Y}(x,y)=8xy\,\Ind_{\{0\le y\le x\le1\}}\), iar indicatorul unui triunghi nu este un produs \(g(x)h(y)\): \(X\) și \(Y\) nu sunt independente. Regula practică: dacă suportul densității (mulțimea unde \(f_{X,Y}>0\)) nu este un „dreptunghi” \(A\times B\), variabilele nu pot fi independente. Astfel, pentru vectorul uniform pe pătrat (Exemplul 6), \(X\indep Y\), dar pentru vectorul uniform pe disc (Exemplul 10) variabilele sunt dependente — confirmat și de faptul că \(f_{X\mid Y}(x\mid y)\) depinde de \(y\).
Propoziția 22(Medii pentru variabile independente)
Dacă \(X\indep Y\), atunci pentru orice funcții \(g,h\) (pentru care mediile există) \[
\E[g(X)\,h(Y)]=\E[g(X)]\,\E[h(Y)].
\] În particular \(\E[XY]=\E[X]\E[Y]\) și \(\Var(X+Y)=\Var(X)+\Var(Y)\).
Demonstrație. În cazul continuu, cu Teorema 25 de mai jos și factorizarea densității, \(\E[g(X)h(Y)]=\iint g(x)h(y)f_X(x)f_Y(y)\dd x\dd y=\int g(x)f_X(x)\dd x\int h(y)f_Y(y)\dd y\); cazul discret este analog, cu sume. Pentru varianță, \(\Var(X+Y)=\E[(X-\E X+Y-\E Y)^2]=\Var(X)+\Var(Y)+2\E[(X-\E X)(Y-\E Y)]\), iar ultimul termen este \(2\E[X-\E X]\,\E[Y-\E Y]=0\).■
4.5 Formula lui Bayes: cazul continuu și cazul hibrid
În multe aplicații (comunicații, măsurători, statistică) o mărime \(X\) care ne interesează nu poate fi observată direct; observăm doar o mărime \(Y\) „afectată de zgomot”, iar pe baza lui \(Y\) vrem să facem inferențe despre \(X\): \[
X\ \big(f_X\big)\ \longrightarrow\ \boxed{\text{zgomot}}\ \longrightarrow\ Y\ \big(f_{Y\mid X}\big)\ \longrightarrow\ \boxed{\text{inferență}}\ \longrightarrow\ f_{X\mid Y}.
\] Modelul furnizează repartiția lui \(X\) (a priori) și repartiția observației știind \(X\) (verosimilitatea); dorim repartiția lui \(X\) știind observația (a posteriori).
Teorema 23(Formula lui Bayes pentru densități)
Fie \(X,Y\) variabile aleatoare continue cu densitatea comună \(f_{X,Y}\). Pentru \(y\) cu \(f_Y(y)>0\), \[
f_{X\mid Y}(x\mid y)=\frac{f_{Y\mid X}(y\mid x)\,f_X(x)}{f_Y(y)}=\frac{f_{Y\mid X}(y\mid x)\,f_X(x)}{\int_{-\infty}^{+\infty}f_{Y\mid X}(y\mid x')\,f_X(x')\dd x'} .
\]
Demonstrație. Din regula de înmulțire (4), \(f_{X\mid Y}(x\mid y)f_Y(y)=f_{Y\mid X}(y\mid x)f_X(x)\), de unde prima egalitate. Pentru numitor folosim formula probabilității totale pentru densități: \(f_Y(y)=\int f_{X,Y}(x,y)\dd x=\int f_{Y\mid X}(y\mid x)f_X(x)\dd x\).■
Formula lui Bayes pentru densități stă la baza statisticii bayesiene (Cursul 11), unde \(X\) este un parametru necunoscut, iar \(Y\) reprezintă datele.
Adesea una dintre variabile este discretă, iar cealaltă continuă — de exemplu, un semnal binar\(S\in\{0,1\}\) transmis pe un canal cu zgomot gaussian, \(Y=S+Z\), \(Z\sim\Norm(0,1)\). Vrem să calculăm \(\PP(A\mid Y=y)\), unde \(A\) este un eveniment (de exemplu \(A=\{S=1\}\)). Cum \(\PP(Y=y)=0\), interpretăm această probabilitate ca o limită: pentru \(\mathrm{d}y\) mic, \[
\PP(A\mid Y=y)\approx\PP\big(A\mid Y\in[y,y+\mathrm{d}y]\big)=\frac{\PP(A)\,\PP(Y\in[y,y+\mathrm{d}y]\mid A)}{\PP(Y\in[y,y+\mathrm{d}y])}
\approx\frac{\PP(A)\,f_{Y\mid A}(y)\,\mathrm{d}y}{f_Y(y)\,\mathrm{d}y} .
\] Aceasta motivează următoarele formule.
Propoziția 24(Formula lui Bayes, cazul hibrid)
Fie \(Y\) o variabilă aleatoare continuă și \(A\) un eveniment cu \(0<\PP(A)<1\) astfel încât \(Y\mid A\) și \(Y\mid A^c\) au densitățile \(f_{Y\mid A}\), \(f_{Y\mid A^c}\). Atunci \[
\PP(A\mid Y=y)=\frac{\PP(A)\,f_{Y\mid A}(y)}{f_Y(y)}=\frac{f_{Y\mid A}(y)\,\PP(A)}{f_{Y\mid A}(y)\,\PP(A)+f_{Y\mid A^c}(y)\,\PP(A^c)} .
\] Mai general, dacă \(X\) este discretă, cu \(X(\Omega)=\{x_1,\dots,x_n\}\), și \(Y\) este continuă, \[
\PP(X=x\mid Y=y)=\frac{\PP(X=x)\,f_{Y\mid X}(y\mid x)}{\sum_{i=1}^n\PP(X=x_i)\,f_{Y\mid X}(y\mid x_i)} .
\]
Toate variantele formulei probabilității totale și ale formulei lui Bayes întâlnite până acum pot fi rezumate în două tabele cu dublă intrare, după natura (discretă sau continuă) a celor două variabile:
Regula de memorare este simplă: pentru o variabilă discretă apar probabilități și sume, pentru una continuă densități și integrale.
Exemplul 11(Semnal binar cu zgomot gaussian)
Un semnal \(S\in\{-1,1\}\) este transmis cu \(\PP(S=1)=p\), \(\PP(S=-1)=1-p\). Se recepționează \(Y=S+N\), unde zgomotul \(N\sim\Norm(0,1)\) este independent de \(S\). Știind \(S=s\), avem \(Y\mid S=s\sim\Norm(s,1)\), deci \(f_{Y\mid S}(y\mid s)=\frac1{\sqrt{2\pi}}e^{-(y-s)^2/2}\). Cu formula lui Bayes hibridă, \[
\PP(S=1\mid Y=y)=\frac{p\,e^{-(y-1)^2/2}}{p\,e^{-(y-1)^2/2}+(1-p)\,e^{-(y+1)^2/2}}=\frac{p\,e^{y}}{p\,e^{y}+(1-p)\,e^{-y}},
\] după simplificarea cu \(e^{-(y^2+1)/2}\). Pentru \(p=1/2\) obținem \(\PP(S=1\mid Y=y)=\frac{1}{1+e^{-2y}}\): de exemplu, pentru \(y=0.5\) probabilitatea este \(0.731\), pentru \(y=1\) este \(0.881\), iar pentru \(y=0\) este \(1/2\) (observația nu favorizează niciun semnal). Regula naturală de decizie „decidem \(S=1\) dacă \(\PP(S=1\mid Y=y)>1/2\)” devine, pentru \(p=1/2\), simplu „decidem \(S=1\) dacă \(y>0\)”.
Exemplul 12(Becurile inteligente a două companii)
Pe piață există două companii, \(A\) și \(B\), care produc becuri inteligente. Duratele de viață ale becurilor produse de \(A\) sunt repartizate \(\Exp(\lambda_0)\), iar ale celor produse de \(B\) sunt \(\Exp(\lambda_1)\), cu \(\lambda_0<\lambda_1\) (becurile firmei \(A\) durează în medie mai mult). Am primit un bec pe care nu este inscripționată firma producătoare; știm că un bec ales la întâmplare provine de la \(A\) cu probabilitatea \(p_0\in(0,1)\) și de la \(B\) cu probabilitatea \(p_1=1-p_0\). Fie \(T\) durata de viață a becului primit.
Care sunt funcția de repartiție și densitatea lui \(T\)?
Are \(T\) proprietatea lipsei de memorie?
Fie \(I=1\) dacă becul provine de la compania \(B\) și \(I=0\) altfel. Determinați repartiția condiționată a lui \(I\) la \(T=t\).
Soluție.\(T\) este continuă, iar \(I\sim\Bern(p_1)\) este discretă, cu \(T\mid I=0\sim\Exp(\lambda_0)\) și \(T\mid I=1\sim\Exp(\lambda_1)\).
Cu formula probabilității totale și \(F(t)=1-e^{-\lambda t}\) pentru repartiția \(\Exp(\lambda)\), pentru \(t\ge0\): \[
\begin{aligned}
F_T(t)&=\PP(T\le t\mid I=0)\PP(I=0)+\PP(T\le t\mid I=1)\PP(I=1)\\
&=(1-e^{-\lambda_0t})p_0+(1-e^{-\lambda_1t})p_1,
\end{aligned}
\] iar densitatea este \(f_T(t)=F_T'(t)=p_0\lambda_0e^{-\lambda_0t}+p_1\lambda_1e^{-\lambda_1t}\), \(t>0\): un amestec (mixtură) de exponențiale.
Cum \(\lambda_0\ne\lambda_1\), densitatea lui \(T\) nu se poate scrie sub forma \(\lambda e^{-\lambda t}\), deci \(T\) nu este repartizată exponențial; cum repartiția exponențială este singura repartiție continuă fără memorie (Cursul 5), \(T\) nu are proprietatea lipsei de memorie. Intuitiv: un bec care a funcționat deja mult timp este mai probabil să provină de la \(A\), deci „viitorul” lui depinde de trecut.
Cu formula lui Bayes hibridă, \[
\PP(I=1\mid T=t)=\frac{f_{T\mid I}(t\mid 1)\PP(I=1)}{f_T(t)}=\frac{(1-p_0)\lambda_1e^{-\lambda_1t}}{p_0\lambda_0e^{-\lambda_0t}+(1-p_0)\lambda_1e^{-\lambda_1t}},
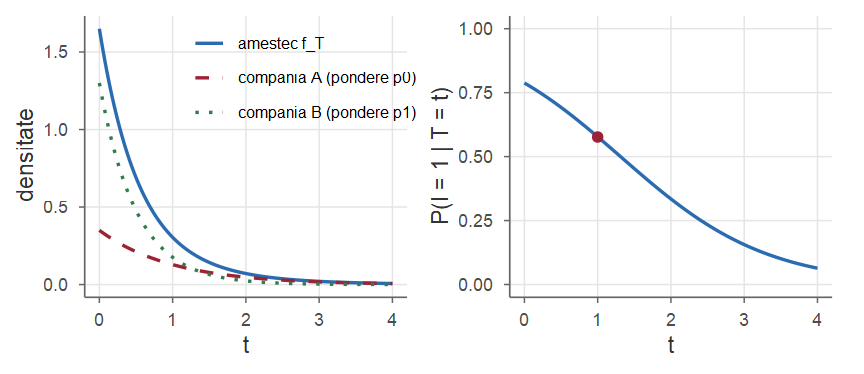
\] iar \(\PP(I=0\mid T=t)=1-\PP(I=1\mid T=t)\). De exemplu, pentru \(p_0=0.35\), \(\lambda_0=1\), \(\lambda_1=2\) și \(t=1\) obținem \(\PP(I=1\mid T=1)=\frac{0.65\cdot2e^{-2}}{0.35e^{-1}+0.65\cdot2e^{-2}}\approx0.577\). Probabilitatea a posteriori scade cu \(t\) (Figura 6): cu cât becul a durat mai mult, cu atât este mai probabil să provină de la \(A\).
Arată codul R
p0 <-0.35; l0 <-1; l1 <-2tt <-seq(0, 4, length.out =300)dA <- p0 * l0 *exp(-l0 * tt); dB <- (1- p0) * l1 *exp(-l1 * tt)dd <-rbind(data.frame(t = tt, f = dA, c ="compania A (pondere p0)"),data.frame(t = tt, f = dB, c ="compania B (pondere p1)"),data.frame(t = tt, f = dA + dB, c ="amestec f_T"))p1 <-ggplot(dd, aes(t, f, colour = c, linetype = c)) +geom_line() +scale_linetype_manual(values =c(1, 2, 3)) +labs(x ="t", y ="densitate", colour =NULL, linetype =NULL) +theme(legend.position =c(0.68, 0.78),legend.text =element_text(size =8))p2 <-ggplot(data.frame(t = tt, p = dB / (dA + dB)), aes(t, p)) +geom_line() +geom_point(data =data.frame(t =1, p = dB[which.min(abs(tt -1))] / (dA + dB)[which.min(abs(tt -1))]),colour = culori[["rosu"]], size =2) +labs(x ="t", y ="P(I = 1 | T = t)") +ylim(0, 1)p1 + p2
Figura 6: Exemplul 12 cu \(p_0=0.35\), \(\lambda_0=1\), \(\lambda_1=2\). Stânga: densitatea lui \(T\) (amestec) și cele două componente ponderate. Dreapta: probabilitatea a posteriori \(\PP(I=1\mid T=t)\) ca becul să provină de la compania \(B\).
5 Medii ale funcțiilor de vectori aleatori. Media condiționată
5.1 Media unei funcții de un vector aleator continuu
Teorema 25(Media unei funcții de un vector aleator continuu)
Dacă \((X,Y)\) are densitatea comună \(f_{X,Y}\) și \(g:\R^2\to\R\), atunci (când integrala converge absolut) \[
\E[g(X,Y)]=\iint_{\R^2}g(x,y)\,f_{X,Y}(x,y)\dd x\dd y .
\] În particular \(\E[XY]=\iint xy\,f_{X,Y}(x,y)\dd x\dd y\), iar media este liniară: \(\E[aX+bY]=a\E[X]+b\E[Y]\).
Teorema este analogul continuu al Teoremei 10 (demonstrația generală folosește teoria integralei Lebesgue și o omitem). Liniaritatea mediei are loc pentru orice variabile aleatoare cu medie finită, indiferent dacă sunt sau nu independente — o proprietate pe care o vom folosi în mod repetat.
Exemplul 13(Distanța medie dintre două puncte aleatoare din [0,1])
Fie \(X,Y\sim\Unif(0,1)\) independente; vrem \(\E|X-Y|\). Din independență, \(f_{X,Y}(x,y)=f_X(x)f_Y(y)=\Ind_{[0,1]^2}(x,y)\), deci \((X,Y)\) este uniform pe pătratul unitate și \[
\begin{aligned}
\E|X-Y|&=\iint_{[0,1]^2}|x-y|\dd x\dd y=\int_0^1\!\!\int_y^1(x-y)\dd x\dd y+\int_0^1\!\!\int_0^y(y-x)\dd x\dd y\\
&=2\int_0^1\!\!\int_y^1(x-y)\dd x\dd y,
\end{aligned}
\] cele două integrale fiind egale prin simetrie (schimbarea rolurilor lui \(x\) și \(y\)). Cum \(\int_y^1(x-y)\dd x=\frac{(1-y)^2}{2}\), obținem \(\E|X-Y|=2\int_0^1\frac{(1-y)^2}{2}\dd y=\frac13\).
# E|X - Y| pentru X, Y ~ U(0,1) independente: integrare numerică și simulareset.seed(3); u <-runif(1e6); v <-runif(1e6)c(integr =I2(function(x, y) abs(x - y), 0, 1, 0, 1), simul =mean(abs(u - v)))
#> integr  simul
#> 0.3333 0.3335
5.2 Media condiționată (cazul general)
Definiția 26(Media condiționată)
Fie \(X\) o variabilă aleatoare continuă și \(A\) un eveniment cu \(\PP(A)>0\). Media condiționată a lui \(X\) la \(A\) este \[
\E[X\mid A]=\int_{-\infty}^{+\infty}x\,f_{X\mid A}(x)\dd x .
\] În particular, dacă \(A=\{Y=y\}\), unde \(Y\) este o variabilă aleatoare continuă (cu \(f_Y(y)>0\)), media condiționată a lui \(X\) la \(Y=y\) este \[
\E[X\mid Y=y]=\int_{-\infty}^{+\infty}x\,f_{X\mid Y}(x\mid y)\dd x .
\]
Media condiționată este media unei repartiții (cea condiționată), deci are toate proprietățile mediei obișnuite: este liniară, \(\E[g(X)\mid A]=\int g(x)f_{X\mid A}(x)\dd x\) etc. Formula probabilității totale se transferă mediilor: dacă \(A_1,\dots,A_n\) este o partiție a lui \(\Omega\) cu \(\PP(A_i)>0\), atunci, înmulțind cu \(x\) relația din Propoziția 17 și integrând, \[
\E[X]=\sum_{i=1}^n\E[X\mid A_i]\,\PP(A_i),
\tag{5}\] iar dacă \(Y\) este o variabilă continuă, \[
\E[X]=\int_{-\infty}^{+\infty}\E[X\mid Y=y]\,f_Y(y)\dd y .
\tag{6}\]
În exemplul metroului (Exemplul 9), \(\E[Y\mid A]=5/2\) și \(\E[Y\mid B]=15/2\) (medii de uniforme), deci, cu (5), timpul mediu de așteptare este \(\E[Y]=\frac52\cdot\frac14+\frac{15}2\cdot\frac34=\frac{50}8=6.25\) minute — fără a calcula vreo integrală.
Definiția 27(Media condiționată ca variabilă aleatoare)
Fie \(g(y)=\E[X\mid Y=y]\). Media condiționată a lui \(X\) la \(Y\), notată \(\E[X\mid Y]\), este variabila aleatoare \(g(Y)\). Analog, varianța condiționată\(\Var(X\mid Y)\) este variabila aleatoare \(v(Y)\), unde \[
v(y)=\Var(X\mid Y=y)=\E[X^2\mid Y=y]-\big(\E[X\mid Y=y]\big)^2 ,
\] adică \(\Var(X\mid Y)=\E[X^2\mid Y]-\big(\E[X\mid Y]\big)^2\).
Atenție!
Nu confundați \(\E[X\mid Y=y]\), care este un număr (depinzând de \(y\)), cu \(\E[X\mid Y]\), care este o variabilă aleatoare (o funcție de \(Y\)). Pentru a obține \(\E[X\mid Y]\), calculăm \(\E[X\mid Y=y]\) ca funcție de \(y\) și apoi înlocuim \(y\) cu \(Y\).
Exemplul 14(Media condiționată pe disc)
Pentru \((X,Y)\sim\Unif(D)\), discul de rază \(r\) (Exemplul 10), am văzut că \(X\mid Y=y\sim\Unif(-a,a)\), cu \(a=\sqrt{r^2-y^2}\). Media și varianța unei \(\Unif(-a,a)\) sunt \(0\) și \(\frac{(2a)^2}{12}=\frac{a^2}{3}\), deci \[
\begin{gathered}
\E[X\mid Y=y]=0,\quad \Var(X\mid Y=y)=\frac{r^2-y^2}{3},\\ \text{deci}\quad \E[X\mid Y]=0,\quad \Var(X\mid Y)=\frac{r^2-Y^2}{3}.
\end{gathered}
\] Media condiționată nu depinde de \(Y\), dar varianța condiționată depinde: variabilele sunt dependente.
Proprietățile fundamentale ale mediei condiționate sunt reunite în teorema următoare. Primele două sunt numite, după Blitzstein and Hwang (2019), legea lui Adam și legea lui Eve (după inițialele lui Expectation și Variance: „EVVE” \(=\E[\Var]+\Var(\E)\)).
Teorema 28(Proprietățile mediei condiționate)
Fie \(X\) și \(Y\) două variabile aleatoare (cu \(\E[X^2]<\infty\)). Atunci:
(legea mediei iterate, legea lui Adam) \(\ \E\big[\E[X\mid Y]\big]=\E[X]\);
(legea varianței totale, legea lui Eve) \(\ \Var(X)=\E\big[\Var(X\mid Y)\big]+\Var\big(\E[X\mid Y]\big)\);
pentru orice funcție \(h\), \(\E[h(Y)X\mid Y]=h(Y)\,\E[X\mid Y]\) („ce este cunoscut iese în afara mediei”);
dacă \(X\indep Y\), atunci \(\E[X\mid Y]=\E[X]\).
Demonstrație.
În cazul continuu, cu \(g(y)=\E[X\mid Y=y]\) și regula de înmulțire, \[
\begin{aligned}
\E[g(Y)]&=\int g(y)f_Y(y)\dd y=\int\!\!\Big(\int x\,f_{X\mid Y}(x\mid y)\dd x\Big)f_Y(y)\dd y\\
&=\iint x\,f_{X\mid Y}(x\mid y)f_Y(y)\dd x\dd y=\iint x\,f_{X,Y}(x,y)\dd x\dd y=\E[X] .
\end{aligned}
\] Cazul discret este Propoziția 12.
Din definiția varianței condiționate și din a), aplicat lui \(X^2\), \[
\E\big[\Var(X\mid Y)\big]=\E\big[\E[X^2\mid Y]\big]-\E\big[(\E[X\mid Y])^2\big]=\E[X^2]-\E\big[(\E[X\mid Y])^2\big] .
\] Pe de altă parte, din nou cu a), \[
\Var\big(\E[X\mid Y]\big)=\E\big[(\E[X\mid Y])^2\big]-\big(\E[\E[X\mid Y]]\big)^2=\E\big[(\E[X\mid Y])^2\big]-(\E[X])^2 .
\] Adunând cele două relații, termenii \(\E[(\E[X\mid Y])^2]\) se reduc și obținem \(\E[X^2]-(\E[X])^2=\Var(X)\).
Știind \(Y=y\), \(h(Y)=h(y)\) este o constantă, deci \(\E[h(Y)X\mid Y=y]=\E[h(y)X\mid Y=y]=h(y)\E[X\mid Y=y]\). d) Dacă \(X\indep Y\), repartiția condiționată a lui \(X\) la \(Y=y\) coincide cu repartiția lui \(X\), deci \(\E[X\mid Y=y]=\E[X]\) pentru orice \(y\).
■
Legea lui Eve are o interpretare intuitivă: variabilitatea totală a lui \(X\) se descompune în variabilitatea din interiorul grupurilor determinate de valorile lui \(Y\) (\(\E[\Var(X\mid Y)]\)) și variabilitatea dintre grupuri, adică a mediilor de grup (\(\Var(\E[X\mid Y])\)). Această descompunere stă la baza analizei varianței și a coeficientului de determinare \(R^2\) din regresie (Cursul 14).
Pentru discul din Exemplul 14, legea lui Eve dă \(\Var(X)=\E\big[\frac{r^2-Y^2}{3}\big]+\Var(0)=\frac{r^2-\E[Y^2]}{3}\). Prin simetrie \(\E[X^2]=\E[Y^2]\), deci \(\E[Y^2]=\frac12\E[X^2+Y^2]=\frac{r^2}{4}\) (vezi Exercițiul 12), de unde \(\Var(X)=\frac{r^2-r^2/4}{3}=\frac{r^2}{4}\).
Interpretarea geometrică a mediei condiționate. Media condiționată \(\E[X\mid Y]\) este acea funcție de \(Y\) care aproximează cel mai bine variabila \(X\) în sensul erorii pătratice medii.
Propoziția 29(Media condiționată ca cel mai bun predictor)
Pentru orice funcție \(h\) (cu \(\E[h(Y)^2]<\infty\)), \[
\E\big[(X-\E[X\mid Y])^2\big]\le\E\big[(X-h(Y))^2\big],\] adică \[\E[X\mid Y]=\argmin_{h}\ \E\big[(X-h(Y))^2\big].
\]
Demonstrație. Fie \(g(Y)=\E[X\mid Y]\). Scriem \(X-h(Y)=(X-g(Y))+(g(Y)-h(Y))\) și dezvoltăm pătratul: \[
\E[(X-h(Y))^2]=\E[(X-g(Y))^2]+\E[(g(Y)-h(Y))^2]+2\E\big[(g(Y)-h(Y))(X-g(Y))\big].
\] Cu legea lui Adam și proprietatea c) din Teorema 28, ultimul termen este \(2\E\big[(g(Y)-h(Y))\,\E[X-g(Y)\mid Y]\big]=2\E\big[(g(Y)-h(Y))(g(Y)-g(Y))\big]=0\). Prin urmare \(\E[(X-h(Y))^2]=\E[(X-g(Y))^2]+\E[(g(Y)-h(Y))^2]\ge\E[(X-g(Y))^2]\).■
Geometric, dacă gândim variabilele aleatoare ca vectori cu produsul scalar \(\langle U,V\rangle=\E[UV]\), \(\E[X\mid Y]\) este proiecția ortogonală a lui \(X\) pe „planul” funcțiilor de \(Y\): reziduul \(X-\E[X\mid Y]\) este ortogonal pe orice \(h(Y)\).
Un exemplu important este regresia liniară simplă, în care \(Y\) este variabila răspuns (dependentă), \(X\) variabila explicativă (covariabilă, predictor), iar ipoteza de bază este că \(\E[Y\mid X]=a+bX\). Relația este echivalentă cu \(Y=a+bX+\varepsilon\), unde termenul de eroare \(\varepsilon=Y-\E[Y\mid X]\) verifică \(\E[\varepsilon\mid X]=0\); conform Propoziției 29, dreapta \(a+bx\) este atunci cel mai bun predictor al lui \(Y\) pe baza lui \(X\) (vezi Cursul 14).
5.3 Sume aleatoare
Legile lui Adam și Eve sunt deosebit de utile când o mărime se construiește în două etape. Un exemplu tipic sunt sumele cu un număr aleator de termeni.
Exemplul 15(Suma totală cheltuită într-un magazin)
Într-un magazin intră într-o zi \(N\) clienți, unde \(N\) este o variabilă aleatoare cu valori în \(\{0,1,2,\dots\}\). Clientul \(i\) cheltuiește suma \(X_i\). Presupunem că \(X_1,X_2,\dots\) sunt independente, identic repartizate, cu media \(\mu\) și varianța \(\sigma^2\), și independente de \(N\). Suma totală cheltuită în magazin este \[
T=\sum_{i=1}^{N}X_i ,
\] adică, pentru un rezultat \(\omega\), \(T(\omega)=\sum_{i=1}^{N(\omega)}X_i(\omega)\): dacă într-o zi \(\omega_1\) vin \(N(\omega_1)=10\) clienți, suma are 10 termeni, iar într-o zi \(\omega_2\) cu \(N(\omega_2)=20\) are 20 de termeni. Nu putem aplica direct liniaritatea mediei, deoarece numărul de termeni este aleator; condiționăm însă la \(N\). Știind \(N=n\), suma are un număr fix de termeni, independenți de \(N\), deci \[
\E[T\mid N=n]=\E\Big[\sum_{i=1}^nX_i\,\Big|\,N=n\Big]=\sum_{i=1}^n\E[X_i]=n\mu,
\qquad
\Var(T\mid N=n)=n\sigma^2 .
\] Așadar \(\E[T\mid N]=N\mu\) și \(\Var(T\mid N)=N\sigma^2\), iar legile lui Adam și Eve dau rezultatul din propoziția următoare.
Propoziția 30(Media și varianța unei sume aleatoare)
Fie \(N\) o variabilă aleatoare cu valori în \(\N\) și \(X_1,X_2,\dots\) variabile independente, identic repartizate, cu \(\E[X_1]=\mu\), \(\Var(X_1)=\sigma^2\), independente de \(N\). Atunci \(T=\sum_{i=1}^NX_i\) verifică \[
\E[T]=\E[N]\,\E[X_1]\quad\text{(identitatea lui Wald)},
\]\[
\Var(T)=\E[N]\Var(X_1)+\big(\E[X_1]\big)^2\Var(N).
\]
Demonstrație. Cu legea lui Adam, \(\E[T]=\E[\E[T\mid N]]=\E[N\mu]=\mu\E[N]\). Cu legea lui Eve, \(\Var(T)=\E[\Var(T\mid N)]+\Var(\E[T\mid N])=\E[N\sigma^2]+\Var(N\mu)=\sigma^2\E[N]+\mu^2\Var(N)\).■
Cei doi termeni ai varianței au interpretări clare: primul provine din variabilitatea sumelor individuale cheltuite, iar al doilea din variabilitatea numărului de clienți. Dacă, de exemplu, \(N\sim\Pois(\lambda)\), atunci \(\E[N]=\Var(N)=\lambda\) și \(\Var(T)=\lambda(\sigma^2+\mu^2)=\lambda\E[X_1^2]\). Pentru \(\lambda=50\) clienți pe zi și \(X_i\sim\Exp\) cu media \(\mu=30\) lei (\(\sigma=30\)), obținem \(\E[T]=1500\) lei și \(\Var(T)=50\cdot2\cdot900=90000\), deci abaterea standard este \(300\) lei. Verificăm prin simulare:
set.seed(42)N <-rpois(1e5, lambda =50) # clienți pe ziT <-sapply(N, function(n) sum(rexp(n, rate =1/30))) # suma totală pe zic(medie =mean(T), abatere_std =sd(T)) # teoretic: 1500 și 300
#>       medie abatere_std
#>      1499.8       300.4
6 Covarianță și corelație
Media și varianța descriu fiecare variabilă în parte. Pentru a măsura cât de mult „variază împreună” două variabile introducem covarianța.
Definiția 31(Covarianța)
Fie \(X\) și \(Y\) două variabile aleatoare cu \(\E[X^2],\E[Y^2]<\infty\). Se numește covarianța dintre \(X\) și \(Y\)\[
\Cov(X,Y)=\E\big[(X-\E[X])(Y-\E[Y])\big].
\]
Intuitiv, covarianța măsoară tendința celor două variabile de a crește sau de a scădea simultan. Dacă valorile mari ale lui \(X\) (peste medie) apar de regulă împreună cu valori mari ale lui \(Y\), produsul \((X-\E X)(Y-\E Y)\) este mai des pozitiv și \(\Cov(X,Y)>0\); dacă valorile mari ale uneia însoțesc valori mici ale celeilalte, \(\Cov(X,Y)<0\). În particular, pentru \(Y=X\), \[
\Cov(X,X)=\E\big[(X-\E[X])^2\big]=\Var(X),
\] deci varianța este un caz particular de covarianță. Dezvoltând produsul și folosind liniaritatea mediei obținem formula de calcul\[
\Cov(X,Y)=\E[XY]-\E[X]\,\E[Y],
\tag{7}\] analoagă formulei \(\Var(X)=\E[X^2]-(\E[X])^2\). Într-adevăr, \(\E[(X-\E X)(Y-\E Y)]=\E[XY]-\E[X]\E[Y]-\E[Y]\E[X]+\E[X]\E[Y]\).
Definiția 32(Variabile necorelate)
Spunem că variabilele aleatoare \(X\) și \(Y\) sunt necorelate dacă \(\Cov(X,Y)=0\).
Propoziția 33(Independența implică necorelarea)
Dacă \(X\indep Y\) (și au momente de ordinul doi finite), atunci \(\Cov(X,Y)=0\).
Demonstrație. Din Propoziția 22, \(\E[XY]=\E[X]\E[Y]\), deci, cu (7), \(\Cov(X,Y)=0\).■
Exemplul 16(Necorelarea nu implică independența)
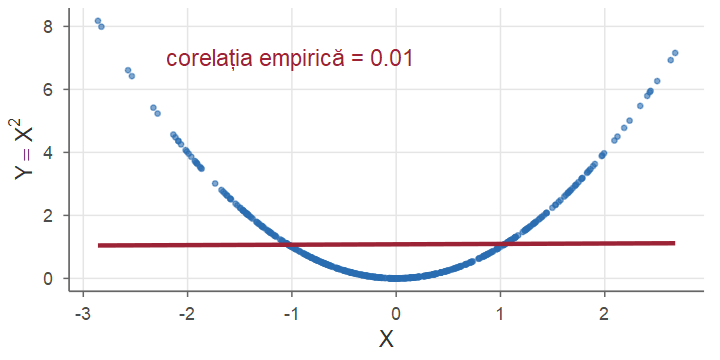
Fie \(X\sim\Norm(0,1)\) și \(Y=X^2\). Evident, \(X\) și \(Y\)nu sunt independente: valoarea lui \(Y\) este complet determinată de cea a lui \(X\) (de exemplu \(\PP(X>1,\ Y\le1)=0\ne\PP(X>1)\PP(Y\le1)\)). Totuși \(\E[X]=0\), deci \(\E[X]\E[Y]=0\), iar \[
\E[XY]=\E[X^3]=\int_{-\infty}^{+\infty}x^3\,\frac{1}{\sqrt{2\pi}}e^{-x^2/2}\dd x=0,
\] integrandul fiind o funcție impară integrată pe un domeniu simetric. Prin urmare \(\Cov(X,Y)=0\): variabilele sunt necorelate, dar dependente. Norul de puncte din Figura 7 arată o dependență perfectă, dar neliniară — iar covarianța „vede” doar dependența liniară.
Arată codul R
set.seed(14)xx <-rnorm(500)ggplot(data.frame(x = xx, y = xx^2), aes(x, y)) +geom_point(size =0.9, alpha =0.6) +geom_smooth(method ="lm", se =FALSE, formula = y ~ x, colour = culori[["rosu"]]) +annotate("text", x =-2.2, y =7, label =paste0("corelația empirică = ", round(cor(xx, xx^2), 3)),hjust =0, colour = culori[["rosu"]]) +labs(x ="X", y =expression(Y == X^2))
Figura 7: 500 de perechi \((X, X^2)\) cu \(X\sim\mathcal{N}(0,1)\): dependență funcțională perfectă, dar corelație (liniară) nulă; dreapta de regresie estimată este practic orizontală.
Propoziția 34(Proprietățile covarianței)
Pentru orice variabile aleatoare \(X,Y,Z,X_1,\dots,X_n\) cu momente de ordinul doi finite și orice constante \(a,b\in\R\):
Demonstrație. a)–c) sunt imediate din definiție și din (7). Pentru d) și e) folosim (7) și liniaritatea mediei: \(\Cov(a+bX,Y)=\E[(a+bX)Y]-\E[a+bX]\E[Y]=a\E Y+b\E[XY]-a\E Y-b\E X\E Y=b\Cov(X,Y)\) și \(\Cov(X+Y,Z)=\E[XZ]+\E[YZ]-(\E X+\E Y)\E Z=\Cov(X,Z)+\Cov(Y,Z)\). Covarianța este deci biliniară. Atunci \[
\begin{aligned}
\Var(X+Y)&=\Cov(X+Y,X+Y)=\Cov(X,X)+\Cov(X,Y)+\Cov(Y,X)+\Cov(Y,Y)\\
&=\Var(X)+\Var(Y)+2\Cov(X,Y),
\end{aligned}
\] iar g) se obține la fel, dezvoltând \(\Cov\big(\sum_iX_i,\sum_jX_j\big)=\sum_{i,j}\Cov(X_i,X_j)\).■
În particular, dacă \(X_1,\dots,X_n\) sunt necorelate două câte două (de exemplu independente), varianța sumei este suma varianțelor. Astfel, pentru \(X\sim\Bin(n,p)\), scris ca sumă de \(n\) variabile \(\Bern(p)\) independente, \(\Var(X)=np(1-p)\).
Covarianța depinde de unitățile de măsură (dacă \(X\) se măsoară în centimetri în loc de metri, covarianța se înmulțește cu 100). Pentru a obține o măsură adimensională o normalizăm.
Definiția 35(Coeficientul de corelație)
Fie \(X\) și \(Y\) cu varianțe finite și nenule. Se numește coeficientul de corelație (Pearson) dintre \(X\) și \(Y\)\[
\rho(X,Y)=\frac{\Cov(X,Y)}{\sqrt{\Var(X)}\,\sqrt{\Var(Y)}} .
\]
Dacă \(\mu_X=\E[X]\), \(\sigma_X^2=\Var(X)\), \(\mu_Y=\E[Y]\), \(\sigma_Y^2=\Var(Y)\), atunci \[
\rho(X,Y)=\frac{\E[(X-\mu_X)(Y-\mu_Y)]}{\sigma_X\sigma_Y}=\E\Big[\frac{X-\mu_X}{\sigma_X}\cdot\frac{Y-\mu_Y}{\sigma_Y}\Big],
\] adică corelația este covarianța variabilelor standardizate (centrate și scalate), care au media 0 și varianța 1. În particular, pentru \(a,c\ne0\), \(\rho(aX+b,cY+d)=\sgn(ac)\,\rho(X,Y)\): corelația nu depinde de unitățile de măsură.
Teorema 36(Mărginirea coeficientului de corelație)
Pentru orice variabile aleatoare \(X,Y\) cu varianțe finite și nenule, \[
|\rho(X,Y)|\le 1 .
\] Egalitatea \(|\rho(X,Y)|=1\) are loc dacă și numai dacă între \(X\) și \(Y\) există (cu probabilitate 1) o relație liniară \(Y=aX+b\), cu \(a\ne0\); mai precis, \(\rho=1\) dacă \(a>0\) și \(\rho=-1\) dacă \(a<0\).
Demonstrație. Conform observației de mai sus, putem presupune (înlocuind \(X,Y\) cu variantele standardizate) că \(\E[X]=\E[Y]=0\) și \(\Var(X)=\Var(Y)=1\), deci \(\E[X^2]=\E[Y^2]=1\) și \(\rho(X,Y)=\E[XY]\). Pentru orice \(\lambda\in\R\), \[
0\le\E\big[(X+\lambda Y)^2\big]=\lambda^2\E[Y^2]+2\lambda\E[XY]+\E[X^2]=\lambda^2+2\lambda\rho+1 .
\] Un polinom de gradul doi în \(\lambda\) care este nenegativ pentru orice \(\lambda\) are discriminantul nepozitiv: \(\Delta=4\rho^2-4\le0\), adică \(\rho^2\le1\). (Aceeași idee, aplicată fără standardizare, conduce la inegalitatea Cauchy–Schwarz \((\E[XY])^2\le\E[X^2]\E[Y^2]\), pe care o vom regăsi în Cursul 7.)
Să presupunem acum că \(\rho=1\). Atunci \(\E[(X+\lambda Y)^2]=\lambda^2+2\lambda+1=(\lambda+1)^2\), iar pentru \(\lambda=-1\) obținem \(\E[(X-Y)^2]=0\). O variabilă nenegativă cu media 0 este nulă cu probabilitate 1, deci \(\PP(X=Y)=1\). Revenind la variabilele inițiale, \(\frac{X-\mu_X}{\sigma_X}=\frac{Y-\mu_Y}{\sigma_Y}\) cu probabilitate 1, adică \[
Y=\frac{\sigma_Y}{\sigma_X}X+\frac{\sigma_X\mu_Y-\sigma_Y\mu_X}{\sigma_X}=aX+b,\qquad a=\frac{\sigma_Y}{\sigma_X}>0 .
\] Cazul \(\rho=-1\) se tratează analog, cu \(\lambda=1\), obținând \(a<0\). Reciproc, dacă \(Y=aX+b\), atunci \(\Cov(X,Y)=a\sigma_X^2\), \(\sigma_Y=|a|\sigma_X\) și \(\rho=a/|a|=\pm1\).■
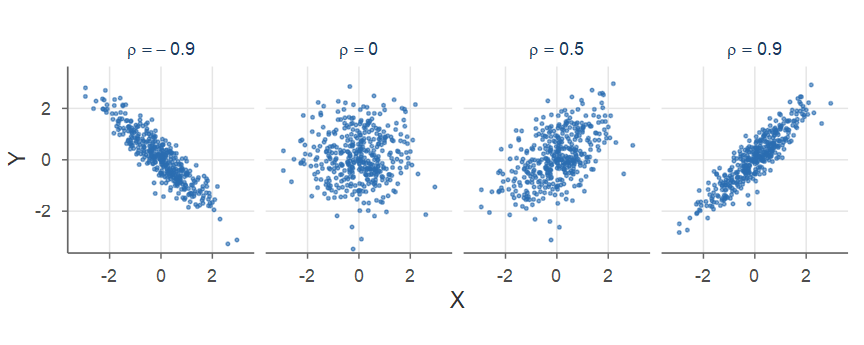
Coeficientul de corelație măsoară deci cât de aproape de o dreaptă se află repartiția punctelor \((X,Y)\) (Figura 8): \(\rho>0\) indică o tendință liniară crescătoare, \(\rho<0\) una descrescătoare, iar \(\rho=0\) absența unei tendințe liniare — ceea ce, după cum am văzut în Exemplul 16, nu exclude o dependență neliniară puternică.
Figura 8: Nori de câte 400 de puncte simulate din repartiția normală bidimensională standard cu diferite valori ale coeficientului de corelație \(\rho\).
Exemplul 17(Covarianța și corelația pentru un tabel de repartiție)
Pentru vectorul din Exemplul 4 am calculat \(\E[X]=\frac{37}{18}\), \(\E[Y]=\frac{13}{18}\) și \(\E[XY]=\frac{29}{18}\), deci \[
\Cov(X,Y)=\frac{29}{18}-\frac{37}{18}\cdot\frac{13}{18}=\frac{522-481}{324}=\frac{41}{324}\approx0.127 .
\] Mai departe, \(\E[X^2]=\frac{6+20+63}{18}=\frac{89}{18}\), \(\E[Y^2]=\frac{3+32}{18}=\frac{35}{18}\), de unde \(\Var(X)=\frac{89}{18}-\big(\frac{37}{18}\big)^2=\frac{233}{324}\) și \(\Var(Y)=\frac{35}{18}-\big(\frac{13}{18}\big)^2=\frac{461}{324}\). Coeficientul de corelație este \(\rho(X,Y)=\frac{41}{\sqrt{233\cdot461}}\approx0.125\): o corelație pozitivă slabă.
VX <-sum(x^2* pX) - EX^2; VY <-sum(y^2* pY) - EY^2# x, y, P din tabelcovXY <- EXY - EX * EYc(Cov = covXY, rho = covXY /sqrt(VX * VY))
#>    Cov    rho
#> 0.1265 0.1251
6.1 Corelația ca un cosinus. Corelația calculată din date
De ce tocmai media unui produs măsoară legătura dintre două variabile? În Secțiunea 5 am privit variabilele aleatoare ca pe niște vectori, cu produsul scalar \(\langle U,V\rangle=\E[UV]\) și „lungimea” \(\|U\|=\sqrt{\E[U^2]}\). Pentru variabilele centrate\(U=X-\mu_X\) și \(V=Y-\mu_Y\) avem \(\langle U,V\rangle=\Cov(X,Y)\), \(\|U\|=\sigma_X\) și \(\|V\|=\sigma_Y\), deci \[
\rho(X,Y)=\frac{\langle U,V\rangle}{\|U\|\,\|V\|}=\cos\theta ,
\] formula cosinusului unghiului \(\theta\) dintre doi vectori din plan. Teorema 36 capătă astfel un sens geometric: un cosinus este cuprins între \(-1\) și \(1\) (inegalitatea Cauchy–Schwarz), \(|\rho|=1\) înseamnă vectori coliniari, iar \(\rho=0\) vectori perpendiculari(pentru detalii, Chan 2021, sec. 5.2). Pentru date, unghiul este unul obișnuit, între doi vectori din \(\R^n\).
Definiția 37(Coeficientul de corelație empiric)
Fie \((x_1,y_1),\dots,(x_n,y_n)\) perechi de date, cu mediile \(\bar x=\frac1n\sum_ix_i\) și \(\bar y=\frac1n\sum_iy_i\) (șirurile \(x\) și \(y\) nefiind constante). Coeficientul de corelație empiric este \[
r=\frac{\sum_{i=1}^n(x_i-\bar x)(y_i-\bar y)}{\sqrt{\sum_{i=1}^n(x_i-\bar x)^2}\,\sqrt{\sum_{i=1}^n(y_i-\bar y)^2}}=\frac{x_c\cdot y_c}{\|x_c\|\,\|y_c\|},
\] adică cosinusul unghiului dintre vectorii centrați \(x_c=(x_i-\bar x)_{i}\) și \(y_c=(y_i-\bar y)_{i}\) din \(\R^n\). În R: cor(x, y).
Fiind coeficientul de corelație al perechii \((X,Y)\) care ia fiecare valoare \((x_i,y_i)\) cu probabilitatea \(1/n\), \(r\) verifică \(|r|\le1\), cu egalitate exact atunci când toate punctele \((x_i,y_i)\) sunt pe o dreaptă.
Exemplul 18(Cât de asemănătoare sunt gusturile a doi utilizatori?)
Doi utilizatori ai unei platforme de filme au notat aceleași cinci filme: \(x=(1,2,3,4,5)\) și \(y=(2,1,4,3,5)\). Ambele medii sunt \(3\), deci \(x_c=(-2,-1,0,1,2)\), \(y_c=(-1,-2,1,0,2)\), \(x_c\cdot y_c=2+2+0+0+4=8\) și \(\|x_c\|^2=\|y_c\|^2=10\). Rezultă \(r=\frac{8}{\sqrt{10}\cdot\sqrt{10}}=0.8\), adică un unghi \(\theta=\arccos0.8\approx37^\circ\): vectorii centrați au aproape aceeași direcție, deci utilizatorii au gusturi apropiate, iar un sistem de recomandare îi poate propune fiecăruia filmele apreciate de celălalt.
x <-c(1, 2, 3, 4, 5); y <-c(2, 1, 4, 3, 5) # notele celor doi utilizatorixc <- x -mean(x); yc <- y -mean(y) # vectorii centrațic(cosinus =sum(xc * yc) /sqrt(sum(xc^2) *sum(yc^2)), cor =cor(x, y),cos_necentrat =sum(x * y) /sqrt(sum(x^2) *sum(y^2)))
Primele două valori coincid. A treia, \(\frac{x\cdot y}{\|x\|\,\|y\|}=\frac{53}{55}\), este similaritatea cosinus a vectorilor necentrați, folosită în informatică la compararea documentelor sau a profilurilor de utilizatori: corelația este similaritatea cosinus de după centrare.
6.2 Repartiția normală bidimensională
Cea mai importantă repartiție a unui vector aleator continuu este generalizarea repartiției normale. O menționăm pe scurt; ea a fost folosită pentru a genera norii de puncte din Figura 8.
Definiția 38(Repartiția normală bidimensională)
Vectorul \((X,Y)\) are repartiție normală bidimensională de parametri \(\mu_1,\mu_2\in\R\), \(\sigma_1,\sigma_2>0\) și \(\rho\in(-1,1)\) dacă are densitatea \[
f_{X,Y}(x,y)=\frac{1}{2\pi\sigma_1\sigma_2\sqrt{1-\rho^2}}\exp\Big\{-\frac{u^2-2\rho uv+v^2}{2(1-\rho^2)}\Big\},\qquad u=\frac{x-\mu_1}{\sigma_1},\ v=\frac{y-\mu_2}{\sigma_2}.
\]
Se poate arăta (prin calcul direct, completând pătratul în exponent) că, pentru această repartiție:
marginalele sunt normale: \(X\sim\Norm(\mu_1,\sigma_1^2)\), \(Y\sim\Norm(\mu_2,\sigma_2^2)\), iar \(\rho(X,Y)=\rho\);
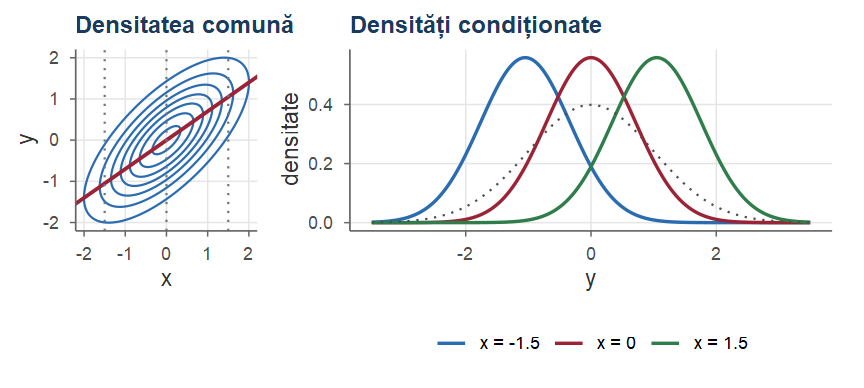
repartițiile condiționate sunt normale: \(Y\mid X=x\sim\Norm\big(\mu_2+\rho\frac{\sigma_2}{\sigma_1}(x-\mu_1),\ \sigma_2^2(1-\rho^2)\big)\); în particular \(\E[Y\mid X]\) este o funcție liniară de \(X\) (dreapta de regresie), iar varianța condiționată nu depinde de \(x\) (Figura 9);
\(X\) și \(Y\) sunt independente dacă și numai dacă \(\rho=0\): pentru \(\rho=0\) exponentul se descompune într-o sumă și densitatea se factorizează;
dacă \(Z_1,Z_2\sim\Norm(0,1)\) sunt independente, atunci \(X=\mu_1+\sigma_1Z_1\), \(Y=\mu_2+\sigma_2\big(\rho Z_1+\sqrt{1-\rho^2}\,Z_2\big)\) are repartiția de mai sus (așa se simulează în practică).
Figura 9: Repartiția normală bidimensională standard cu \(\rho=0.7\). Stânga: curbe de nivel ale densității comune și dreapta de regresie \(\E[Y\mid X=x]=\rho x\). Dreapta: densitățile condiționate \(f_{Y\mid X}(y\mid x)\), adică \(\mathcal{N}(\rho x, 1-\rho^2)\), pentru trei valori ale lui \(x\), comparate cu densitatea marginală \(f_Y\) (linie punctată).
6.3 Vectorul medie și matricea de covarianță
O observație are rareori doar două componente: o imagine este un vector de intensități ale pixelilor, iar starea unui server este descrisă de mai mulți indicatori. Mediile, varianțele și covarianțele componentelor se organizează într-un vector și într-o matrice (pentru detalii, Chan 2021, sec. 5.6).
Definiția 39(Vectorul medie și matricea de covarianță)
Fie \(\mathbf X=(X_1,\dots,X_d)^\top\) un vector aleator ale cărui componente au varianțe finite. Vectorul medie și matricea de covarianță ale lui \(\mathbf X\) sunt \[
\mu=\E[\mathbf X]=\begin{pmatrix}\E[X_1]\\ \vdots\\ \E[X_d]\end{pmatrix},\qquad
\Sigma=\Cov(\mathbf X)=\begin{pmatrix}
\Var(X_1) & \cdots & \Cov(X_1,X_d)\\
\vdots & \ddots & \vdots\\
\Cov(X_d,X_1) & \cdots & \Var(X_d)
\end{pmatrix},
\] adică \(\Sigma_{ij}=\Cov(X_i,X_j)\): varianțele se află pe diagonală, iar covarianțele în afara ei (pentru \(d=2\), \(\Sigma_{12}=\Sigma_{21}=\rho\,\sigma_1\sigma_2\)).
Propoziția 40(Proprietățile matricei de covarianță)
Fie \(\mathbf X\) un vector aleator cu vectorul medie \(\mu\) și matricea de covarianță \(\Sigma\).
\(\Sigma\) este simetrică; dacă \(X_1,\dots,X_d\) sunt independente (sau doar necorelate două câte două), \(\Sigma\) este diagonală.
Pentru orice \(\mathbf a=(a_1,\dots,a_d)^\top\in\R^d\), combinația liniară \(\mathbf a^\top\mathbf X=a_1X_1+\dots+a_dX_d\) are media \(\mathbf a^\top\mu\) și varianța \[
\Var(\mathbf a^\top\mathbf X)=\sum_{i=1}^d\sum_{j=1}^da_ia_j\Cov(X_i,X_j)=\mathbf a^\top\Sigma\,\mathbf a\ \ge0,
\] deci \(\Sigma\) este pozitiv semidefinită.
Dacă \(A\) este o matrice \(m\times d\) și \(\mathbf b\in\R^m\), vectorul \(\mathbf Y=A\mathbf X+\mathbf b\) are \(\E[\mathbf Y]=A\mu+\mathbf b\) și \(\Cov(\mathbf Y)=A\,\Sigma\,A^\top\).
Demonstrație. Simetria rezultă din \(\Cov(X_i,X_j)=\Cov(X_j,X_i)\), iar forma diagonală din Propoziția 33. La b), media rezultă din liniaritate, iar din biliniaritatea covarianței (Propoziția 34), \(\Var\big(\sum_ia_iX_i\big)=\Cov\big(\sum_ia_iX_i,\sum_ja_jX_j\big)=\sum_i\sum_ja_ia_j\Cov(X_i,X_j)\), expresie nenegativă, fiind o varianță. Punctul c) se obține la fel, pentru fiecare pereche de componente ale lui \(\mathbf Y\): \(\Cov(Y_k,Y_l)=\sum_{i,j}A_{ki}\Sigma_{ij}A_{lj}=(A\Sigma A^\top)_{kl}\).■
Exemplul 19(Două operații cu o etapă comună)
Două operații executate pe același server au duratele (în milisecunde) \(X_1=U+W\) și \(X_2=V+W\), unde \(W\) este durata unei etape comune (accesul la disc), iar \(U,V,W\) sunt independente, cu mediile \(1,6,3\) și varianțele \(1,6,3\). Atunci \(\mathbf X=(X_1,X_2)^\top=A\,(U,V,W)^\top\) și, din Propoziția 40 c), \[
A=\begin{pmatrix}1&0&1\\0&1&1\end{pmatrix},\qquad
\mu=A\begin{pmatrix}1\\6\\3\end{pmatrix}=\begin{pmatrix}4\\9\end{pmatrix},\qquad
\Sigma=A\begin{pmatrix}1&0&0\\0&6&0\\0&0&3\end{pmatrix}A^\top=\begin{pmatrix}4&3\\3&9\end{pmatrix}.
\] Etapa comună face ca duratele să fie corelate: \(\Cov(X_1,X_2)=\Var(W)=3\) și \(\rho(X_1,X_2)=\frac{3}{2\cdot3}=0.5\). Durata totală \(X_1+X_2=\mathbf a^\top\mathbf X\), cu \(\mathbf a=(1,1)^\top\), are varianța \(\mathbf a^\top\Sigma\,\mathbf a=4+9+2\cdot3=19\), și nu \(4+9=13\), cât am obține ignorând dependența.
6.4 Simularea vectorilor normali corelați
Pentru a testa un algoritm pe date sintetice avem nevoie de vectori cu o medie și o matrice de covarianță date, dar rnorm produce numai valori independente. Corelația se introduce printr-o transformare liniară: un vector \(\mathbf Z\) cu componente \(\Norm(0,1)\) independente are media \(0\) și matricea de covarianță \(I_d\), deci, din Propoziția 40 c), \(\mu+L\,\mathbf Z\) are media \(\mu\) și matricea de covarianță \(L\,I_d\,L^\top=LL^\top\)(pentru detalii, Chan 2021, sec. 5.7).
Propoziția 41(Vectori normali cu medie și matrice de covarianță date)
Fie \(\mathbf Z=(Z_1,\dots,Z_d)^\top\), cu \(Z_1,\dots,Z_d\sim\Norm(0,1)\) independente, \(\mu\in\R^d\) și \(L\) o matrice \(d\times d\); notăm \(\Sigma=LL^\top\). Atunci vectorul \(\mathbf X=\mu+L\,\mathbf Z\) are vectorul medie \(\mu\) și matricea de covarianță \(\Sigma\), iar componentele sale, combinații liniare de variabile normale independente, sunt normale (Propoziția 43). Pentru \(d=2\) și \[
L=\begin{pmatrix}\sigma_1&0\\ \rho\,\sigma_2&\sigma_2\sqrt{1-\rho^2}\end{pmatrix}\qquad\text{avem}\qquad
LL^\top=\begin{pmatrix}\sigma_1^2&\rho\sigma_1\sigma_2\\ \rho\sigma_1\sigma_2&\sigma_2^2\end{pmatrix},
\] iar \(\mathbf X=(X_1,X_2)^\top\), cu \(X_1=\mu_1+\sigma_1Z_1\) și \(X_2=\mu_2+\sigma_2\big(\rho Z_1+\sqrt{1-\rho^2}\,Z_2\big)\), are repartiția normală bidimensională din Definiția 38.
Exemplul 20(Înălțimi și greutăți simulate)
Vrem un eșantion de înălțimi (cm) și greutăți (kg) cu mediile \(170\) și \(70\), abaterile standard \(\sigma_1=8\) și \(\sigma_2=10\) și corelația \(\rho=0.6\), deci cu covarianța \(0.6\cdot8\cdot10=48\): \[
\mu=\begin{pmatrix}170\\70\end{pmatrix},\qquad \Sigma=\begin{pmatrix}64&48\\48&100\end{pmatrix},\qquad
L=\begin{pmatrix}8&0\\ 0.6\cdot10&10\sqrt{1-0.6^2}\end{pmatrix}=\begin{pmatrix}8&0\\6&8\end{pmatrix}.
\] Înălțimea este \(X_1=170+8Z_1\), iar greutatea \(X_2=70+6Z_1+8Z_2\): \(6Z_1\) este partea „explicată” de înălțime, iar \(8Z_2\) variația proprie a greutății. Matricea inferior triunghiulară \(L\) este factorul Cholesky al lui \(\Sigma\); în R: t(chol(Sigma)).
Pentru date, fiecare observație a vectorului este o linie a unei matrice cu \(d\) coloane; colMeans estimează vectorul medie, iar cov și cor matricea de covarianță și pe cea a corelațiilor.
set.seed(3)mu <-c(170, 70); Sigma <-matrix(c(64, 48, 48, 100), nrow =2)L <-t(chol(Sigma)); n <-2000# factorul Cholesky: (8 0; 6 8)Z <-matrix(rnorm(2* n), nrow =2) # fiecare coloană: un vector ZX <-t(mu + L %*% Z) # n linii: (înălțime, greutate)round(c(medie =colMeans(X), ab_std =apply(X, 2, sd),cov =cov(X)[1, 2], cor =cor(X)[1, 2]), 2)
Figura 10: Cele 2000 de perechi (înălțime, greutate) simulate cu \(\rho=0.6\), elipsa în care vectorul se află cu probabilitatea \(0.95\) și direcțiile vectorilor proprii ai matricei \(\Sigma\) (cu roșu, direcția de împrăștiere maximă).
Observație
Vectorul propriu al lui \(\Sigma\) asociat celei mai mari valori proprii \(\lambda_1\) dă direcția pe care proiecția \(\mathbf a^\top\mathbf X\) are varianța maximă, egală cu \(\lambda_1\) (în R, eigen(Sigma); aici \(\lambda_1\approx133.3\), adică \(81\%\) din varianța totală \(64+100\)). Pe această idee se bazează analiza în componente principale (PCA), care reduce dimensiunea datelor cu multe componente, cum sunt imaginile, păstrând doar proiecțiile pe câteva direcții de împrăștiere maximă (Chan 2021, sec. 5.8).
7 Sume de variabile aleatoare independente
O întrebare care apare frecvent este: dacă \(X\) și \(Y\) sunt independente și le cunoaștem repartițiile, care este repartiția sumei \(Z=X+Y\)? Media și varianța sumei le cunoaștem deja; repartiția completă se obține prin convoluție.
Propoziția 42(Formula de convoluție)
Fie \(X\) și \(Y\) variabile aleatoare independente și \(Z=X+Y\).
Dacă \(X\) și \(Y\) sunt discrete, cu valori întregi, \(\displaystyle p_Z(z)=\sum_{x}p_X(x)\,p_Y(z-x)\).
Dacă \(X\) și \(Y\) sunt continue, cu densitățile \(f_X\) și \(f_Y\), atunci \(Z\) este continuă, cu densitatea \[
f_Z(z)=\int_{-\infty}^{+\infty}f_X(x)\,f_Y(z-x)\dd x .
\]
Demonstrație.
Cu formula probabilității totale după valorile lui \(X\) și independența, \(\PP(Z=z)=\sum_x\PP(X=x,\ Y=z-x)=\sum_x p_X(x)p_Y(z-x)\).
Analog, condiționând la \(X=x\) (Tabelul F.P.T., cazul continuu): \(\PP(Z\le z\mid X=x)=\PP(Y\le z-x)=F_Y(z-x)\) datorită independenței, deci \(F_Z(z)=\int F_Y(z-x)f_X(x)\dd x\). Derivând în raport cu \(z\) (sub integrală), \(f_Z(z)=\int f_Y(z-x)f_X(x)\dd x\).
■
Exemplul 21(Suma a două variabile Poisson independente)
Fie \(X\sim\Pois(\lambda)\) și \(Y\sim\Pois(\mu)\) independente. Pentru \(n\ge0\), cu formula de convoluție și binomul lui Newton, \[
\PP(X+Y=n)=\sum_{k=0}^n e^{-\lambda}\frac{\lambda^k}{k!}\,e^{-\mu}\frac{\mu^{n-k}}{(n-k)!}=\frac{e^{-(\lambda+\mu)}}{n!}\sum_{k=0}^n\binom nk\lambda^k\mu^{n-k}=e^{-(\lambda+\mu)}\frac{(\lambda+\mu)^n}{n!},
\] deci \(X+Y\sim\Pois(\lambda+\mu)\). Împreună cu descompunerea din Exemplul 3, obținem o imagine completă: sumele de variabile Poisson independente sunt Poisson, iar o variabilă Poisson „subțiată” aleator se descompune în variabile Poisson independente. Mai mult, repartiția condiționată a lui \(X\) la \(X+Y=n\) este binomială, \(\Bin\big(n,\frac{\lambda}{\lambda+\mu}\big)\) (exercițiu).
Exemplul 22(Suma de variabile exponențiale independente)
Fie \(X,Y\sim\Exp(\lambda)\) independente. Densitatea \(f_X(x)f_Y(z-x)\) este nenulă doar pentru \(x>0\) și \(z-x>0\), deci pentru \(z>0\), \[
f_{X+Y}(z)=\int_0^z\lambda e^{-\lambda x}\,\lambda e^{-\lambda(z-x)}\dd x=\lambda^2e^{-\lambda z}\int_0^z\dd x=\lambda^2z\,e^{-\lambda z},
\] adică \(X+Y\sim\GammaD(2,\lambda)\). Prin inducție se arată că, dacă \(X_1,\dots,X_n\sim\Exp(\lambda)\) sunt independente, atunci \[
X_1+\dots+X_n\sim\GammaD(n,\lambda),\qquad f(z)=\frac{\lambda^n z^{n-1}}{(n-1)!}e^{-\lambda z},\ z>0 .
\] Interpretare: dacă duratele dintre sosirile succesive ale unor clienți sunt \(\Exp(\lambda)\) independente, momentul sosirii celui de-al \(n\)-lea client are repartiția \(\GammaD(n,\lambda)\).
Propoziția 43(Suma de variabile normale independente)
Dacă \(X\sim\Norm(\mu_1,\sigma_1^2)\) și \(Y\sim\Norm(\mu_2,\sigma_2^2)\) sunt independente, atunci \[
X+Y\sim\Norm(\mu_1+\mu_2,\ \sigma_1^2+\sigma_2^2).
\] Mai general, orice combinație liniară \(a_1X_1+\dots+a_nX_n+b\) de variabile normale independente este normală.
Demonstrație. Arătăm cazul \(X,Y\sim\Norm(0,1)\); cazul general se reduce la acesta prin transformări afine (sau se obține direct cu funcțiile generatoare de momente; vezi (Blitzstein and Hwang 2019, cap. 6)). Cu formula de convoluție și identitatea \(x^2+(z-x)^2=2\big(x-\frac z2\big)^2+\frac{z^2}{2}\), \[
f_{X+Y}(z)=\int_{\R}\frac{1}{2\pi}e^{-\frac{x^2+(z-x)^2}{2}}\dd x=\frac{1}{2\pi}e^{-\frac{z^2}{4}}\int_{\R} e^{-(x-z/2)^2}\dd x=\frac{1}{2\pi}e^{-\frac{z^2}{4}}\sqrt\pi=\frac{1}{\sqrt{2\pi\cdot2}}e^{-\frac{z^2}{2\cdot2}},
\] care este densitatea repartiției \(\Norm(0,2)\).■
Media și varianța sumei rezultă, desigur, și direct din liniaritatea mediei și din Propoziția 34; noutatea propoziției este că suma rămâne normală. Acest fapt va fi esențial în statistică (Cursul 8), de exemplu pentru repartiția mediei de selecție \(\Xbar\) a unui eșantion normal.
Legătura cu cursurile următoare. Media și varianța sumelor de variabile independente, împreună cu inegalitatea Cauchy–Schwarz (întâlnită astăzi sub forma \(|\rho|\le1\)), sunt punctul de plecare pentru inegalitățile și teoremele limită din Cursul 7: Legea Numerelor Mari și Teorema Limită Centrală. În Cursul 8 un eșantion va fi modelat ca un vector de variabile aleatoare independente și identic repartizate, iar faptul că suma de variabile normale independente este normală va da repartiția mediei de selecție. Formula lui Bayes pentru densități este motorul statisticii bayesiene (Cursul 11), iar media condiționată, ca cel mai bun predictor, împreună cu covarianța și corelația, stă la baza regresiei liniare din Cursul 14.
8 Exerciții rezolvate
Exercițiul 1(Testarea tranzistorilor)
Un lot de 5 tranzistori conține 2 tranzistori defecți. Tranzistorii sunt testați unul câte unul, într-o ordine aleatoare, până când ambii tranzistori defecți sunt identificați (un tranzistor poate fi identificat și prin deducție, fără a fi testat). Fie \(N_1\) numărul de teste efectuate până la identificarea primului tranzistor defect și \(N_2\) numărul de teste suplimentare efectuate până la identificarea celui de-al doilea.
Determinați repartiția comună a lui \((N_1,N_2)\) și repartițiile marginale.
Sunt \(N_1\) și \(N_2\) independente?
Calculați numărul mediu total de teste și \(\Cov(N_1,N_2)\).
Soluție
Numerotăm tranzistorii în ordinea testării, \(T_1,\dots,T_5\). Perechea de tranzistori defecți este aleasă uniform dintre cele \(\binom52=10\) perechi posibile, fiecare cu probabilitatea \(1/10\). Pentru fiecare pereche determinăm \((N_1,N_2)\):
\((T_1,T_2)\): \(N_1=1\), \(N_2=1\); \((T_1,T_3)\): \(N_1=1\), \(N_2=2\); \((T_1,T_4)\) și \((T_1,T_5)\): \(N_1=1\), \(N_2=3\) (după testarea lui \(T_4\) știm care este al doilea defect);
\((T_3,T_4)\), \((T_3,T_5)\): \(N_1=3\), \(N_2=1\); \((T_4,T_5)\): după trei teste cu rezultat bun știm că \(T_4,T_5\) sunt defecți, deci \(N_1=3\), \(N_2=0\).
\(\E[N_1]=0.4+0.6+0.9=1.9\) și \(\E[N_2]=0.4+0.6+0.6=1.6\), deci numărul mediu total de teste este \(\E[N_1+N_2]=3.5\). Mai departe, \(\E[N_1N_2]=1\cdot(0.1+0.2+0.6)+2\cdot(0.1+0.4)+3\cdot0.2=0.9+1+0.6=2.5\), deci \(\Cov(N_1,N_2)=2.5-1.9\cdot1.6=-0.54\): un prim defect găsit târziu înseamnă că mai rămân puține teste pentru al doilea.
Exercițiul 2(Tabel de repartiție: medie și varianță condiționată)
Determinați repartițiile marginale, \(\E[Y]\) și \(\Var(Y)\).
Determinați repartițiile condiționate \(Y\mid X=1\) și \(X\mid Y=4\).
Determinați variabilele aleatoare \(\E[Y\mid X]\) și \(\Var(Y\mid X)\) și verificați legea varianței totale.
Calculați coeficientul de corelație \(\rho(X,Y)\).
Soluție
Sumând pe linii, respectiv pe coloane, \[
X\sim\begin{pmatrix}0&1&2&3\\ 0.4&0.3&0.2&0.1\end{pmatrix},\qquad Y\sim\begin{pmatrix}2&4&6\\ 0.35&0.4&0.25\end{pmatrix}.
\]\(\E[Y]=0.7+1.6+1.5=3.8\), \(\E[Y^2]=1.4+6.4+9=16.8\), deci \(\Var(Y)=16.8-3.8^2=2.36\).
Normalizăm linia \(x=1\) (suma \(0.3\)), respectiv coloana \(y=4\) (suma \(0.4\)): \[
Y\mid X=1\sim\begin{pmatrix}2&4&6\\ \frac13&\frac13&\frac13\end{pmatrix},\qquad X\mid Y=4\sim\begin{pmatrix}0&1&2&3\\ \frac12&\frac14&\frac14&0\end{pmatrix}.
\]
Pentru fiecare \(x\) calculăm media și varianța repartiției \(Y\mid X=x\). De exemplu, \(Y\mid X=0\sim\begin{pmatrix}2&4&6\\ 1/4&1/2&1/4\end{pmatrix}\), deci \(\E[Y\mid X=0]=4\) și \(\Var(Y\mid X=0)=\big(4\cdot\frac14+16\cdot\frac12+36\cdot\frac14\big)-16=2\). Analog: \[
\begin{array}{c|cccc}
x & 0 & 1 & 2 & 3\\ \hline
\E[Y\mid X=x] & 4 & 4 & 3 & 4\\
\Var(Y\mid X=x) & 2 & 8/3 & 1 & 4\\
\PP(X=x) & 0.4 & 0.3 & 0.2 & 0.1
\end{array}
\qquad\Rightarrow\qquad
\E[Y\mid X]\sim\begin{pmatrix}3&4\\ 0.2&0.8\end{pmatrix}.
\] Variabila \(\Var(Y\mid X)\) ia valorile \(1,2,\frac83,4\) cu probabilitățile \(0.2,0.4,0.3,0.1\). Atunci \(\E[\Var(Y\mid X)]=0.2+0.8+0.8+0.4=2.2\) și \(\Var(\E[Y\mid X])=9\cdot0.2+16\cdot0.8-3.8^2=0.16\), iar suma lor este \(2.36=\Var(Y)\), conform legii lui Eve. Observăm și legea lui Adam: \(\E[\E[Y\mid X]]=0.6+3.2=3.8=\E[Y]\).
\(\E[X]=0.3+0.4+0.3=1\), \(\E[X^2]=0.3+0.8+0.9=2\), deci \(\Var(X)=1\). Sumând \(xy\,p_{X,Y}(x,y)\) pe linii: \(\E[XY]=1\cdot1.2+2\cdot0.6+3\cdot0.4=3.6\). Rezultă \(\Cov(X,Y)=3.6-1\cdot3.8=-0.2\) și \(\rho(X,Y)=\frac{-0.2}{\sqrt{1\cdot2.36}}\approx-0.130\).
Determinați densitățile marginale. Sunt \(X\) și \(Y\) independente?
Determinați funcțiile de repartiție \(F_X\), \(F_Y\) și \(F_{X,Y}\).
Determinați densitățile condiționate \(f_{X\mid Y}\) și \(f_{Y\mid X}\).
Calculați \(\E[X\mid Y]\) și \(\Var(X\mid Y)\).
Calculați coeficientul de corelație \(\rho(X,Y)\).
Soluție
Din \(f_{X,Y}\ge0\) rezultă \(k\ge0\), iar din normalizare \[
\begin{aligned}
1&=\int_0^1\!\!\int_0^2k(x+y+1)\dd y\dd x=k\int_0^1\Big(xy+\frac{y^2}{2}+y\Big)\Big|_0^2\dd x\\
&=k\int_0^1(2x+4)\dd x=k(1+4)=5k,
\end{aligned}
\] deci \(k=\frac15\).
Pentru \(x\in[0,1]\), \(f_X(x)=\int_0^2\frac{x+y+1}{5}\dd y=\frac{2x+4}{5}\), iar pentru \(y\in[0,2]\), \(f_Y(y)=\int_0^1\frac{x+y+1}{5}\dd x=\frac{1}{5}\Big(\frac12+y+1\Big)=\frac{2y+3}{10}\) (și zero în rest). Cum \(f_X(x)f_Y(y)=\frac{(2x+4)(2y+3)}{50}\ne\frac{x+y+1}{5}\) (de exemplu în \((0,0)\): \(\frac{12}{50}\ne\frac15\)), \(X\) și \(Y\) nu sunt independente.
Integrând densitățile marginale: \[
F_X(x)=\begin{cases}0,&x<0,\\ \frac{x(x+4)}{5},&0\le x\le1,\\ 1,&x>1,\end{cases}\qquad
F_Y(y)=\begin{cases}0,&y<0,\\ \frac{y(y+3)}{10},&0\le y\le2,\\ 1,&y>2.\end{cases}
\] Pentru \(F_{X,Y}(x,y)=\int_{-\infty}^x\int_{-\infty}^yf_{X,Y}(u,v)\dd v\dd u\) distingem regiunile determinate de dreptunghiul \([0,1]\times[0,2]\). Dacă \(x<0\) sau \(y<0\), \(F_{X,Y}(x,y)=0\). Dacă \(x\in[0,1]\), \(y\in[0,2]\), \[
\begin{aligned}
F_{X,Y}(x,y)&=\int_0^x\!\!\int_0^y\frac{u+v+1}{5}\dd v\dd u=\frac15\int_0^x\Big(uy+\frac{y^2}{2}+y\Big)\dd u\\
&=\frac15\Big(\frac{x^2y}{2}+\frac{xy^2}{2}+xy\Big)=\frac{xy(x+y+2)}{10}.
\end{aligned}
\] Dacă \(x>1\) și \(y\in[0,2]\), integrala după \(u\) se oprește la 1: \(F_{X,Y}(x,y)=F_{X,Y}(1,y)=\frac{y(y+3)}{10}=F_Y(y)\). Dacă \(x\in[0,1]\) și \(y>2\), \(F_{X,Y}(x,y)=F_{X,Y}(x,2)=\frac{x(x+4)}{5}=F_X(x)\). În sfârșit, dacă \(x>1\) și \(y>2\), \(F_{X,Y}(x,y)=1\).
Pentru \(y\in[0,2]\) și, respectiv, \(x\in[0,1]\): \[
\begin{aligned}
f_{X\mid Y}(x\mid y)&=\frac{(x+y+1)/5}{(2y+3)/10}=\frac{2(x+y+1)}{2y+3},\quad x\in[0,1],\\
f_{Y\mid X}(y\mid x)&=\frac{(x+y+1)/5}{(2x+4)/5}=\frac{x+y+1}{2x+4},\quad y\in[0,2].
\end{aligned}
\]
Pentru \(y\in[0,2]\), \[
\E[X\mid Y=y]=\int_0^1x\,\frac{2(x+y+1)}{2y+3}\dd x=\frac{2}{2y+3}\Big(\frac13+\frac y2+\frac12\Big)=\frac{3y+5}{3(2y+3)},
\] deci \(\E[X\mid Y]=\dfrac{3Y+5}{3(2Y+3)}\). Analog, \(\E[X^2\mid Y=y]=\frac{2}{2y+3}\big(\frac14+\frac{y+1}{3}\big)=\frac{4y+7}{6(2y+3)}\), iar \[
\Var(X\mid Y=y)=\frac{4y+7}{6(2y+3)}-\frac{(3y+5)^2}{9(2y+3)^2}=\frac{6y^2+18y+13}{18(2y+3)^2},
\] deci \(\Var(X\mid Y)=\dfrac{6Y^2+18Y+13}{18(2Y+3)^2}\).
Din marginale: \(\E[X]=\int_0^1x\frac{2x+4}{5}\dd x=\frac{8}{15}\), \(\E[X^2]=\frac{11}{30}\), \(\E[Y]=\int_0^2y\frac{2y+3}{10}\dd y=\frac{17}{15}\), \(\E[Y^2]=\frac85\), deci \(\Var(X)=\frac{37}{450}\) și \(\Var(Y)=\frac{71}{225}\). Din densitatea comună, \(\E[XY]=\int_0^1\!\int_0^2xy\frac{x+y+1}{5}\dd y\dd x=\frac35\). Astfel \[
\begin{aligned}
\Cov(X,Y)&=\frac35-\frac8{15}\cdot\frac{17}{15}=-\frac1{225},\\
\rho(X,Y)&=\frac{-1/225}{\sqrt{\frac{37}{450}\cdot\frac{71}{225}}}=-\sqrt{\frac{2}{2627}}\approx-0.0276 .
\end{aligned}
\] Variabilele sunt dependente, dar aproape necorelate.
f <-function(x, y) (x + y +1) /5m <-sapply(list(function(x, y) x, function(x, y) y, function(x, y) x^2,function(x, y) y^2, function(x, y) x * y),function(g) I2(function(x, y) g(x, y) *f(x, y), 0, 1, 0, 2))names(m) <-c("EX", "EY", "EX2", "EY2", "EXY"); MASS::fractions(m)
Exercițiul 4(Suma și produsul a două numere aleatoare)
Se aleg la întâmplare și independent două numere din intervalul \([0,1]\). Care este probabilitatea ca suma lor să nu depășească 1, iar produsul lor să nu depășească \(2/9\)?
Soluție
Fie \(X,Y\sim\Unif(0,1)\) independente. Atunci \(f_{X,Y}(x,y)=\Ind_{[0,1]}(x)\Ind_{[0,1]}(y)\), adică \((X,Y)\) este uniform în pătratul unitate, și \[
\PP\Big(X+Y\le1,\ XY\le\frac29\Big)=\iint_A\dd x\dd y=\mathrm{Aria}(A),
\] unde \(A=\big\{(x,y)\in[0,1]^2\mid x+y\le1,\ xy\le\frac29\big\}\). Dreapta \(x+y=1\) și hiperbola \(xy=\frac29\) se intersectează când \((1-y)y=\frac29\), adică \(9y^2-9y+2=0\), cu rădăcinile \(y=\frac13\) și \(y=\frac23\); punctele de intersecție sunt \(\big(\frac13,\frac23\big)\) și \(\big(\frac23,\frac13\big)\). Între aceste abscise hiperbola se află sub dreaptă, iar în afara lor dreapta se află sub hiperbolă (Figura 11). Împărțim \(A\) în trei părți, după \(x\):
\(A_1\), pentru \(x\in[0,\frac13]\), este trapezul de sub dreaptă: \(\mathrm{Aria}(A_1)=\frac13\cdot\frac{1+\frac23}{2}=\frac5{18}\);
\(A_2\), pentru \(x\in[\frac13,\frac23]\), este regiunea de sub hiperbola \(y=\frac{2}{9x}\): \(\mathrm{Aria}(A_2)=\int_{1/3}^{2/3}\frac{2}{9x}\dd x=\frac29\ln2\);
\(A_3\), pentru \(x\in[\frac23,1]\), este triunghiul de sub dreaptă: \(\mathrm{Aria}(A_3)=\frac12\cdot\frac13\cdot\frac13=\frac1{18}\).
Prin urmare \(\PP\big(X+Y\le1,\ XY\le\frac29\big)=\frac5{18}+\frac1{18}+\frac29\ln2=\frac13+\frac29\ln2\approx0.4874\).
set.seed(9); u <-runif(1e6); v <-runif(1e6)c(simulat =mean(u + v <=1& u * v <=2/9), exact =1/3+2/9*log(2))
Figura 11: Regiunea \(A=\{x+y\le1,\ xy\le 2/9\}\) din Exercițiul 4, împărțită în \(A_1\) (trapez), \(A_2\) (sub hiperbolă) și \(A_3\) (triunghi).
Exercițiul 5(Corelația dintre minim și maxim pentru normale)
Fie \(X,Y\sim\Norm(0,1)\) independente, \(M=\max(X,Y)\) și \(L=\min(X,Y)\). Arătați că \(\rho(M,L)=\dfrac{1}{\pi-1}\).
Soluție
Observăm că \(M+L=X+Y\) și \(M-L=|X-Y|\).
Mediile. Din prima relație, \(\E[M]+\E[L]=\E[X]+\E[Y]=0\). Cum \(X-Y\sim\Norm(0,2)\) (Propoziția 43), putem scrie \(X-Y=\sqrt2Z\) cu \(Z\sim\Norm(0,1)\), iar \(\E|Z|=2\int_0^\infty z\frac{1}{\sqrt{2\pi}}e^{-z^2/2}\dd z=\sqrt{2/\pi}\). Deci \(\E[M]-\E[L]=\E|X-Y|=\sqrt2\sqrt{2/\pi}=\frac{2}{\sqrt\pi}\), de unde \(\E[M]=\frac1{\sqrt\pi}\) și \(\E[L]=-\frac1{\sqrt\pi}\).
Covarianța. Cum \(ML=XY\) (produsul celor două numere nu depinde de ordinea lor), \(\E[ML]=\E[X]\E[Y]=0\), deci \(\Cov(M,L)=0-\E[M]\E[L]=\frac1\pi\).
Varianțele. Deoarece \((X,Y)\) și \((-X,-Y)\) au aceeași repartiție și \(\max(X,Y)=-\min(-X,-Y)\), variabilele \(M\) și \(-L\) au aceeași repartiție; în particular \(\Var(M)=\Var(L)\). Din \(\Var(M+L)=\Var(X+Y)=2\) și proprietatea f) a covarianței, \(\Var(M)+\Var(L)+2\Cov(M,L)=2\), deci \(2\Var(M)=2-\frac2\pi\), adică \(\Var(M)=\Var(L)=1-\frac1\pi\).
set.seed(10); a <-rnorm(1e6); b <-rnorm(1e6)c(simulat =cor(pmax(a, b), pmin(a, b)), exact =1/ (pi -1))
#> simulat   exact
#>  0.4649  0.4669
Exercițiul 6(Minimul și maximul a două uniforme)
Fie \(X,Y\sim\Unif(0,1)\) independente, \(M=\max(X,Y)\) și \(L=\min(X,Y)\). Calculați \(\E[M]\), \(\E[L]\), \(\Cov(M,L)\) și \(\rho(M,L)\).
Soluție
Folosim aceeași idee ca în exercițiul precedent. Din \(M+L=X+Y\) avem \(\E[M]+\E[L]=1\), iar din \(M-L=|X-Y|\) și Exemplul 13, \(\E[M]-\E[L]=\frac13\). Rezultă \(\E[M]=\frac23\) și \(\E[L]=\frac13\).
Cum \(ML=XY\), \(\E[ML]=\E[X]\E[Y]=\frac14\), deci \(\Cov(M,L)=\frac14-\frac23\cdot\frac13=\frac1{36}\).
Pentru varianțe, \(F_M(t)=\PP(X\le t,Y\le t)=t^2\) pe \([0,1]\), deci \(f_M(t)=2t\), \(\E[M^2]=\int_0^12t^3\dd t=\frac12\) și \(\Var(M)=\frac12-\frac49=\frac1{18}\). Prin simetrie (\(1-L=\max(1-X,1-Y)\), cu \(1-X,1-Y\sim\Unif(0,1)\) independente), \(\Var(L)=\Var(M)=\frac1{18}\). Așadar \[
\rho(M,L)=\frac{1/36}{1/18}=\frac12 .
\]
Exercițiul 7(O densitate pe un domeniu nemărginit)
Vectorul \((X,Y)\) are densitatea \(f_{X,Y}(x,y)=e^{-y}\) pentru \(0<x<y\) și \(0\) în rest.
Verificați că \(f_{X,Y}\) este o densitate și determinați densitățile marginale.
Determinați densitățile condiționate \(f_{X\mid Y}\) și \(f_{Y\mid X}\) și mediile condiționate corespunzătoare.
Calculați \(\Cov(X,Y)\) și \(\rho(X,Y)\).
Soluție
Avem \(f_{X,Y}\ge0\) și \(\int_0^\infty\int_0^ye^{-y}\dd x\dd y=\int_0^\infty ye^{-y}\dd y=1\). Marginalele: pentru \(x>0\), \(f_X(x)=\int_x^\infty e^{-y}\dd y=e^{-x}\), deci \(X\sim\Exp(1)\); pentru \(y>0\), \(f_Y(y)=\int_0^ye^{-y}\dd x=ye^{-y}\), deci \(Y\sim\GammaD(2,1)\). Variabilele nu sunt independente (suportul \(\{0<x<y\}\) nu este un dreptunghi).
Pentru \(y>0\): \(f_{X\mid Y}(x\mid y)=\frac{e^{-y}}{ye^{-y}}=\frac1y\) pentru \(0<x<y\), adică \(X\mid Y=y\sim\Unif(0,y)\) și \(\E[X\mid Y]=\frac Y2\). Pentru \(x>0\): \(f_{Y\mid X}(y\mid x)=\frac{e^{-y}}{e^{-x}}=e^{-(y-x)}\) pentru \(y>x\), adică \(Y-x\mid X=x\sim\Exp(1)\) (o exponențială „deplasată” în \(x\)) și \(\E[Y\mid X]=X+1\).
\(\E[X]=1\), \(\Var(X)=1\), \(\E[Y]=2\), \(\Var(Y)=2\) (medie și varianță pentru \(\GammaD(2,1)\)). Cu legea lui Adam și proprietatea c) din Teorema 28, \[
\E[XY]=\E\big[\E[XY\mid X]\big]=\E\big[X\,\E[Y\mid X]\big]=\E[X^2]+\E[X]=2+1=3,
\] deci \(\Cov(X,Y)=3-1\cdot2=1\) și \(\rho(X,Y)=\frac1{\sqrt{1\cdot2}}=\frac{1}{\sqrt2}\approx0.707\).
Exercițiul 8(Subțierea Poisson, revăzută)
Fie \(N\sim\Pois(\lambda)\) și, știind \(N=n\), \(X\mid N=n\sim\Bin(n,p)\) (ca în Exemplul 3). Calculați \(\E[X]\) și \(\Var(X)\) cu legile lui Adam și Eve, apoi \(\Cov(N,X)\) și \(\rho(N,X)\).
Soluție
Avem \(\E[X\mid N]=Np\) și \(\Var(X\mid N)=Np(1-p)\). Cu legile lui Adam și Eve, \[
\E[X]=\E[Np]=\lambda p,\qquad \Var(X)=\E[Np(1-p)]+\Var(Np)=\lambda p(1-p)+p^2\lambda=\lambda p,
\] în acord cu \(X\sim\Pois(\lambda p)\). Pentru covarianță scriem \(N=X+Y\), unde \(Y=N-X\) este independentă de \(X\) (Exemplul 3); atunci \(\Cov(N,X)=\Cov(X,X)+\Cov(Y,X)=\Var(X)=\lambda p\). Alternativ, fără a folosi independența: \(\E[NX]=\E[N\,\E[X\mid N]]=p\E[N^2]=p(\lambda+\lambda^2)\), deci \(\Cov(N,X)=p\lambda+p\lambda^2-\lambda\cdot\lambda p=\lambda p\). În final, \[
\rho(N,X)=\frac{\lambda p}{\sqrt{\lambda\cdot\lambda p}}=\sqrt p .
\]
set.seed(12); N <-rpois(1e6, 4); X <-rbinom(1e6, N, 0.3)c(cor_N_X =cor(N, X), sqrt_p =sqrt(0.3), cor_X_Y =cor(X, N - X))
Probabilitatea de succes \(P\) a unui experiment este necunoscută și este modelată ca o variabilă aleatoare \(P\sim\Unif(0,1)\). Știind \(P=p\), efectuăm \(n\) repetiții independente și notăm cu \(X\) numărul de succese, \(X\mid P=p\sim\Bin(n,p)\).
Arătați că \(\PP(X=k)=\frac{1}{n+1}\) pentru \(k=0,1,\dots,n\).
Determinați densitatea a posteriori \(f_{P\mid X}(p\mid k)\) și \(\E[P\mid X=k]\).
Știind că am obținut \(k\) succese în \(n\) încercări, care este probabilitatea unui succes la următoarea încercare?
Soluție
Aceasta este formula probabilității totale cu \(X\) discretă și \(P\) continuă (tabelul F.P.T.). Folosind integrala Beta \(\int_0^1p^k(1-p)^{n-k}\dd p=\frac{k!\,(n-k)!}{(n+1)!}\), \[
\begin{aligned}
\PP(X=k)&=\int_0^1\PP(X=k\mid P=p)f_P(p)\dd p=\binom nk\int_0^1p^k(1-p)^{n-k}\dd p\\
&=\frac{n!}{k!(n-k)!}\cdot\frac{k!(n-k)!}{(n+1)!}=\frac1{n+1}.
\end{aligned}
\]
Cu formula lui Bayes (cazul \(X\) discretă, \(P\) continuă), \[
\begin{aligned}
f_{P\mid X}(p\mid k)&=\frac{\PP(X=k\mid P=p)f_P(p)}{\PP(X=k)}=(n+1)\binom nk p^k(1-p)^{n-k}\\
&=\frac{(n+1)!}{k!(n-k)!}p^k(1-p)^{n-k},\qquad p\in[0,1],
\end{aligned}
\] adică \(P\mid X=k\sim\BetaD(k+1,n-k+1)\). Media este \(\E[P\mid X=k]=\frac{(n+1)!}{k!(n-k)!}\int_0^1p^{k+1}(1-p)^{n-k}\dd p=\frac{(n+1)!}{k!(n-k)!}\cdot\frac{(k+1)!(n-k)!}{(n+2)!}=\frac{k+1}{n+2}\).
Fie \(S\) evenimentul „succes la încercarea \(n+1\)”. Știind \(P=p\), \(\PP(S\mid P=p,X=k)=p\), deci, cu formula probabilității totale în raport cu repartiția a posteriori, \(\PP(S\mid X=k)=\int_0^1p\,f_{P\mid X}(p\mid k)\dd p=\E[P\mid X=k]=\frac{k+1}{n+2}\). De exemplu, după \(7\) succese în \(10\) încercări, \(\PP(S\mid X=7)=\frac8{12}=\frac23\) (și nu \(0.7\)). Această idee va fi dezvoltată în Cursul 11.
Exercițiul 10(Daunele unei companii de asigurări)
Numărul de daune raportate într-un an la o companie de asigurări este \(N\sim\Pois(20)\), iar valorile daunelor (în mii de lei) sunt \(X_1,X_2,\dots\sim\Unif(0,10)\), independente între ele și de \(N\). Fie \(T=\sum_{i=1}^NX_i\) valoarea totală a daunelor. Calculați \(\E[T]\), \(\Var(T)\) și \(\Cov(N,T)\).
Soluție
Avem \(\E[X_1]=5\), \(\Var(X_1)=\frac{100}{12}=\frac{25}3\) și \(\E[N]=\Var(N)=20\). Cu Propoziția 30, \[
\E[T]=20\cdot5=100,\qquad \Var(T)=20\cdot\frac{25}3+25\cdot20=\frac{500}{3}+500=\frac{2000}{3}\approx666.7,
\] deci abaterea standard a valorii totale este \(\sqrt{2000/3}\approx25.8\) mii lei. Pentru covarianță, \(\E[NT]=\E\big[N\,\E[T\mid N]\big]=\E[N\cdot5N]=5\E[N^2]=5(20+400)=2100\), deci \(\Cov(N,T)=2100-20\cdot100=100\). (În general, \(\Cov(N,T)=\E[X_1]\Var(N)\).)
Randamentele \(X\) și \(Y\) a două active financiare au \(\Var(X)=1\), \(\Var(Y)=4\) și \(\rho(X,Y)=-0.5\).
Calculați \(\Var(2X-Y+3)\).
Un investitor plasează fracțiunea \(a\in[0,1]\) din capital în primul activ și \(1-a\) în al doilea; randamentul portofoliului este \(R_a=aX+(1-a)Y\). Determinați \(a\) care minimizează \(\Var(R_a)\) și varianța minimă.
Constanta nu contează, iar din proprietățile covarianței, \(\Var(2X-Y+3)=4\Var(X)+\Var(Y)-2\cdot2\Cov(X,Y)=4+4+4=12\).
\(\Var(R_a)=a^2\Var(X)+(1-a)^2\Var(Y)+2a(1-a)\Cov(X,Y)=a^2+4(1-a)^2-2a(1-a)\). Derivând, \(2a-8(1-a)-2(1-2a)=14a-10=0\), deci \(a^*=\frac57\) (un punct de minim, coeficientul lui \(a^2\) fiind \(7>0\)). Varianța minimă este \[
\Var(R_{a^*})=\frac{25}{49}+4\cdot\frac{4}{49}-2\cdot\frac57\cdot\frac27=\frac{25+16-20}{49}=\frac37\approx0.43,
\] mai mică decât varianța oricăruia dintre cele două active: corelația negativă face ca fluctuațiile să se compenseze parțial.
Exercițiul 12(Distanța până la centrul discului)
Fie \((X,Y)\sim\Unif(D)\), unde \(D\) este discul de rază \(r\) centrat în origine, și \(R=\sqrt{X^2+Y^2}\).
Determinați funcția de repartiție și densitatea lui \(R\), apoi \(\E[R]\) și \(\Var(R)\).
Calculați \(\Var(X)\) și \(\Cov(X,Y)\). Sunt \(X\) și \(Y\) necorelate? Dar independente?
Soluție
Pentru \(0\le t\le r\), evenimentul \(\{R\le t\}\) înseamnă că punctul cade în discul de rază \(t\), deci \(F_R(t)=\frac{\pi t^2}{\pi r^2}=\frac{t^2}{r^2}\) și \(f_R(t)=\frac{2t}{r^2}\) pe \([0,r]\). Atunci \(\E[R]=\int_0^r\frac{2t^2}{r^2}\dd t=\frac{2r}{3}\), \(\E[R^2]=\int_0^r\frac{2t^3}{r^2}\dd t=\frac{r^2}{2}\), deci \(\Var(R)=\frac{r^2}2-\frac{4r^2}9=\frac{r^2}{18}\).
Prin simetrie, \(X\) și \(-X\) au aceeași repartiție, deci \(\E[X]=0\), și analog \(\E[Y]=0\); de asemenea \(X\) și \(Y\) au aceeași repartiție. Din \(\E[X^2]+\E[Y^2]=\E[R^2]=\frac{r^2}{2}\) rezultă \(\Var(X)=\E[X^2]=\frac{r^2}{4}\) (același rezultat ca prin legea lui Eve). Pentru covarianță, \((X,Y)\) și \((-X,Y)\) au aceeași repartiție (discul este simetric față de axa \(Oy\)), deci \(\E[XY]=\E[-XY]\), adică \(\E[XY]=0\) și \(\Cov(X,Y)=0\). Așadar \(X\) și \(Y\) sunt necorelate, dar, după cum am văzut în Exemplul 10, nu sunt independente (de exemplu \(\PP(X>0.8r,\ Y>0.8r)=0\), deși ambele probabilități marginale sunt pozitive).
9 Exerciții propuse
Se aruncă două zaruri echilibrate. Fie \(U\) cel mai mic și \(V\) cel mai mare dintre cele două rezultate. Determinați repartiția comună și repartițiile marginale ale lui \((U,V)\), repartiția condiționată \(U\mid V=4\) și \(\Cov(U,V)\). (Răspuns: \(\E[U]=\frac{91}{36}\), \(\E[V]=\frac{161}{36}\), \(\Cov(U,V)=\frac{1225}{1296}\approx0.945\), \(\rho(U,V)\approx0.479\).)
Vectorul \((X,Y)\) are densitatea \(f_{X,Y}(x,y)=c\,xy\) pentru \(0\le y\le x\le1\) și \(0\) în rest. Determinați \(c\), densitățile marginale, \(f_{Y\mid X}\) și \(\E[Y\mid X]\). Sunt \(X\) și \(Y\) independente? (Răspuns: \(c=8\), \(f_X(x)=4x^3\), \(f_Y(y)=4y(1-y^2)\), \(f_{Y\mid X}(y\mid x)=2y/x^2\) pe \([0,x]\), \(\E[Y\mid X]=2X/3\); nu.)
Fie \(X\sim\Unif(0,1)\) și, știind \(X=x\), \(Y\mid X=x\sim\Unif(0,x)\). Determinați densitatea lui \(Y\) și calculați \(\E[Y]\) și \(\Var(Y)\) atât direct, cât și cu legile lui Adam și Eve. (Răspuns: \(f_Y(y)=-\ln y\) pe \((0,1)\), \(\E[Y]=\frac14\), \(\Var(Y)=\frac{7}{144}\).)
Un zar echilibrat se aruncă de \(n\) ori; fie \(N_i\) numărul de apariții ale feței \(i\). Arătați că \(\Cov(N_1,N_2)=-\frac{n}{36}\) și calculați \(\rho(N_1,N_2)\). (Indicație: scrieți \(N_1\) și \(N_2\) ca sume de indicatori. Răspuns: \(\rho=-\frac15\).)
Numărul de clienți \(N\) dintr-o coadă este geometric, \(\PP(N=k)=(1-p)^{k-1}p\), \(k\ge1\), iar timpii de servire \(X_1,X_2,\dots\sim\Exp(\lambda)\) sunt independenți între ei și de \(N\). Calculați media și varianța timpului total de servire \(T=\sum_{i=1}^NX_i\). (Răspuns: \(\E[T]=\frac{1}{p\lambda}\), \(\Var(T)=\frac{1}{p^2\lambda^2}\); de fapt \(T\sim\Exp(p\lambda)\).)
O componentă provine de la mașina \(A\) cu probabilitatea \(0.6\) și de la mașina \(B\) cu probabilitatea \(0.4\). Durata de viață a componentelor produse de \(A\) este exponențială de medie 2 ani, iar a celor produse de \(B\) exponențială de medie 4 ani. O componentă s-a defectat după exact 3 ani. Care este probabilitatea să fi fost produsă de mașina \(B\)? (Răspuns: \(\approx0.414\).)
Fie \(X\sim\Exp(\lambda)\) și \(Y\sim\Exp(\mu)\) independente (duratele de viață a două componente). Arătați, calculând o integrală dublă, că \(\PP(X<Y)=\frac{\lambda}{\lambda+\mu}\) și că \(\min(X,Y)\sim\Exp(\lambda+\mu)\). (Pentru \(\lambda=2\), \(\mu=3\): \(\PP(X<Y)=0.4\).)
Fie \(X,Y\sim\Unif(0,1)\) independente. Arătați, cu formula de convoluție, că \(Z=X+Y\) are densitatea triunghiulară \(f_Z(z)=z\) pe \([0,1]\), \(f_Z(z)=2-z\) pe \((1,2]\), și calculați \(\PP(Z\le 1.5)\). (Răspuns: \(7/8\).)
Bibliografie
Bertsekas, Dimitri P., and John N. Tsitsiklis. 2008. Introduction to Probability. 2nd ed. Athena Scientific.
Blitzstein, Joseph K., and Jessica Hwang. 2019. Introduction to Probability. 2nd ed. CRC Press.
Chan, Stanley H. 2021. Introduction to Probability for Data Science. Michigan Publishing.