___                                          # P(V = 5): funcția d a lui V
MV <- function(t) ___                        # f.g.m. a lui V
h <- 1e-4                                    # pasul diferențelor finite
m1 <- ___                                    # aproximează M'(0) = E[V]
m2 <- ___                                    # aproximează M''(0) = E[V^2]
c(E_V = m1, Var_V = m2 - m1^2)
set.seed(1)                                  # V ca sumă de 3 geometrice
V <- colSums(matrix(___, nrow = 3))          # atenție: rgeom numără eșecuri
c(medie = mean(V), varianta = var(V), P_V_5 = mean(V == 5))
___ # P(W <= 5)Seminarul 2. F.g.m., vectori aleatori, transformări și teoreme limită
Fișă de lucru (fără rezolvări)
Aceasta este fișa de lucru: enunțurile, exemplele rezolvate, scheletele de cod R și răspunsurile finale pentru exercițiile marcate „Dacă timpul permite” și „Pentru acasă”. Rezolvările complete vor fi publicate ulterior.
Planul seminarului și laboratorului
Statisticile cu care vom lucra tot semestrul — suma și media unui eșantion, minimul și maximul, rapoarte de tip „semnal/zgomot” — sunt funcții ale unui vector aleator, iar comportarea lor pentru eșantioane mari este descrisă de legea numerelor mari (LNM) și de teorema limită centrală (TLC). Ședința exersează instrumentele din partea a doua a Cursul 1 cu care se obțin repartițiile acestor statistici: funcția generatoare de momente (f.g.m.), repartițiile comune și marginale, formulele de transformare a vectorilor aleatori și teoremele limită. Fiecare exercițiu are o rezolvare matematică (Seminar) și una în R (Laborator): calculul „pe hârtie” dă formula, iar R o verifică numeric sau prin simulare și arată cât de bune sunt aproximările.
Obiective. La sfârșitul ședinței studentul trebuie să poată:
- calcula f.g.m. a unei repartiții și a unei sume de variabile independente, deduce din ea momentele și recunoaște o repartiție după f.g.m.;
- determina repartițiile marginale ale unui vector aleator, decide dacă componentele sunt independente și calcula covarianțe și coeficienți de corelație;
- determina repartiția unei funcții a unui vector aleator — prin convoluție, cu metoda funcției de repartiție, cu formulele pentru maxim și minim sau cu formula schimbării de variabilă (cu o variabilă auxiliară) — și citi din densitatea comună dacă noile variabile sunt independente;
- aplica inegalitatea lui Cebîșev, LNM, TLC, teorema aplicațiilor continue și lema lui Slutsky, verificând ipotezele, și face calcule aproximative cu și fără corecție de continuitate;
- simula în R vectori aleatori și funcții ale lor, estima probabilități, covarianțe și corelații, verifica o densitate obținută printr-o transformare (
integrate,ecdf, histogramă) și ilustra prin simulare LNM și TLC.
Structura. Breviar; f.g.m.: calcul, momente, recunoașterea repartițiilor; vectori aleatori: marginale, independență, covarianță; transformări de vectori aleatori; LNM, TLC, aproximări și lema lui Slutsky; exerciții suplimentare; temă. Pentru aprofundare: (Casella and Berger 2002, cap. 4–5), (Hogg et al. 2019, cap. 2 și 5), (Knight 2000, cap. 2–3).
Planul ședinței
De rezolvat la seminar (în această ordine):
- Exercițiul 1 (b)–(d) — f.g.m.: momente și recunoașterea repartițiilor;
- Exercițiul 3 — un vector aleator: marginale, independență, covarianță, simulare;
- Exercițiul 6 (a), (b), (d) — schimbarea de variabilă cu o variabilă auxiliară;
- Exercițiul 9 — volumul unui sondaj: Cebîșev, TLC și lema lui Slutsky.
Dacă timpul permite:
- Exercițiul 2 — f.g.m. a unei sume și o convergență în repartiție;
- Exercițiul 5 — o convoluție și un raport;
- Exercițiul 8 — aproximarea normală și corecția de continuitate.
Pentru acasă:
- Exercițiile 4 (subțierea Poisson), 7 (distanța la un colț) și 10 (LNM și TLC prin simulare);
- exercițiile suplimentare 11, 12 și 13 (Secțiunea 6);
- enunțurile din Secțiunea 7.
Rezolvările complete vor fi publicate ulterior; scheletele de cod R se completează în locurile marcate cu ___. Exercițiile marcate „Dacă timpul permite” și „Pentru acasă” au, după enunț, răspunsurile finale, pentru verificare.
1 Breviar
Folosim rezultatele din partea a doua a Cursul 1 (f.g.m., vectori aleatori, convergențe, LNM și TLC), rezumate în caseta următoare; în soluții indicăm la fiecare pas rezultatul aplicat. Peste tot, \(X_1,X_2,\dots\) sunt variabile aleatoare (v.a.) definite pe același câmp de probabilitate, \(S_n=X_1+\dots+X_n\), \(\Xbar=S_n/n\), \(\Phi\) este funcția de repartiție a repartiției \(\Norm(0,1)\), iar \(z_p=\Phi^{-1}(p)\) este cuantila ei de ordin \(p\): \(z_{0.95}\approx1.645\), \(z_{0.975}\approx1.96\) (în R, qnorm(p)).
Rezultate din curs folosite azi
F.g.m. (Definiția 30 din Cursul 1): \(M_X(t)=\E[e^{tX}]\); \(X\) admite f.g.m. dacă \(M_X<\infty\) pe un interval \((-h,h)\), \(h>0\). Atunci \(\E[X^k]=M_X^{(k)}(0)\) și \(M_X(t)=\sum_{k\ge0}\E[X^k]\,t^k/k!\) pentru \(|t|<h\) (Teorema 32 din Cursul 1), iar f.g.m. determină repartiția (Teorema 33 din Cursul 1). \(M_{a+bX}(t)=e^{at}M_X(bt)\) (Lema 31 din Cursul 1); pentru \(X_1,\dots,X_n\) independente, \(M_{X_1+\dots+X_n}=\prod_iM_{X_i}\), iar pentru i.i.d., \(M_{S_n}=M^n\) (Propoziția 46 din Cursul 1). F.g.m. uzuale (Exemplele 21 din Cursul 1 și 22 din Cursul 1), cu \(q=1-p\):
\[ \begin{array}{lllll} \Geom(p): & \dfrac{pe^t}{1-qe^t},\ \ t<-\ln q; &\quad& \Pois(\lambda): & e^{\lambda(e^t-1)},\ \ t\in\R;\\[3mm] \GammaD(\alpha,\lambda): & \Big(\dfrac{\lambda}{\lambda-t}\Big)^{\alpha},\ \ t<\lambda; && \Norm(\mu,\sigma^2): & e^{\mu t+\sigma^2t^2/2},\ \ t\in\R, \end{array} \] iar \(\Exp(\lambda)=\GammaD(1,\lambda)\).
Vectori aleatori. Marginalele: \(f_X(x)=\int_{\R}f_{(X,Y)}(x,y)\dd y\), respectiv \(p_X(x)=\sum_yp_{(X,Y)}(x,y)\) (Propoziția 36 din Cursul 1). \(X\) și \(Y\) sunt independente dacă \(F_{(X,Y)}(x,y)=F_X(x)F_Y(y)\) pentru orice \((x,y)\) (Definiția 37 din Cursul 1); echivalent, dacă masa sau densitatea comună este produsul marginalelor; dacă densitatea comună este un produs \(a(u)\,b(v)\) pe tot spațiul, atunci \(U\) și \(V\) sunt independente, cu densitățile proporționale cu \(a\) și \(b\) (Propoziția 38 din Cursul 1). Funcții de blocuri disjuncte de v.a. independente sunt independente (Propoziția 39 din Cursul 1), iar pentru \(X\), \(Y\) independente, \(\E[g(X)h(Y)]=\E[g(X)]\,\E[h(Y)]\) (Propoziția 40 din Cursul 1).
Covarianța (Definiția 41 din Cursul 1, Propoziția 42 din Cursul 1): \(\Cov(X,Y)=\E[XY]-\E X\,\E Y\) este biliniară; \(\Var(\sum_iX_i)=\sum_i\Var X_i+2\sum_{i<j}\Cov(X_i,X_j)\); independența implică necorelarea (nu și invers); \(|\rho(X,Y)|\le1\). Pentru v.a. i.i.d. cu media \(\mu\) și varianța \(\sigma^2\): \(\E[\Xbar]=\mu\), \(\Var(\Xbar)=\sigma^2/n\) (Corolarul 43 din Cursul 1).
Transformări de vectori aleatori (Secțiunea 7.5 din Cursul 1). Metoda funcției de repartiție: \(F_{g(X,Y)}(z)=\iint_{\{g(x,y)\le z\}}f_{(X,Y)}(x,y)\dd x\dd y\); dacă \(F\) este continuă și de clasă \(C^1\) pe porțiuni, densitatea este \(F'\) (Lema 16 din Cursul 1). Pentru \(X\), \(Y\) independente, cu densități (Propozițiile 50 din Cursul 1 și 51 din Cursul 1): \[ \begin{aligned} f_{X+Y}(z)&=\int_{\R}f_X(x)\,f_Y(z-x)\dd x, &\qquad f_{X/Y}(z)&=\int_{\R}|y|\,f_X(zy)\,f_Y(y)\dd y,\\ F_{\max(X,Y)}&=F_XF_Y, & 1-F_{\min(X,Y)}&=(1-F_X)(1-F_Y). \end{aligned} \] Schimbarea de variabilă (Teorema 52 din Cursul 1): dacă \(\PP(X\in S)=1\) și \(h:S\to\R^d\) este injectivă, de clasă \(C^1\), cu \(J_h\ne0\) pe mulțimea deschisă \(S\), atunci \(Y=h(X)\) are densitatea \(f_Y(y)=f_X\big(h^{-1}(y)\big)\,|J_{h^{-1}}(y)|\,\Ind_{h(S)}(y)\). Pentru o singură funcție \(U=g_1(X,Y)\) adăugăm o variabilă auxiliară \(V=g_2(X,Y)\), calculăm \(f_{(U,V)}\) și integrăm în \(v\).
Convergențe (Definiția 55 din Cursul 1, Teorema 56 din Cursul 1): \(\asto\ \Rightarrow\ \pto\ \Rightarrow\ \dto\), iar \(X_n\dto c\) (constantă) \(\Rightarrow X_n\pto c\). Aplicații continue (Teorema 57 din Cursul 1): dacă \(g\) este continuă în afara unei mulțimi \(D_g\) cu \(\PP(X\in D_g)=0\), atunci \(g(X_n)\to g(X)\) în același sens în care \(X_n\to X\). Slutsky (Teorema 58 din Cursul 1): dacă \(X_n\dto X\) și \(Y_n\pto c\) (constantă), atunci \(X_n+Y_n\dto X+c\) și \(Y_nX_n\dto cX\).
Cebîșev, LNM, TLC. \(\PP(|X-\E X|\ge\varepsilon)\le\Var(X)/\varepsilon^2\) (Propoziția 26(b) din Cursul 1). Pentru \(X_i\) i.i.d. cu media \(\mu\) și varianța \(\sigma^2\): \(\PP(|\Xbar-\mu|\ge\varepsilon)\le\sigma^2/(n\varepsilon^2)\), deci \(\Xbar\pto\mu\) (Teorema 60 din Cursul 1); dacă doar \(\E|X_1|<\infty\), \(\Xbar\asto\mu\) (Teorema 61 din Cursul 1). Dacă \(\sigma^2\in(0,\infty)\), \(\sqrt n(\Xbar-\mu)/\sigma\dto\Norm(0,1)\) (Teorema 64 din Cursul 1), deci \(S_n\approx\Norm(n\mu,n\sigma^2)\) și \(\Xbar\approx\Norm(\mu,\sigma^2/n)\). Pentru \(S_n\sim\Bin(n,p)\) (Corolarul 65 din Cursul 1) și \(k\) întreg, corecția de continuitate: \(\PP(S_n\le k)\approx\Phi\big((k+0.5-np)/\sqrt{np(1-p)}\big)\).
Curtiss (Teorema 63 din Cursul 1): dacă \(M_{X_n}(t)\to M_X(t)<\infty\) pentru orice \(t\in(-h,h)\), atunci \(X_n\dto X\); limita se obține de obicei din \((1+a_n/n)^n\to e^a\) pentru \(a_n\to a\) (Lema 62 din Cursul 1).
În R folosim instrumentele din Seminarul 1 (vectori, funcții proprii, mean(conditie), funcțiile d/p/q/r ale repartițiilor). Caseta următoare le reamintește pe cele de care avem nevoie azi și le adaugă pe cele noi: matricele de realizări ale unui vector aleator, cu colMeans, cov și cor, și mediile cumulate.
Instrumente R folosite azi
- Parametrizări-capcană.
geomșinbinomnumără eșecurile: pentru \(X\sim\Geom(p)\), \(\PP(X=k)\) estedgeom(k - 1, p), iarrgeom(n, p) + 1generează valori ale lui \(X\); pentru \(\NBin(r,p)\),dnbinom(k - r, r, p).expșigammafolosesc rata:rexp(n, rate),pgamma(x, shape, rate);normfolosește abaterea standard:pnorm(x, mean, sd). replicate(B, expr)— repetă deBori o simulare;matrix(v, nrow = B)împreună curowMeans,colSums—Beșantioane așezate pe linii (sau pe coloane) și mediile (sumele) lor, fără bucle.cbind(X = x, Y = y)— realizările unui vector aleator, câte una pe linie;colMeans,cov,cor— mediile, matricea de covarianță și matricea de corelație empirice.integrate(f, a, b)$value— integrala numerică a funcției (vectorizate)f; limitele pot fi-Inf,Inf. O densitate corectă are integrala \(1\).uniroot(h, c(a, b))$root— o soluție a ecuației \(h(x)=0\) în \([a,b]\) (\(h(a)\) și \(h(b)\) de semne contrare); o folosim pentru mediane și cuantile.ecdf(x)— funcția de repartiție empirică a valorilorx:ecdf(x)(q)este proporția valorilor mai mici sau egale cuq.pmin(x, y),pmax(x, y)— minimul și maximul pe componente (minșimaxîntorc un singur număr);ifelse(cond, a, b)— funcții definite pe ramuri;cumsum(x) / (1:n)— mediile cumulate \(\bar x_1,\dots,\bar x_n\) ale unui șir.hist(x, freq = FALSE), apoicurve(f(x), add = TRUE)— histograma normalizată (de arie \(1\)) și densitatea teoretică, pe același grafic.
Toate verificările prin simulare se sprijină pe LNM: frecvența relativă a unui eveniment în \(B\) repetări independente aproximează probabilitatea lui, \(p\), cu o eroare de ordinul \(\sqrt{p(1-p)/B}\le\frac{1}{2\sqrt B}\) (din TLC), adică cel mult \(0.0016\) pentru \(B=10^5\). Două valori care diferă cu mai puțin de două–trei astfel de erori „concordă”.
2 F.g.m.: calcul, momente, recunoașterea repartițiilor
F.g.m. este instrumentul cu care, în cursurile următoare, vom obține repartițiile exacte ale statisticilor (suma unui eșantion Bernoulli, Poisson, exponențial, normal). Primul exercițiu exersează cele trei utilizări ale ei: calculul efectiv (o serie sau o integrală), obținerea momentelor și recunoașterea unei repartiții. Al doilea arată cum se demonstrează o convergență în repartiție calculând exact f.g.m. a unei sume și trecând la limită — schema demonstrației TLC din Cursul 1.
Începem cu un exemplu rezolvat, mai simplu decât exercițiile, care arată gesturile de bază: scrierea f.g.m. ca sumă sau ca integrală, stabilirea mulțimii pe care ea este finită, obținerea momentelor prin derivare în \(t=0\) și recunoașterea unei repartiții după f.g.m.
Exemplul 1 (F.g.m. a unei variabile cu trei valori și a unei exponențiale translatate)
(a) O variabilă discretă. Fie \(X\) cu \(\PP(X=-1)=0.3\), \(\PP(X=0)=0.5\) și \(\PP(X=2)=0.2\). Din formula de transport (Teorema 22 din Cursul 1), în cazul discret \(M_X(t)=\E[e^{tX}]=\sum_ie^{tx_i}\,\PP(X=x_i)\). Suma are trei termeni, deci este finită pentru orice \(t\): \[ M_X(t)=0.3\,e^{-t}+0.5\,e^{0\cdot t}+0.2\,e^{2t}=0.5+0.3\,e^{-t}+0.2\,e^{2t},\qquad t\in\R . \] Momentele se obțin derivând în \(t=0\) (Teorema 32 din Cursul 1); fiecare derivare „coboară” din exponent valoarea \(x_i\): \[ M_X'(t)=-0.3\,e^{-t}+0.4\,e^{2t},\qquad M_X''(t)=0.3\,e^{-t}+0.8\,e^{2t}, \] deci \(\E[X]=M_X'(0)=-0.3+0.4=0.1\), \(\E[X^2]=M_X''(0)=0.3+0.8=1.1\) și \(\Var(X)=1.1-0.1^2=1.09\). Verificare directă: \(\E[X]=(-1)\cdot0.3+0\cdot0.5+2\cdot0.2=0.1\) și \(\E[X^2]=1\cdot0.3+0+4\cdot0.2=1.1\). Citirea inversă: dacă ni se dă f.g.m. \(0.5+0.3\,e^{-t}+0.2\,e^{2t}\), recunoaștem repartiția: numerele \(-1,0,2\) care înmulțesc pe \(t\) în exponenți sunt valorile, iar coeficienții \(0.3,0.5,0.2\) sunt probabilitățile lor; din Teorema 33 din Cursul 1, nicio altă repartiție nu are această f.g.m.
(b) O variabilă continuă. Un timp de așteptare \(T\) nu poate fi mai mic decât \(1\) și are densitatea \(f(x)=e^{-(x-1)}\) pentru \(x>1\) (și \(f(x)=0\) în rest). În cazul continuu, \(M_T(t)=\int_{\R}e^{tx}f(x)\dd x\); integrala este improprie, deci trebuie stabilit pentru ce valori ale lui \(t\) este finită. Grupăm exponențialele, \(e^{tx}e^{-(x-1)}=e\cdot e^{-(1-t)x}\), și integrăm: \[ M_T(t)=e\int_1^\infty e^{-(1-t)x}\dd x=e\,\Big[-\frac{e^{-(1-t)x}}{1-t}\Big]_{x=1}^{x\to\infty}=e\cdot\frac{e^{-(1-t)}}{1-t}=\frac{e^{t}}{1-t},\qquad t<1 . \] Pentru \(t<1\) exponentul \(-(1-t)x\) tinde la \(-\infty\) când \(x\to\infty\), deci termenul de la \(\infty\) este nul; pentru \(t\ge1\) integrandul \(e\cdot e^{(t-1)x}\) este cel puțin \(e\) pe tot intervalul \((1,\infty)\) și \(M_T(t)=\infty\). Mulțimea pe care f.g.m. este finită, \((-\infty,1)\), conține intervalul \((-1,1)\): \(T\) admite f.g.m. Derivăm produsul \(e^t\cdot(1-t)^{-1}\): \[ M_T'(t)=\frac{e^t}{1-t}+\frac{e^t}{(1-t)^2},\qquad M_T''(t)=\frac{e^t}{1-t}+\frac{2e^t}{(1-t)^2}+\frac{2e^t}{(1-t)^3}, \] deci \(\E[T]=M_T'(0)=1+1=2\), \(\E[T^2]=M_T''(0)=1+2+2=5\) și \(\Var(T)=5-2^2=1\).
Recunoașterea. Factorul \(\frac1{1-t}\), \(t<1\), este f.g.m. a repartiției \(\Exp(1)\), iar înmulțirea cu \(e^{t}\) corespunde, în Lema 31 din Cursul 1, adunării constantei \(1\): dacă \(E\sim\Exp(1)\), atunci \(M_{1+E}(t)=e^{t}M_E(t)=M_T(t)\) pentru \(t<1\), deci \(T\eqd1+E\), cu \(E\sim\Exp(1)\) (Teorema 33 din Cursul 1). Regăsim \(\E[T]=1+\E[E]=2\) și \(\Var(T)=\Var(E)=1\): translația schimbă media, nu și varianța. Un factor \(e^{at}\) într-o f.g.m. semnalează întotdeauna o translație cu \(a\).
Exercițiul 1 (F.g.m. a repartițiilor uniformă și binomială negativă)
La seminar (a) Fie \(X\sim\Unif(a,b)\), \(a<b\). Pornind de la f.g.m. a lui \(X\), deduceți toate momentele \(\E[X^k]\), apoi \(\E[X]\) și \(\Var(X)\).
Repartiția binomială negativă \(\NBin(r,p)\), \(r\in\N^*\), \(p\in(0,1)\), este repartiția numărului \(X\) de încercări independente necesare pentru a obține \(r\) succese, fiecare încercare fiind un succes cu probabilitatea \(p\): \(\PP(X=k)=\binom{k-1}{r-1}p^r(1-p)^{k-r}\), \(k\ge r\). Calculați \(M_X\), arătați că \(X\) are aceeași repartiție ca suma a \(r\) variabile independente \(\Geom(p)\) și deduceți \(\E[X]\) și \(\Var(X)\).
Recunoașteți repartițiile variabilelor \(V\) și \(W\) cu f.g.m. \[ M_V(t)=\Big(\frac{0.2\,e^{t}}{1-0.8\,e^{t}}\Big)^3\ \ (t<-\ln0.8),\qquad M_W(t)=\frac{e^{t}}{(1-2t)^3}\ \ (t<1/2), \] și calculați \(\E[V]\), \(\Var(V)\), \(\PP(V=5)\), \(\E[W]\), \(\Var(W)\) și \(\PP(W\le5)\).
În R: verificați valorile de la (c), calculând momentele lui \(V\) prin derivarea numerică a lui \(M_V\) și simulând \(V\) ca sumă de variabile geometrice.
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
Exercițiul următor combină cele trei proprietăți ale f.g.m. (momente, unicitate, sume) și le folosește pentru a obține direct o convergență în repartiție.
Exercițiul 2 (F.g.m. a unei sume. Repartiția Laplace)
Dacă timpul permite Fie \(X_1,X_2,\dots\) i.i.d. cu densitatea \(f(x)=\frac12e^{-|x-\theta|}\), \(x\in\R\) (repartiția Laplace sau dublu exponențială), unde \(\theta\in\R\).
Arătați că \(M_{X_1}(t)=\dfrac{e^{\theta t}}{1-t^2}\) pentru \(|t|<1\) și deduceți \(\E[X_1]\) și \(\Var(X_1)\).
Fie \(E_1,E_2\) i.i.d. \(\Exp(1)\). Arătați că \(\theta+E_1-E_2\) are aceeași repartiție ca \(X_1\).
Fie \(U_n=(S_n-n\theta)/\sqrt{2n}\). Calculați \(M_{U_n}\) și arătați direct, fără a folosi TLC, că \(U_n\dto\Norm(0,1)\).
Pentru \(\theta=0\) și \(n=50\), aproximați \(\PP(|\Xbar|\le0.3)\) și verificați prin simulare, generând observațiile cu reprezentarea de la (b).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
set.seed(1)
xb <- replicate(20000, ___)        # 20000 de medii, n = 50, reprezentarea (b)
c(simulare = mean(abs(xb) <= 0.3), TLC = ___,      # aproximarea dată de TLC
  var_sim = var(xb), var_teoretic = ___)           # Var(X barat) = ?
Răspunsuri
\(M_{X_1}(t)=\frac{e^{\theta t}}{1-t^2}\) pentru \(|t|<1\), \(\E[X_1]=\theta\) și \(\Var(X_1)=2\).
\(\theta+E_1-E_2\eqd\theta+Y=X_1\).
\(M_{U_n}(t)=\big(1-\frac{t^2}{2n}\big)^{-n}\to e^{t^2/2}\) și \(U_n\dto\Norm(0,1)\).
frecvența simulată \(0.8657\) față de aproximarea \(\PP(|\Xbar|\le0.3)\approx0.8664\) dată de TLC.
3 Vectori aleatori: marginale, independență, covarianță
Un eșantion este un vector aleator, iar proprietățile statisticilor depind de repartiția comună a observațiilor. Cele două exerciții parcurg, pe un vector continuu și pe unul discret, pașii standard: constanta de normare, repartițiile marginale, verificarea independenței (prin factorizare sau prin funcția de repartiție comună) și calculul covarianței. În laborator simulăm vectorul printr-o reprezentare — îl scriem ca funcție de variabile independente pe care știm să le generăm — și estimăm mediile, covarianțele și corelațiile.
Exemplul rezolvat parcurge acești pași pe un vector al cărui suport este un triunghi. Partea care cere atenție este de fiecare dată aceeași: limitele de integrare se citesc de pe suport.
Exemplul 2 (O densitate pe un triunghi: marginale, independență, covarianță)
Vectorul \((X,Y)\) are densitatea \(f(x,y)=c\,y\) pe triunghiul \(T\) cu vârfurile \((0,0)\), \((1,0)\) și \((0,1)\) și \(f(x,y)=0\) în rest. Ipotenuza se află pe dreapta \(x+y=1\), deci \(T=\{(x,y):\ x>0,\ y>0,\ x+y<1\}\).
Pasul 1 (constanta). Orizontala de ordonată \(y\in(0,1)\) taie triunghiul după segmentul \(0<x<1-y\), pe care \(f=c\,y\) nu depinde de \(x\). Integrând întâi în \(x\), integrala densității este \(\int_0^1c\,y\,(1-y)\dd y=c\big(\frac12-\frac13\big)=\frac c6\); ea trebuie să fie \(1\), deci \(c=6\).
Pasul 2 (marginalele). Din Propoziția 36 din Cursul 1, \(f_Y(y)=\int_{\R}f(x,y)\dd x\) se calculează pe aceeași secțiune orizontală, iar \(f_X(x)=\int_{\R}f(x,y)\dd y\) pe secțiunea verticală: verticala de abscisă \(x\in(0,1)\) taie triunghiul după segmentul \(0<y<1-x\). Deci \[ f_X(x)=\int_0^{1-x}6y\dd y=3(1-x)^2,\ \ 0<x<1;\qquad f_Y(y)=\int_0^{1-y}6y\dd x=6y(1-y),\ \ 0<y<1 . \] Limitele de integrare sunt capetele secțiunilor, deci depind de variabila rămasă. Verificare: \(\int_0^13(1-x)^2\dd x=\big[-(1-x)^3\big]_0^1=1\) și \(\int_0^16y(1-y)\dd y=6\big(\frac12-\frac13\big)=1\). Observăm că \(f_Y\) este simetrică față de \(\frac12\).
Pasul 3 (independența). \(X\) și \(Y\) nu sunt independente, pentru că suportul nu este un dreptunghi: dacă \(x>\frac12\) și \(y>\frac12\), atunci \(x+y>1\), deci \(\PP\big(X>\frac12,\ Y>\frac12\big)=0\), pe când \(\PP\big(X>\frac12\big)=\int_{1/2}^13(1-x)^2\dd x=\frac18\) și \(\PP\big(Y>\frac12\big)=\frac12\) (din simetria lui \(f_Y\)), cu produsul \(\frac1{16}\ne0\): relația de produs din Definiția 37 din Cursul 1 (în forma cu evenimente) nu are loc.
Pasul 4 (covarianța). Mediile: \(\E[X]=\int_0^13x(1-x)^2\dd x=3\big(\frac12-\frac23+\frac14\big)=\frac14\) și \(\E[Y]=\frac12\) (din simetrie). Pentru \(\E[XY]\) integrăm \(xy\,f(x,y)=6xy^2\) pe \(T\), întâi în \(x\), apoi în \(y\): \[ \begin{aligned} \E[XY]&=\int_0^16y^2\Big(\int_0^{1-y}x\dd x\Big)\dd y=\int_0^16y^2\cdot\frac{(1-y)^2}{2}\dd y\\ &=3\int_0^1\big(y^2-2y^3+y^4\big)\dd y=3\Big(\frac13-\frac12+\frac15\Big)=\frac1{10} . \end{aligned} \] Din Propoziția 42(a) din Cursul 1, \(\Cov(X,Y)=\E[XY]-\E[X]\,\E[Y]=\frac1{10}-\frac18=-\frac1{40}\). La fel, \(\E[X^2]=\int_0^13x^2(1-x)^2\dd x=\frac1{10}\) (integrala de mai sus) și \(\E[Y^2]=\int_0^16y^3(1-y)\dd y=6\big(\frac14-\frac15\big)=\frac3{10}\), deci \(\Var(X)=\frac1{10}-\frac1{16}=\frac3{80}\), \(\Var(Y)=\frac3{10}-\frac14=\frac1{20}\) și \[ \rho(X,Y)=\frac{\Cov(X,Y)}{\sqrt{\Var(X)\Var(Y)}}=\frac{-1/40}{\sqrt{\frac3{80}\cdot\frac1{20}}}=\frac{-1/40}{\sqrt3/40}=-\frac1{\sqrt3}\approx-0.577 . \] Corelația este negativă, \(\rho(X,Y)=-\frac1{\sqrt3}\): un punct cu abscisa mare se află lângă vârful \((1,0)\), unde ordonatele sunt mici.
Exercițiul 3 (Un vector cu densitatea exponențială pe un sector)
La seminar Vectorul aleator \((X,Y)\) are densitatea \(f(x,y)=c\,e^{-y}\) pentru \(0<x<y\) și \(f(x,y)=0\) în rest.
Determinați constanta \(c\) și densitățile marginale; recunoașteți repartițiile lui \(X\) și \(Y\). Sunt \(X\) și \(Y\) independente?
Calculați \(\Cov(X,Y)\), \(\rho(X,Y)\) și \(\PP(Y>2X)\).
Fie \(D=Y-X\). Arătați că \(X\) și \(D\) sunt independente, cu repartiția \(\Exp(1)\), și regăsiți rezultatele de la (a) și (b).
În R: simulați \(10^5\) realizări ale vectorului \((X,Y)\) cu reprezentarea dată de (c), estimați mediile, matricea de covarianță și corelațiile și reprezentați un nor de puncte. Ce observați despre raportul \(U=X/Y\)?
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
set.seed(21); B <- 1e5
E1 <- rexp(B); E2 <- rexp(B)
V <- cbind(X = ___, Y = ___, U = ___)   # reprezentarea (c); U = X / Y
colMeans(V)
round(cov(V), 3)
rho <- cor(V)                   # matricea corelațiilor
round(c(rho_XY = rho["X", "Y"], rho_UY = rho["U", "Y"],
        P_Y_2X = mean(___),             # frecvența evenimentului {Y > 2X}
        P_U_0.3 = mean(V[, "U"] <= 0.3)), 3)
plot(V[1:3000, c("X", "Y")], pch = 16, cex = 0.3, xlim = c(0, 5),
     ylim = c(0, 8)); abline(0, 1)      # norul de puncte și dreapta y = x
Exercițiul următor arată un fenomen surprinzător, specific repartiției Poisson, și exersează criteriul de factorizare în cazul discret.
Exercițiul 4 (Subțierea unei variabile Poisson)
Pentru acasă O găină depune un număr aleator \(N\sim\Pois(\lambda)\) de ouă (\(\lambda>0\)); fiecare ou eclozează cu probabilitatea \(p\in(0,1)\), independent de celelalte ouă și de \(N\). Fie \(X\) numărul de ouă din care ies pui și \(Y=N-X\) numărul celorlalte ouă; notăm \(q=1-p\).
Arătați că \(\PP(X=k,Y=m)=\PP(N=k+m)\binom{k+m}{k}p^kq^m\) pentru \(k,m\ge0\) și deduceți că \(X\sim\Pois(\lambda p)\), \(Y\sim\Pois(\lambda q)\) și că \(X\) și \(Y\) sunt independente.
Calculați \(\Cov(N,X)\) și \(\rho(N,X)\).
Ce se schimbă dacă numărul de ouă este fix, \(N=n\)?
În R: simulați modelul pentru \(\lambda=4\) și \(p=0.3\) și verificați (a) și (b).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
set.seed(12)
lambda <- 4; p <- 0.3; B <- 1e5
N <- rpois(B, lambda)                # numărul de ouă
X <- ___                             # câte eclozează din cele N
Y <- N - X
round(c(E_X = mean(X), Var_X = var(X), E_Y = mean(Y), Var_Y = var(Y),
        cov_N_X = cov(N, X), rho_N_X = cor(N, X), sqrt_p = sqrt(p),
        cov_X_Y = cov(X, Y)), 4)
c(comun = mean(___),                 # frecvența evenimentului {X = 1, Y = 2}
  produs = ___)                      # P(X = 1) P(Y = 2), cu dpois
Răspunsuri
\(X\sim\Pois(\lambda p)\) și \(Y\sim\Pois(\lambda q)\); \(X\) și \(Y\) sunt independente.
\(\Cov(N,X)=\lambda p\) și \(\rho(N,X)=\sqrt p\).
\(\Cov(X,Y)=\Cov(X,n-X)=-\Var(X)=-npq<0\); \(\rho(X,Y)=-1\).
media și varianța lui \(X\) sunt \(1.199\) și \(1.196\), iar ale lui \(Y\) sunt \(2.806\) și \(2.803\) — apropiate de \(\lambda p=1.2\) și \(\lambda q=2.8\); frecvența evenimentului \(\{X=1,Y=2\}\) coincide, la trei zecimale, cu produsul \(\PP(X=1)\,\PP(Y=2)\approx0.0862\).
4 Transformări de vectori aleatori
Suma și media eșantionului, minimul și maximul, rapoartele sunt funcții ale unui vector aleator, iar repartițiile lor se obțin cu metodele din Secțiunea 7.5 din Cursul 1. Cele trei exerciții folosesc, pe rând, formula de convoluție și metoda funcției de repartiție pentru un cât, formula schimbării de variabilă cu o variabilă auxiliară și metoda funcției de repartiție pentru o distanță. În fiecare, partea delicată nu este formula, ci domeniul: mulțimea pe care integrandul este nenul, imaginea transformării, forma mulțimii \(\{g\le z\}\). Verificarea în R are aceleași trepte de fiecare dată: (1) densitatea găsită trebuie să aibă integrala \(1\) (integrate); (2) frecvențele \(\PP(Z\le q)\) calculate din valori simulate trebuie să fie apropiate de funcția de repartiție obținută, iar histograma de densitate; (3) pentru o pereche, norul de puncte arată suportul, iar independența se verifică prin corelație și prin frecvențele evenimentelor.
Exemplul rezolvat aplică formula schimbării de variabilă celei mai simple perechi pentru care imaginea transformării nu este un dreptunghi — situația în care se greșește cel mai des.
Exemplul 3 (Suma a două uniforme prin metoda variabilei auxiliare)
Fie \(X\) și \(Y\) independente, \(\Unif(0,1)\), și \(U=X+Y\). Căutăm densitatea lui \(U\) cu Teorema 52 din Cursul 1. Teorema cere o transformare a planului în plan, deci completăm \(U\) cu variabila auxiliară \(V=X\).
Pasul 1 (transformarea și inversa). Vectorul \((X,Y)\) are densitatea \(f=\Ind_S\), cu \(S=(0,1)^2\) (Propoziția 38(b) din Cursul 1), o mulțime deschisă. Funcția \(h(x,y)=(x+y,\ x)\) este liniară, deci de clasă \(C^1\), cu iacobianul \(J_h=1\cdot0-1\cdot1=-1\ne0\); sistemul \(u=x+y\), \(v=x\) are soluția unică \(x=v\), \(y=u-v\), deci \(h\) este injectivă, cu inversa \(h^{-1}(u,v)=(v,\ u-v)\).
Pasul 2 (iacobianul inversei). Derivăm componentele inversei, \(x=v\) și \(y=u-v\), în raport cu \(u\) și \(v\): \[ J_{h^{-1}}(u,v)=\det\begin{pmatrix}\partial x/\partial u&\partial x/\partial v\\[2pt]\partial y/\partial u&\partial y/\partial v\end{pmatrix}=\det\begin{pmatrix}0&1\\1&-1\end{pmatrix}=-1,\qquad \big|J_{h^{-1}}(u,v)\big|=1 . \]
Pasul 3 (imaginea suportului). Punctul \((u,v)\) aparține lui \(T=h(S)\) dacă și numai dacă \(h^{-1}(u,v)=(v,\ u-v)\in S\), adică \(0<v<1\) și \(0<u-v<1\): \[ T=\{(u,v):\ 0<v<1,\ \ v<u<v+1\} . \] Este paralelogramul cu vârfurile \((0,0)\), \((1,0)\), \((2,1)\) și \((1,1)\) — imaginile vârfurilor \((0,0)\), \((0,1)\), \((1,1)\) și \((1,0)\) ale pătratului —, desenat mai jos; nu este un dreptunghi.
Pasul 4 (densitatea comună). Din Teorema 52 din Cursul 1, \(f_{(U,V)}(u,v)=f(v,\ u-v)\cdot\big|J_{h^{-1}}(u,v)\big|\cdot\Ind_T(u,v)=\Ind_T(u,v)\): vectorul \((U,V)\) este uniform pe paralelogramul \(T\) (de arie \(1\)).
Pasul 5 (integrarea variabilei auxiliare). Din Propoziția 36 din Cursul 1, \(f_U(u)=\int_{\R}\Ind_T(u,v)\dd v\) este lungimea secțiunii lui \(T\) prin verticala de abscisă \(u\). Condițiile \(0<v<1\) și \(u-1<v<u\) înseamnă \(\max(0,u-1)<v<\min(1,u)\):
- pentru \(0<u\le1\): \(0<v<u\), deci \(f_U(u)=u\);
- pentru \(1<u<2\): \(u-1<v<1\), deci \(f_U(u)=1-(u-1)=2-u\);
- pentru \(u\le0\) sau \(u\ge2\) secțiunea este vidă și \(f_U(u)=0\).
Am obținut densitatea „triunghiulară” \(f_U(u)=1-|u-1|\) pe \((0,2)\), cu integrala \(\frac12+\frac12=1\). Verificare: \(\PP\big(U\le\frac12\big)=\int_0^{1/2}u\dd u=\frac18\), aria triunghiului \(\{x+y\le\frac12\}\) din pătrat. Greșeala tipică este integrarea în \(v\) pe tot intervalul \((0,1)\), pentru orice \(u\): ea ar da \(f_U=1\) pe \((0,2)\), o funcție cu integrala \(2\).
par(mfrow = c(1, 2), mar = c(4, 4, 1.5, 1))
plot(NULL, xlim = c(0, 2), ylim = c(0, 1), xlab = "x", ylab = "y",
     main = "S")
polygon(c(0, 1, 1, 0), c(0, 0, 1, 1), col = "grey85")   # pătratul S
plot(NULL, xlim = c(0, 2), ylim = c(0, 1), xlab = "u", ylab = "v",
     main = "T = h(S)")
polygon(c(0, 1, 2, 1), c(0, 0, 1, 1), col = "grey85")   # paralelogramul T
segments(c(0.6, 1.4), c(0, 0.4), c(0.6, 1.4), c(0.6, 1), lwd = 2,
         col = culori[["rosu"]])       # secțiunile u = 0.6 și u = 1.4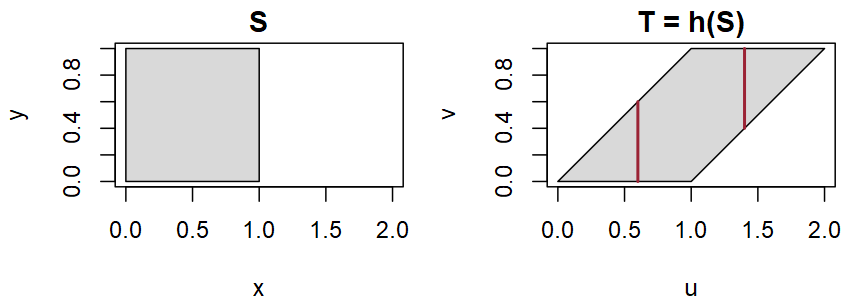
Segmentele roșii sunt secțiunile lui \(T\) pentru \(u=0.6\) (de lungime \(0.6\)) și \(u=1.4\) (de lungime \(2-1.4=0.6\)). Paralelogramul arată și că \(U\) și \(V\) nu sunt independente: valorile posibile ale lui \(U\) depind de \(V\) (de exemplu, \(\PP(U>1.5,\ V<0.5)=0\), deși ambele evenimente au probabilitate pozitivă).
Exercițiul 5 (Semnal plus zgomot: o convoluție și un raport)
Dacă timpul permite Un semnal de amplitudine \(X\sim\Unif(0,a)\), \(a>0\), este transmis printr-un canal care îi adaugă un zgomot pozitiv \(Y\sim\Exp(\lambda)\), independent de semnal. Receptorul înregistrează \(Z=X+Y\), iar calitatea transmisiei este măsurată de raportul semnal/zgomot \(Q=X/Y\).
Determinați densitatea lui \(Z\) cu formula de convoluție și verificați că integrala ei este \(1\).
Determinați funcția de repartiție și densitatea lui \(Q\). Are \(Q\) medie?
Pentru \(a=2\) și \(\lambda=1\), calculați \(\PP(Z>3)\) și \(\PP(Q>1)\). Ce ecuație verifică mediana lui \(Q\)?
În R: verificați numeric că densitatea de la (a) are integrala \(1\), comparați rezultatele de la (a)–(c) cu valori simulate și calculați mediana lui \(Q\).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (funcția compara pune alături frecvențele simulate și valorile unei funcții de repartiție și va fi folosită și în Exercițiul 7):
a <- 2; lam <- 1; th <- lam * a
fZ <- function(z) ifelse(z <= 0, 0, ___)     # densitatea de la (a); pmin
integrate(fZ, 0, Inf)$value                  # trebuie să fie 1
compara <- function(val, F, q)       # frecvențele P(val <= q) față de F(q)
  round(rbind(simulare = ___, exact = F(q)), 4)
set.seed(32); B <- 1e5
sx <- runif(B, 0, a); sy <- rexp(B, lam)     # semnalul și zgomotul
FZ <- function(q) sapply(q, function(t) integrate(fZ, 0, t)$value)
compara(sx + sy, FZ, c(1, 2, 3))
FQ <- function(z) ___                        # f. de repartiție a lui Q, (b)
compara(sx / sy, FQ, c(0.5, 1, 4))
c(P_Z_3 = mean(___), med_Q = uniroot(___, c(0.1, 10))$root)
Răspunsuri
Densitatea corectă are integrala \(1\).
\(F_Q(z)=\frac z\theta\big(1-e^{-\theta/z}\big)\) și \(f_Q(z)=\frac1\theta\big[1-\big(1+\frac\theta z\big)e^{-\theta/z}\big]\) pentru \(z>0\), cu \(\theta=\lambda a\); \(\E[Q]=\infty\): raportul nu are medie finită.
\(\PP(Q>1)=1-F_Q(1)=1-\frac{1-e^{-2}}{2}\approx1-0.4323=0.5677\), pe lângă \(\PP(Z>3)\approx0.1590\). Mediana lui \(Q\) este soluția ecuației \(F_Q(z)=\frac12\), adică \(\frac z2\big(1-e^{-2/z}\big)=\frac12\).
frecvența evenimentului \(\{Z>3\}\) este \(0.1597\), față de probabilitatea \(\PP(Z>3)\approx0.159\), iar mediana empirică a raportului coincide cu soluția \(\approx1.255\) a ecuației.
Următorul exercițiu folosește formula schimbării de variabilă, care dă repartiția comună a noilor variabile și permite să decidem dacă ele sunt independente. Când ne interesează o singură funcție a vectorului, o completăm cu o variabilă auxiliară; exercițiul arată și cât de mult depinde răspunsul de repartiția vectorului inițial.
Exercițiul 6 (Fracțiunea din timpul total: metoda variabilei auxiliare)
La seminar Un echipament pornește cu o componentă principală, înlocuită, la defectare, de o componentă de rezervă. Timpii lor de funcționare, \(X\) și \(Y\), sunt strict pozitivi, iar vectorul \((X,Y)\) are densitatea \(f\). Ne interesează fracțiunea \(Z=\dfrac{X}{X+Y}\) din timpul total de funcționare \(V=X+Y\) asigurată de componenta principală.
Folosind variabila auxiliară \(V\), arătați că vectorul \((Z,V)\) are densitatea \(f_{(Z,V)}(z,v)=v\,f\big(zv,(1-z)v\big)\) pentru \(0<z<1\), \(v>0\) (și \(0\) în rest) și scrieți densitatea lui \(Z\).
Fie \(X\sim\Exp(\lambda)\) și \(Y\sim\Exp(\mu)\) independente. Determinați densitatea și funcția de repartiție ale lui \(Z\). Pentru ce valori ale parametrilor sunt \(Z\) și \(V\) independente? Ce rezultă pentru raportul \(U\) din Exercițiul 3?
Fie \(X\) și \(Y\) independente, \(\Unif(0,1)\). Determinați densitatea lui \(Z\). Sunt \(Z\) și \(V\) independente? Dar necorelate?
În R: verificați prin simulare rezultatele de la (b), pentru \((\lambda,\mu)=(1,3)\) și \((\lambda,\mu)=(2,2)\), și pe cele de la (c); reprezentați norii de puncte \((z_i,v_i)\).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
set.seed(36); B <- 1e5
frac <- function(x, y) cbind(Z = ___, V = ___)   # transformarea h
E13 <- frac(rexp(B, 1), rexp(B, 3))       # (b): lambda = 1, mu = 3
E22 <- frac(rexp(B, 2), rexp(B, 2))       # (b): lambda = mu = 2
Un <- frac(runif(B), runif(B))            # (c): uniforme
round(rbind(
  simulare = c(mean(E13[, "Z"] <= 0.5), mean(E22[, "Z"] <= 0.3),
               mean(Un[, "Z"] <= 0.25)),
  exact = c(___, ___, ___)), 4)           # F_Z(0.5), F_Z(0.3), F_Z(0.25)
round(c(cor_13 = cor(E13)[1, 2], cor_22 = cor(E22)[1, 2],
        cor_unif = cor(Un)[1, 2]), 3)
plot(Un[1:3000, ], pch = 16, cex = 0.3)   # norul de puncte (z_i, v_i)
Când ne interesează o singură funcție \(g(X,Y)\) și mulțimea \(\{g\le z\}\) are o formă simplă, metoda funcției de repartiție este cea mai directă; pentru un vector uniform, probabilitatea este o arie.
Exercițiul 7 (Distanța de la un colț al pătratului la un punct aleator)
Pentru acasă Un senzor este montat într-un colț al unei încăperi pătrate cu latura \(1\), iar un obiect cade într-un punct \((X,Y)\) ales uniform în încăpere: cu senzorul în origine, \(X\) și \(Y\) sunt independente, \(\Unif(0,1)\). Fie \(D=\sqrt{X^2+Y^2}\) distanța de la senzor la obiect.
Determinați funcția de repartiție a lui \(D\), descriind pentru fiecare \(r>0\) mulțimea punctelor din pătrat aflate la distanță cel mult \(r\) de origine.
Deduceți densitatea lui \(D\) și densitatea lui \(D^2=X^2+Y^2\).
Calculați \(\PP(D\le1)\), \(\PP(D>1.2)\) și mediana lui \(D\).
În R: verificați (a)–(c) prin simulare, verificați numeric că \(f_D\) are integrala \(1\) și că \(\int r^2f_D(r)\dd r=\E[X^2]+\E[Y^2]\) și calculați distanța medie \(\E[D]\).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___ (funcția compara este cea din Exercițiul 5):
FD <- function(r) {                       # funcția de repartiție a lui D
  r <- pmin(pmax(r, 0), sqrt(2))          # F = 0 sub 0, F = 1 peste sqrt(2)
  al <- acos(pmin(1 / r, 1))              # alpha(r); 0 dacă r <= 1
  ___                                     # formula de la (a), cu al
}
fD <- function(r) ifelse(r > 0 & r < sqrt(2), ___, 0)   # densitatea lui D
set.seed(31); B <- 1e5
D <- ___                                  # B distanțe simulate
compara(D, FD, c(0.5, 1, 1.2))
mom <- function(k) integrate(function(r) r^k * fD(r), 0, sqrt(2))$value
round(c(integrala = mom(0), E_D2 = mom(2), E_D = mom(1),
        E_D_sim = mean(D), med_sim = median(D), med = ___), 4)
Răspunsuri
\(F_D(r)=\frac{\pi r^2}{4}\) pentru \(0<r\le1\) și \(F_D(r)=\sqrt{r^2-1}+r^2\big(\frac\pi4-\arccos\frac1r\big)\) pentru \(1<r<\sqrt2\).
Pe \((0,1)\) pătratul distanței are densitatea constantă \(\frac\pi4\), iar pe \((1,2)\) densitatea \(\frac\pi4-\arccos\frac1{\sqrt w}\).
\(\PP(D\le1)\approx0.7854\) și \(\PP(D>1.2)\approx0.0491\); mediana \(r=\sqrt{2/\pi}\approx0.798\).
integrala densității este \(1\), iar momentul de ordin doi este \(\frac23\), cum trebuie; distanța medie de la colț la un punct al pătratului este \(\E[D]\approx0.765\).
5 LNM, TLC, aproximări și lema lui Slutsky
LNM spune unde se concentrează \(\Xbar\); TLC descrie fluctuațiile, de ordinul \(\sigma/\sqrt n\), în jurul acestui punct. În primul exercițiu folosim TLC pentru calcule aproximative, comparând de fiecare dată cu valoarea exactă calculată în R. În al doilea combinăm inegalitatea lui Cebîșev, TLC, teorema aplicațiilor continue și lema lui Slutsky pentru a înlocui un parametru necunoscut cu un estimator — tehnica din spatele intervalelor de încredere asimptotice. Ultimul exercițiu „arată” cele două teoreme prin simulare și compară viteza cu care se instalează normalitatea pentru populații simetrice și asimetrice.
Exemplul rezolvat arată schema oricărui calcul aproximativ cu TLC: ce teoremă aplicăm și de ce avem voie, standardizarea, citirea lui \(\Phi\) și, pentru variabile cu valori întregi, corecția de continuitate.
Exemplul 4 (Răspunsuri la întâmplare la un test grilă cu 100 de întrebări)
Un test grilă are \(100\) de întrebări, fiecare cu cinci variante de răspuns, dintre care una corectă; un candidat răspunde la toate la întâmplare, independent. Fie \(S\) numărul răspunsurilor corecte. Aproximăm \(\PP(S\le15)\), \(\PP(17\le S\le23)\) și \(\PP(S=20)\).
Pasul 1 (modelul și teorema). \(S=X_1+\dots+X_{100}\), cu \(X_i\) i.i.d. \(\Bern(0.2)\) (\(X_i=1\) dacă răspunsul \(i\) este corect), deci \(S\sim\Bin(100,0.2)\), cu \(\E[S]=np=20\), \(\Var(S)=np(1-p)=100\cdot0.2\cdot0.8=16\) și \(\sigma_S=4\). Ipotezele TLC (Teorema 64 din Cursul 1) sunt îndeplinite — variabile i.i.d. cu varianța \(0.16\in(0,\infty)\) —, deci, din Corolarul 65 din Cursul 1, \(\frac{S-20}{4}\approx\Norm(0,1)\).
Pasul 2 (standardizarea, fără corecție). Scădem media și împărțim la abaterea standard în ambii membri ai inegalității: \[ \PP(S\le15)=\PP\Big(\frac{S-20}{4}\le\frac{15-20}{4}\Big)\approx\Phi(-1.25)=1-\Phi(1.25)\approx0.1056 . \]
Pasul 3 (corecția de continuitate). \(S\) ia numai valori întregi, deci \(\{S\le15\}=\{S\le15.5\}=\{S<16\}\): orice prag dintre \(15\) și \(16\) descrie același eveniment, dar aproximarea normală depinde de pragul ales. Alegem mijlocul, \(15.5\): în histograma repartiției, bara valorii \(k\) ocupă intervalul \(\big[k-\frac12,k+\frac12\big]\). Atunci \[ \PP(S\le15)=\PP(S\le15.5)\approx\Phi\Big(\frac{15.5-20}{4}\Big)=\Phi(-1.125)\approx0.1303 . \] Valoarea exactă, calculată mai jos, este \(0.1285\): eroarea scade de la \(0.023\) la \(0.002\). Regula: înaintea standardizării, pragul unui eveniment „\(\le k\)” devine \(k+\frac12\), iar al unuia „\(\ge k\)” devine \(k-\frac12\) (un eveniment „\(<k\)” se scrie întâi „\(\le k-1\)”, iar unul „\(>k\)”, „\(\ge k+1\)”).
Pasul 4 (un interval și un punct). Cu aceeași regulă la ambele capete, \(\{17\le S\le23\}=\{16.5\le S\le23.5\}\) și \(\{S=20\}=\{19.5\le S\le20.5\}\); pragurile standardizate sunt \(\pm\frac{3.5}{4}=\pm0.875\), respectiv \(\pm\frac{0.5}{4}=\pm0.125\), deci, aproximând probabilitatea unui interval \([a,b]\) al valorii standardizate prin \(\Phi(b)-\Phi(a)\) (Corolarul 65 din Cursul 1) și folosind \(\Phi(-c)=1-\Phi(c)\), \[ \PP(17\le S\le23)\approx2\Phi(0.875)-1\approx0.6184,\qquad \PP(S=20)\approx2\Phi(0.125)-1\approx0.0995, \] iar fără corecție am fi obținut \(2\Phi(0.75)-1\approx0.5467\) pentru interval (pierdem câte o jumătate de bară la fiecare capăt) și \(0\) pentru punct. Pe scurt, cu corecție, \(\PP(S\le15)\approx0.1303\), \(\PP(17\le S\le23)\approx0.6184\) și \(\PP(S=20)\approx0.0995\).
Laborator Comparăm cu valorile exacte: pbinom este funcția de repartiție a binomialei, deci \(\PP(17\le S\le23)=F(23)-F(16)\), iar dbinom este funcția de masă. Coloanele tabelului corespund, în ordine, probabilităților \(\PP(S\le15)\), \(\PP(17\le S\le23)\) și \(\PP(S=20)\).
std <- function(k) pnorm((k - 20) / 4)       # Phi după standardizare
round(rbind(
  exact   = c(pbinom(15, 100, 0.2),
              pbinom(23, 100, 0.2) - pbinom(16, 100, 0.2),
              dbinom(20, 100, 0.2)),
  fara_cc = c(std(15), std(23) - std(17), 0),
  cu_cc   = c(std(15.5), std(23.5) - std(16.5), std(20.5) - std(19.5))), 4)
#> [,1] [,2] [,3]
#> exact 0.1285 0.6186 0.0993
#> fara_cc 0.1056 0.5467 0.0000
#> cu_cc 0.1303 0.6184 0.0995Cu corecție de continuitate, cele trei aproximări diferă de valorile exacte cu cel mult \(0.002\); fără corecție, erorile sunt \(0.023\), \(0.072\) și \(0.099\).
Exercițiul 8 (Aproximarea normală și corecția de continuitate)
Dacă timpul permite (a) Notele obținute la un examen au media \(6.1\) și abaterea standard \(1.5\). Aproximați probabilitatea ca media notelor a \(38\) de studenți aleși la întâmplare (independent) să fie cel mult \(5.5\).
Timpul de așteptare al unui client la un ghișeu (măsurat într-o unitate de timp fixată) are media \(1.5\) și varianța \(1\). Aproximați probabilitatea ca timpul total de așteptare a \(100\) de clienți (independenți) să fie cel mult \(120\).
Fie \(Y\sim\Bin(25,0.4)\). Aproximați \(\PP(Y\le8)\) și \(\PP(Y=8)\), fără și cu corecție de continuitate.
O monedă echilibrată se aruncă de \(100\) de ori. Aproximați probabilitatea de a obține cel puțin \(55\) de steme.
În R: comparați aproximările de la (c) și (d) cu valorile exacte și cu frecvențele obținute din \(10^5\) simulări. Apoi, pentru \(S_n\sim\Bin(n,p)\), calculați eroarea maximă \(\max_k|\PP(S_n\le k)-\text{aproximare}|\) a aproximării normale (fără și cu corecție de continuitate) și a aproximării Poisson, pentru \(p\in\{0.3,\,0.05\}\) și \(n\in\{10,100,1000\}\).
Laborator Schelet de cod pentru (e) — completați locurile marcate cu ___:
s <- sqrt(6)                                   # sigma pentru Bin(25, 0.4)
tab <- rbind(exact = c(___, ___, ___),         # pbinom, dbinom, pbinom
             cu_cc = c(___, ___, ___))         # pragurile k + 0.5, k - 0.5
set.seed(16); B <- 1e5
y <- rbinom(B, 25, 0.4); st <- rbinom(B, 100, 0.5)   # B valori simulate
round(rbind(tab, simulare = c(mean(y <= 8), mean(y == 8), mean(st >= 55))), 4)
erori_aprox <- function(n, p) {
  k <- 0:n; s <- sqrt(n * p * (1 - p)); F <- pbinom(k, n, p)
  c(n = n, fara_cc = max(abs(F - ___)), cu_cc = max(abs(F - ___)),
    poisson = max(abs(F - ___)))
}
round(t(sapply(c(10, 100, 1000), erori_aprox, p = 0.3)), 5)   # și p = 0.05
Răspunsuri
\(\PP(\Xbar\le5.5)\approx0.0068\).
\(\PP(T\le120)\approx0.00135\).
\(\PP(Y\le8)\approx0.207\) fără corecție și \(\approx0.270\) cu corecție; \(\PP(Y=8)\approx0\) fără corecție și \(\approx0.116\) cu corecție.
Fără corecție, \(\PP(Y\ge55)\approx1-\Phi\big(\frac{55-50}{5}\big)=1-\Phi(1)\approx0.159\); cu corecție, \(\{Y\ge55\}=\{Y\ge54.5\}\) (pragul coboară cu \(\frac12\)) și \(\PP(Y\ge55)\approx1-\Phi\big(\frac{54.5-50}{5}\big)=1-\Phi(0.9)\approx0.184\).
Cu corecție de continuitate, aproximarea normală diferă deci de valoarea exactă cu cel mult \(0.004\); aproximarea normală cere ca \(np\) și \(n(1-p)\) să fie mari, cea Poisson ca \(p\) să fie mic.
În exercițiul următor volumul eșantionului este necunoscuta: cât de mare trebuie să fie \(n\) pentru o precizie dată? Răspunsul depinde mult de instrumentul folosit.
Exercițiul 9 (Volumul unui sondaj. Cebîșev, TLC și Slutsky)
La seminar Pentru a estima proporția \(p\in(0,1)\) a alegătorilor care susțin o propunere, se intervievează \(n\) persoane alese independent; fie \(\hat p_n=S_n/n\) proporția răspunsurilor „da”, cu \(S_n\sim\Bin(n,p)\). Vrem ca \(\PP(|\hat p_n-p|\le0.03)\ge0.95\) oricare ar fi \(p\).
Determinați un volum \(n\) suficient folosind inegalitatea lui Cebîșev.
Determinați \(n\) folosind TLC. Verificați în R probabilitatea exactă pentru volumul găsit.
Arătați că \(Z_n=\dfrac{\sqrt n(\hat p_n-p)}{\sqrt{\hat p_n(1-\hat p_n)}}\dto\Norm(0,1)\) și deduceți un interval aleator care conține \(p\) cu probabilitatea aproximativ \(0.95\). Aplicați pentru \(n=1068\) persoane, dintre care \(587\) au răspuns „da”.
În R: calculați intervalul de la (c) și estimați prin simulare probabilitatea ca un astfel de interval să conțină \(p\), pentru \(p=0.55\) și \(n\in\{30,1068\}\).
Laborator Schelet de cod pentru (b) — completați locurile marcate cu ___:
n <- ___                             # volumul găsit la (b)
prob_exacta <- function(p) {         # P(|p_hat - p| <= 0.03), exact
  lo <- ceiling(n * (p - 0.03) - 1e-9); hi <- floor(n * (p + 0.03) + 1e-9)
  ___                                # P(lo <= S_n <= hi), cu pbinom
}
round(prob_exacta(c(0.1, 0.2, 0.3, 0.4, 0.5)), 4)
pf <- seq(0.3, 0.7, by = 0.0001)     # grilă fină de valori p
v <- prob_exacta(pf)
c(minim = ___, p_minim = ___)        # minimul și punctul în care e atins
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
ph <- 587 / 1068
ph + c(-1, 1) * ___                      # intervalul de la (c)
acoperire <- function(n, p, B = 1e5) {   # P(intervalul conține p), simulat
  ph <- rbinom(B, n, p) / n              # B proporții de selecție
  mean(___)                              # intervalul conține p?
}
set.seed(19)
c(n_30 = acoperire(30, 0.55), n_1068 = acoperire(1068, 0.55))
Ultimul exercițiu al secțiunii nu mai calculează nimic nou: el arată, prin simulare, cele două teoreme limită la lucru.
Exercițiul 10 (Legea numerelor mari și TLC, văzute prin simulare)
Pentru acasă Fie \(X_1,X_2,\dots\) i.i.d., cu media \(\mu\) și abaterea standard \(\sigma\in(0,\infty)\), \(p_n(\varepsilon)=\PP(|\Xbar-\mu|>\varepsilon)\) și \(Z_n=\sqrt n(\Xbar-\mu)/\sigma\).
Pentru populația \(\Exp(1)\) și \(\varepsilon=0.1\), comparați, pentru \(n=100\) și \(n=500\), marginea dată de inegalitatea lui Cebîșev pentru \(p_n(\varepsilon)\), aproximarea dată de TLC și valoarea exactă.
În R: simulați \(5\,000\) de traiectorii \(n\mapsto\bar x_n\), \(n\le1000\), ale mediilor unei populații \(\Exp(1)\), estimați \(p_n(0.1)\) prin frecvența traiectoriilor aflate în afara benzii \(1\pm0.1\) și comparați cu valorile de la (a).
Calculați \(\mu\) și \(\sigma\) pentru populația lognormală (\(X=e^W\), cu \(W\sim\Norm(0,1)\)). În R: pentru populațiile \(\Unif(0,1)\), \(\Exp(1)\) și lognormală și pentru \(n\in\{5,30,200\}\), estimați din \(2\cdot10^4\) eșantioane simulate probabilitățile \(\PP(Z_n\le-1.645)\) și \(\PP(Z_n>1.645)\), pe care TLC le aproximează prin \(0.05\). Ce observați?
Laborator Schelet de cod pentru (b) — completați locurile marcate cu ___:
traiectorii <- function(rgen, N, M) {
  X <- matrix(rgen(N * M), nrow = N)   # coloana j: un șir X_1, ..., X_N
  ___                                  # coloana j: mediile cumulate
}
set.seed(10); eps <- 0.1; n <- c(100, 500)
Ym <- traiectorii(rexp, N = 1000, M = 5000)     # 5000 de traiectorii
pn <- ___                              # frecvența ieșirilor din bandă
round(rbind(simulare = pn[n], TLC = ___,
            exact = pgamma(0.9 * n, n) +
              pgamma(1.1 * n, n, lower.tail = FALSE),
            Cebisev = pmin(1, 1 / (n * eps^2))), 4)
Laborator Schelet de cod pentru (c) — completați locurile marcate cu ___:
medii_std <- function(rgen, mu, sigma, n, B = 2e4) {
  x <- matrix(rgen(n * B), nrow = B)      # B eșantioane de volum n
  ___                                     # B medii standardizate
}
cozi <- function(z) c(stanga = mean(z <= -1.645), dreapta = mean(z > 1.645))
set.seed(11); ns <- c(5, 30, 200)
s_ln <- ___                               # abaterea standard lognormală
tab <- rbind(
  sapply(ns, function(n) cozi(medii_std(runif, 0.5, sqrt(1 / 12), n))),
  sapply(ns, function(n) cozi(medii_std(rexp, 1, 1, n))),
  sapply(ns, function(n) cozi(medii_std(rlnorm, ___, s_ln, n))))
round(tab, 3)
Răspunsuri
\(1\) pentru \(n=100\) (o margine fără conținut: orice probabilitate este cel mult \(1\)) și \(0.2\) pentru \(n=500\); \(p_{100}(0.1)\approx2(1-\Phi(1))\approx0.317\); pentru \(n=500\) pragul este \(0.1\cdot\sqrt{500}=\sqrt5\approx2.236\), deci \(p_{500}(0.1)\approx2(1-\Phi(\sqrt5))\approx0.025\).
pentru \(n=100\), frecvența simulată este \(0.3206\), aproximarea TLC \(0.3173\), valoarea exactă \(0.3165\), iar marginea Cebîșev \(1\); pentru \(n=500\): \(0.0256\), \(0.0253\), \(0.0253\) și \(0.2\).
\(\mu=\E[e^W]=M_W(1)=e^{1/2}\approx1.649\) și \(\E[X^2]=\E[e^{2W}]=M_W(2)=e^2\), deci \(\sigma^2=e^2-\big(e^{1/2}\big)^2=e^2-e\approx4.67\) și \(\sigma\approx2.16\). Viteza cu care se instalează normalitatea depinde de populație: cu cât aceasta este mai asimetrică, cu atât convergența este mai lentă.
6 Exerciții suplimentare
Trei exerciții pentru studiul individual, rezolvate în aceeași formă: varianța combinațiilor liniare (cu o consecință pe care o vom folosi la varianța de selecție), minimul și maximul a două variabile cu repartiții diferite și un exercițiu care combină aproximarea normală și aproximarea Poisson ale repartiției binomiale.
Exercițiul 11 (Varianța combinațiilor liniare. Abaterile de la medie)
Pentru acasă (a) Randamentele \(X_1\), \(X_2\) a două active financiare au \(\Var(X_1)=1\), \(\Var(X_2)=4\) și \(\rho(X_1,X_2)=-0.5\). Calculați \(\Var(2X_1-X_2+3)\). Un investitor plasează fracțiunea \(a\in[0,1]\) din capital în primul activ; randamentul portofoliului este \(R_a=aX_1+(1-a)X_2\). Determinați \(a\) care minimizează \(\Var(R_a)\).
Fie \(X_1,\dots,X_n\), \(n\ge2\), cu varianțe pozitive și \(\rho(X_i,X_j)=\rho\) pentru orice \(i\ne j\). Arătați că \(\rho\ge-\frac{1}{n-1}\).
Fie \(Y_1,\dots,Y_n\) i.i.d. cu varianța \(\sigma^2>0\). Arătați că abaterile \(e_i=Y_i-\bar Y_n\) au exact corelația \(-\frac1{n-1}\) și deduceți că \(\E[S_n^2]=\sigma^2\), unde \(S_n^2=\frac{1}{n-1}\sum_{i=1}^n(Y_i-\bar Y_n)^2\).
În R: regăsiți rezultatele de la (a) cu formula \(\Cov(A\bX+\mathbf b)=A\Sigma A^\top\) și verificați (c) prin simulare, pentru \(n=4\).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
Sigma <- matrix(c(1, -1, -1, 4), 2)            # matricea de covarianță
A <- rbind(c(2, -1), ___)                      # liniile: combinațiile
A %*% Sigma %*% t(A)                           # Cov(A X + b)
set.seed(3)
Yb <- matrix(rnorm(4 * 1e5), ncol = 4)         # 1e5 eșantioane, n = 4
E <- ___                                       # abaterile de la medie
round(cor(E), 3)
mean(___)                                      # media valorilor lui S^2
Răspunsuri
\(\Var(2X_1-X_2+3)=4\cdot1+1\cdot4+2\cdot2\cdot(-1)\cdot(-1)=4+4+4=12\); \(a^*=\frac57\in[0,1]\), cu \(\Var(R_{a^*})=\frac37\).
\(\rho\ge-\frac1{n-1}\).
\(\rho(e_i,e_j)=-\frac1{n-1}\); \(\E[S_n^2]=\sigma^2\).
pe diagonală regăsim \(\Var(2X_1-X_2+3)=12\) și \(\Var(R_{a^*})=\frac37\approx0.4286\); corelațiile empirice ale abaterilor, între \(-0.335\) și \(-0.332\), sunt apropiate de \(-\frac13\).
Propoziția 51 din Cursul 1 nu cere ca variabilele să aibă aceeași repartiție. În exercițiul următor ele provin din familii diferite, iar una dintre ele este mărginită.
Exercițiul 12 (Primul sosit: autobuzul sau taxiul)
Pentru acasă Un călător ajunge în stație și pleacă cu primul vehicul care sosește. Autobuzul sosește după un timp \(X\sim\Unif(0,1)\) (măsurat în ore: autobuzele trec din oră în oră, iar călătorul nu cunoaște orarul), iar un taxi liber trece după un timp \(Y\sim\Exp(\lambda)\), independent de \(X\). Fie \(T=\min(X,Y)\) timpul de așteptare și \(M=\max(X,Y)\) momentul până la care au trecut ambele vehicule.
Determinați funcția de repartiție, densitatea și media lui \(T\).
Calculați probabilitatea ca taxiul să sosească primul.
Determinați densitatea și media lui \(M\).
În R: verificați rezultatele prin simulare pentru \(\lambda=3\).
Laborator Schelet de cod pentru (d) — completați locurile marcate cu ___:
lam <- 3; set.seed(33); B <- 1e5
x <- runif(B); y <- rexp(B, lam)          # autobuzul și taxiul
Tm <- ___; M <- ___                       # primul și ultimul sosit
e <- (1 - exp(-lam)) / lam
round(rbind(
  simulare = c(E_T = mean(Tm), P_taxi = mean(___), E_M = mean(M),
               P_T = mean(Tm <= 0.2), P_M = mean(M <= 0.5)),
  exact = c(___, ___, ___,                # E[T], P(Y < X), E[M], cu e
            1 - 0.8 * exp(-0.2 * lam), 0.5 * (1 - exp(-0.5 * lam)))), 4)
Răspunsuri
\(F_T(t)=1-(1-t)e^{-\lambda t}\) și \(f_T(t)=\big(1+\lambda(1-t)\big)e^{-\lambda t}\) pe \((0,1)\), \(\E[T]=\frac1\lambda-\frac{1-e^{-\lambda}}{\lambda^2}\).
\(\PP(Y<X)=1-\frac{1-e^{-\lambda}}{\lambda}=\lambda\,\E[T]\).
\(f_M(t)=1-e^{-\lambda t}+\lambda te^{-\lambda t}\) pe \((0,1)\), \(f_M(t)=\lambda e^{-\lambda t}\) pe \((1,\infty)\) și \(\E[M]=\frac12+\frac{1-e^{-\lambda}}{\lambda^2}\).
\(\E[T]\) este \(0.2276\) față de \(0.2278\), \(\PP(Y<X)\) este \(0.6832\) față de \(0.6833\), iar \(\E[M]\) este \(0.6051\) față de \(0.6056\).
Ultimul exercițiu suplimentar folosește ambele aproximări ale repartiției binomiale din Exercițiul 8: cea normală (pentru \(p\) fixat și \(n\) mare) și cea Poisson (pentru \(p\) mic).
Exercițiul 13 (Serii de aruncări ale unei monede)
Pentru acasă Se efectuează \(20\) de serii de câte \(400\) de aruncări ale unei monede echilibrate. Fie \(F_1,\dots,F_{20}\) frecvențele relative ale stemei în cele \(20\) de serii și \(N\) numărul de serii pentru care \(F_i\notin(0.45,\,0.55)\).
Care este repartiția lui \(N\)? Aproximați parametrul ei cu TLC, fără și cu corecție de continuitate.
Care dintre evenimentele \(\{N=0\}\), \(\{N=1\}\), \(\{N\ge2\}\) este cel mai probabil? Folosiți aproximarea Poisson.
În R: calculați exact parametrul de la (a) și probabilitățile de la (b) și verificați-le prin simulare.
Laborator Schelet de cod pentru (c) — completați locurile marcate cu ___:
p <- ___                         # P(F_i în afara lui (0.45, 0.55)), exact
c(exact = p, TLC = 2 * pnorm(-2), TLC_cc = 2 * pnorm(-1.95))
set.seed(20)
N <- replicate(10000, ___)       # numărul de serii cu F_i în afara benzii
round(rbind(binomiala = c(dbinom(0:1, 20, p), 1 - pbinom(1, 20, p)),
            poisson   = c(dpois(0:1, ___), 1 - ppois(1, ___)),
            simulare  = c(mean(N == 0), mean(N == 1), mean(N >= 2))), 4)
Răspunsuri
\(N=\sum_{i=1}^{20}\xi_i\sim\Bin(20,p)\); \(p=\PP(|Z|\ge2)\approx2(1-\Phi(2))\approx2\cdot0.0228\approx0.0455\); \(p\approx\Phi(-1.95)+1-\Phi(1.95)=2\Phi(-1.95)\approx2\cdot0.0256=0.0512\).
Evenimentul \(\{N=1\}\) este cel mai probabil, dar cele trei probabilități sunt comparabile (aproximativ \(e^{-1}\), \(e^{-1}\) și \(1-2e^{-1}\)).
valoarea exactă \(p\approx0.0510\) este foarte aproape de aproximarea cu corecție de continuitate (\(0.0512\)); probabilitățile exacte ale celor trei evenimente sunt \(0.351\), \(0.377\) și \(0.272\).
7 Temă
Fie \(Y\sim\Bin(n,p)\), \(p\in(0,1)\) fixat, și \(U_n=(Y-np)/\sqrt{np(1-p)}\). (a) Arătați, cu f.g.m. și teorema lui Curtiss, că \(U_n\dto\Norm(0,1)\) (teorema Moivre–Laplace, fără a folosi TLC). (b) Aproximați \(\PP(148\le Y\le159)\) pentru \(Y\sim\Bin(500,0.3)\) și comparați cu valoarea exactă. (Indicație: cu \(q=1-p\), \(\sigma_n=\sqrt{npq}\) și \(u=t/\sigma_n\), \(M_{U_n}(t)=\big(q\,e^{-pu}+p\,e^{qu}\big)^n\); din formula lui Taylor, \(q\,e^{-pu}+p\,e^{qu}=1+\frac{pq\,u^2}{2}+r(u)\) cu \(|r(u)|\le C|u|^3\) pentru \(|u|\le1\); aplicați Lema 62 din Cursul 1 cu \(a_n=npq\,u^2/2+n\,r(u)\to t^2/2\). Răspuns (b): cu corecție de continuitate, \(\Phi(0.927)-\Phi(-0.244)\approx0.419\); exact \(0.417\).)
(Densitatea \(c\,xy\) pe un triunghi) Vectorul \((X,Y)\) are densitatea \(c\,xy\) pe \(\{0\le y\le x\le1\}\). Determinați \(c\), marginalele, \(\Cov(X,Y)\) și \(\rho(X,Y)\); sunt \(X\) și \(Y\) independente, deși densitatea are forma unui produs pe suport? Verificați în R, generând \(X=U^{1/4}\) și \(Y=X\sqrt V\), cu \(U,V\) i.i.d. \(\Unif(0,1)\), și calculând
covșicor. (Răspuns: \(c=8\), \(f_X(x)=4x^3\), \(f_Y(y)=4y(1-y^2)\) pe \([0,1]\); \(\E X=\frac45\), \(\E Y=\frac8{15}\), \(\E[XY]=\frac49\), \(\Cov(X,Y)=\frac4{225}\), \(\Var X=\frac2{75}\), \(\Var Y=\frac{11}{225}\), \(\rho\approx0.492\); nu sunt independente: suportul nu este un dreptunghi.)(Convergență în probabilitate fără convergența mediilor) Fie \(X_n\) cu \(\PP(X_n=n)=\frac1n\) și \(\PP(X_n=0)=1-\frac1n\). Arătați că \(X_n\pto0\) și \(X_n\dto0\), dar că \(X_n\) nu converge la \(0\) în \(L^1\). Pentru ce valori \(a>0\) șirul \(Y_n\), cu \(\PP(Y_n=n)=n^{-a}\) și \(\PP(Y_n=0)=1-n^{-a}\), converge la \(0\) în medie pătratică? (Răspuns: pentru \(n>\varepsilon\), \(\PP(|X_n|>\varepsilon)=\frac1n\to0\); convergența în repartiție rezultă din Teorema 56(c) din Cursul 1; \(\E|X_n|=n\cdot\frac1n=1\not\to0\). \(\E[Y_n^2]=n^{2-a}\to0\) dacă și numai dacă \(a>2\): convergența în probabilitate nu controlează momentele — o masă de probabilitate mică, plasată foarte departe, împiedică media să tindă la limită.)
(Produsul unei uniforme cu o variabilă Gamma) Un echipament cu timpul de funcționare \(Y\sim\GammaD(2,\lambda)\) este inspectat la un moment ales uniform în acest interval: momentul inspecției este \(W=UY\), cu \(U\sim\Unif(0,1)\) independentă de \(Y\). Determinați, cu variabila auxiliară \(Y\), densitatea vectorului \((W,Y)\) și arătați că \(W\sim\Exp(\lambda)\); comparați, pentru \(\lambda=1\), cu Exercițiul 3. (Răspuns: cu \(h(u,y)=(uy,y)\), \(h^{-1}(w,y)=\big(\frac wy,y\big)\) și \(|J_{h^{-1}}|=\frac1y\), \(f_{(W,Y)}(w,y)=\lambda^2e^{-\lambda y}\) pe \(\{0<w<y\}\); integrând în \(y\), \(f_W(w)=\int_w^\infty\lambda^2e^{-\lambda y}\dd y=\lambda e^{-\lambda w}\), \(w>0\). Pentru \(\lambda=1\) obținem exact densitatea din exercițiul citat: este reciproca rezultatului despre raportul \(U\) din Exercițiul 6(b).)
(Suma și diferența a două exponențiale) Fie \(X\) și \(Y\) i.i.d. \(\Exp(\lambda)\), \(U=X+Y\) și \(V=X-Y\). Determinați densitatea comună a vectorului \((U,V)\) cu Corolarul 53 din Cursul 1 și densitățile marginale; arătați că \(U\) și \(V\) sunt necorelate, dar nu sunt independente. În R, reprezentați \(3\,000\) de puncte \((u_i,v_i)\) simulate și calculați corelația empirică. (Răspuns: \(f_{(U,V)}(u,v)=\frac{\lambda^2}{2}e^{-\lambda u}\) pe \(\{|v|<u\}\); \(f_U(u)=\lambda^2ue^{-\lambda u}\), \(u>0\), adică \(\GammaD(2,\lambda)\), și \(f_V(v)=\frac\lambda2e^{-\lambda|v|}\) — pentru \(\lambda=1\), repartiția Laplace din Exercițiul 2, cu \(\theta=0\); \(\Cov(U,V)=\Var(X)-\Var(Y)=0\), dar \(\PP(U\le1,\ |V|>1)=0\), deși ambele evenimente au probabilitate pozitivă; norul de puncte umple unghiul \(\{|v|<u\}\).)
(Suprarezervare) Un avion are \(200\) de locuri, iar fiecare cumpărător de bilet se prezintă la îmbarcare cu probabilitatea \(0.9\), independent de ceilalți. Determinați cel mai mare număr \(n\) de bilete vândute pentru care probabilitatea ca locurile să nu ajungă este cel mult \(0.05\): cu aproximarea normală cu corecție de continuitate și exact, în R, cu
pbinom. (Răspuns: cu \(S_n\sim\Bin(n,0.9)\), condiția \((200.5-0.9n)/(0.3\sqrt n)\ge1.645\) devine, cu \(s=\sqrt n\), \(0.9s^2+0.4935s-200.5\le0\), deci \(n\le214.7\) și \(n=214\); exact, \(\PP(S_{215}\ge201)\approx0.0496\) și \(\PP(S_{216}\ge201)\approx0.0782\), deci \(215\) — asimetria binomialei pentru \(p=0.9\) face aproximarea să piardă un bilet.)(Funcții de medii) Fie \(X_1,X_2,\dots\) i.i.d. \(\Exp(\lambda)\), \(\lambda>0\). Determinați limitele aproape sigure ale șirurilor \(A_n=\sum_{i=1}^nX_i^2\big/\sum_{i=1}^nX_i\) și \(B_n=n\sum_{i=1}^nX_i^2\big/\big(\sum_{i=1}^nX_i\big)^2\) și construiți, pornind de la \(C_n=\frac1n\sum_{i=1}^ne^{-X_i}\), un șir \(\hat\lambda_n\), funcție doar de \(X_1,\dots,X_n\), cu \(\hat\lambda_n\asto\lambda\). (Indicație: împărțiți numărătorul și numitorul la \(n\), respectiv la \(n^2\); aplicați Teorema 61 din Cursul 1 mediilor \(\Xbar\), \(\frac1n\sum_iX_i^2\) și \(C_n\), apoi Teorema 57(a) din Cursul 1. Răspuns: \(A_n\asto\frac{2/\lambda^2}{1/\lambda}=\frac2\lambda\) și \(B_n\asto2\), oricare ar fi \(\lambda\); \(C_n\asto\E[e^{-X_1}]=M_{X_1}(-1)=\frac{\lambda}{\lambda+1}\), deci \(\hat\lambda_n=\frac{C_n}{1-C_n}\).)
(R) Fie \(X_i\) i.i.d. Pareto, cu densitatea \(f(x)=1.5\,x^{-2.5}\), \(x\ge1\) (generare: \(X=U^{-1/1.5}\), \(U\sim\Unif(0,1)\)). Arătați că \(\E[X_1]=3\), dar \(\Var(X_1)=\infty\), și că \(X_1\) nu admite f.g.m. Desenați \(20\) de traiectorii \(n\mapsto\bar x_n\), \(n\le10^4\) (cu funcția
traiectoriidin Exercițiul 10), și histograma lui \(\sqrt n(\Xbar-3)\) pentru \(n=1000\). Ce rezultat limită se aplică și care nu? (Răspuns: LNM se aplică (\(\E|X_1|<\infty\)), TLC nu: histograma este puternic asimetrică și nu se stabilizează când \(n\) crește; convergența lui \(\bar x_n\) este lentă, cu salturi mari.)(Uniforma pe disc) Fie \((X,Y)\) uniform pe discul unitate \(\{x^2+y^2\le1\}\) (densitatea \(1/\pi\)). Arătați că \(f_X(x)=\frac2\pi\sqrt{1-x^2}\) pe \([-1,1]\), că \(\Cov(X,Y)=0\), dar că \(X\) și \(Y\) nu sunt independente. (Indicație: integrați în \(y\) pe secțiunea \(|y|<\sqrt{1-x^2}\), ca în Exemplul 2; \(\E[XY]=\E[X]=0\) din simetria \((x,y)\mapsto(-x,y)\); \(\PP(X>0.8,\ Y>0.8)=0\ne\PP(X>0.8)^2\).)
Într-un tabel de numere aleatoare, fiecare rând conține \(60\) de cifre independente, uniform repartizate pe \(\{0,\dots,9\}\). Aproximați probabilitatea ca un rând să conțină între \(25\) și \(35\) (inclusiv) cifre impare și comparați, în R, cu valoarea exactă. (Răspuns: numărul de cifre impare este \(\Bin(60,\frac12)\), cu media \(30\) și varianța \(15\); cu corecție de continuitate, ca în Exemplul 4, \(2\Phi(5.5/\sqrt{15})-1\approx0.844\); exact,
pbinom(35, 60, 0.5) - pbinom(24, 60, 0.5)\(\approx0.845\).)
Bibliografie
Casella, George, and Roger L. Berger. 2002. Statistical Inference. 2nd ed. Duxbury.
Dalang, Robert C., and Daniel Conus. 2018. Introduction à La Théorie Des Probabilités. 2nd ed. Presses polytechniques et universitaires romandes.
Delmas, Jean-François. 2010. Introduction Au Calcul Des Probabilités Et à La Statistique. Exercices, Problèmes Et Corrections. Les Presses de l’ENSTA.
Hogg, Robert V., Joseph W. McKean, and Allen T. Craig. 2019. Introduction to Mathematical Statistics. 8th ed. Pearson.
Knight, Keith. 2000. Mathematical Statistics. Texts in Statistical Science. Chapman & Hall/CRC.
Kupper, Lawrence L., Brian H. Neelon, and Sean M. O’Brien. 2013. Exercises and Solutions in Statistical Theory. Chapman & Hall/CRC.