În Cursul 2 am definit eșantionul ca pe un șir de variabile aleatoare independente și identic repartizate. Astăzi ne întrebăm, din două direcții opuse, de unde provin astfel de variabile. Din punct de vedere practic: cum extragem indivizii dintr-o populație finită (alegătorii unei țări, piesele unui lot, gospodăriile unui oraș) și ce se întâmplă cu precizia mediei atunci când extragerile se fac fără revenire, deci observațiile nu mai sunt independente? Din punct de vedere teoretic: există un câmp de probabilitate pe care să fie definit un șir infinit de variabile aleatoare independente cu repartiții date, așa cum cer legea numerelor mari și teorema limită centrală? Răspunsul la a doua întrebare trece printr-un instrument pe care îl vom folosi tot semestrul: funcția cuantilă, „inversa” unei funcții de repartiție oarecare.
Obiectivele cursului sunt următoarele:
să calculăm media și varianța mediei eșantionului pentru selecția simplă cu revenire și fără revenire dintr-o populație finită (covarianța extragerilor, factorul de corecție \(\frac{N-n}{N-1}\)) și să estimăm nedeplasat această varianță;
să definim funcția cuantilă și să demonstrăm proprietățile ei (lema fundamentală \(F^{-1}(u)\le x\iff u\le F(x)\), monotonia, relațiile dintre \(F\) și \(F^{-1}\)), cu exemple: repartiția exponențială, repartiția Cauchy, repartițiile discrete;
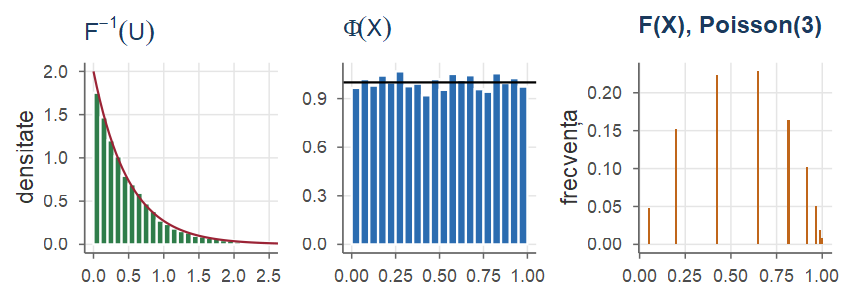
să demonstrăm universalitatea repartiției uniforme: \(F^{-1}(U)\sim F\) pentru orice \(F\) și \(F(X)\sim\Unif(0,1)\) pentru \(F\) continuă;
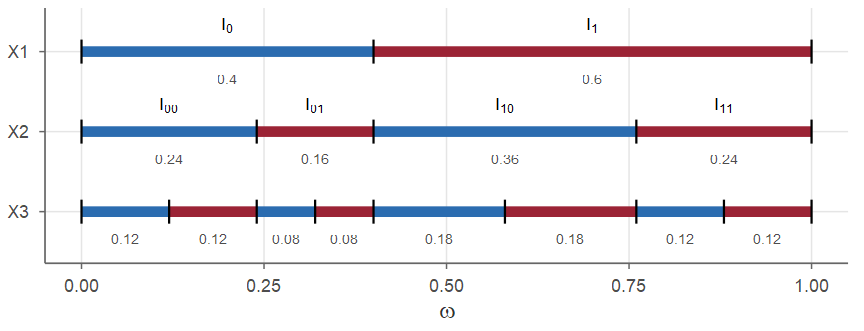
să demonstrăm teorema de existență a șirurilor de variabile aleatoare independente cu repartiții date, în trei pași (variabile Bernoulli \(\to\) uniforme independente \(\to\) repartiții arbitrare).
Structura: populații finite și selecția simplă cu și fără revenire (cu o privire asupra altor planuri de selecție); funcția cuantilă; universalitatea repartiției uniforme; existența eșantioanelor independente; exerciții rezolvate.
Folosim notațiile din cursurile anterioare. Câmpul de probabilitate pe care lucrăm este \((\Omega,\F,\PP)\); pentru o variabilă aleatoare \(X\), \(F_X(x)=\PP(X\le x)\) este funcția ei de repartiție, iar \(\Xbar=\frac1n\sum_iX_i\) și \(S_n^2=\frac1{n-1}\sum_i(X_i-\Xbar)^2\) sunt media și varianța eșantionului.
proprietățile probabilității (Propoziția 3 din Cursul 1), în particular continuitatea: dacă \(A_n\nearrow A\) sau \(A_n\searrow A\), atunci \(\PP(A_n)\to\PP(A)\);
funcția de repartiție (Propoziția 14 din Cursul 1): (a) \(F\) este crescătoare; (b) \(\lim_{x\to-\infty}F(x)=0\), \(\lim_{x\to+\infty}F(x)=1\); (c) \(F\) este continuă la dreapta; (d) \(F(x_0-)=\PP(X<x_0)\) și \(\PP(X=x_0)=F(x_0)-F(x_0-)\); în plus, funcția de repartiție determină repartiția (fapt admis);
măsurabilitatea (Definiția 11 din Cursul 1 și criteriul care o urmează): \(X\) este o variabilă aleatoare dacă și numai dacă \(\{X\le x\}\in\F\) pentru orice \(x\in\R\);
independența variabilelor aleatoare (Definiția 37 din Cursul 1, în forma echivalentă cu boreliene): \(\PP(X_1\in B_1,\dots,X_n\in B_n)=\prod_i\PP(X_i\in B_i)\) pentru orice boreliene \(B_i\); pentru v.a. discrete, independența este echivalentă cu factorizarea funcției de masă comune (Propoziția 38 din Cursul 1); funcții de v.a. independente sunt independente (Propoziția 39 din Cursul 1);
media și varianța: liniaritatea mediei (Propoziția 23 din Cursul 1), formula de transport (Teorema 22 din Cursul 1), \(\Var(X)=\E[X^2]-(\E X)^2\) și \(\Var(aX)=a^2\Var(X)\) (Propoziția 25 din Cursul 1), varianța unei sume \(\Var\big(\sum_iY_i\big)=\sum_i\Var(Y_i)+\sum_{i\ne j}\Cov(Y_i,Y_j)\) (Propoziția 42 din Cursul 1); pentru v.a. necorelate cu media \(\mu\) și varianța \(\sigma^2\), \(\E[\Xbar]=\mu\) și \(\Var(\Xbar)=\sigma^2/n\) (Corolarul 43 din Cursul 1).
Din Cursul 2: eșantionul de volum \(n\) din populația \(Q\) (Definiția 8 din Cursul 2) și câmpul produs\(\big(\R^n,\B(\R^n),Q^{\otimes n}\big)\) (Definiția 9 din Cursul 2), care, cu proiecțiile \(X_i(x_1,\dots,x_n)=x_i\), oferă un eșantion de volum \(n\) din \(Q\).
Pentru un număr finit de variabile, construcția produs rezolvă problema existenței eșantionului. Rămân deschise două întrebări, de naturi diferite, care dau cele două părți ale cursului.
Întrebarea practică. În sondaje și în controlul calității extragem indivizi dintr-o populație finită, de obicei fără revenire; observațiile nu mai sunt independente. Cât de mult contează acest lucru pentru precizia mediei eșantionului?
Întrebarea teoretică. Toate rezultatele asimptotice (legea numerelor mari, teorema limită centrală) privesc un șir infinit\(X_1,X_2,\dots\) de v.a. i.i.d. definite pe același câmp de probabilitate. Există un astfel de câmp? Vom vedea că intervalul \([0,1)\), cu lungimea drept probabilitate, este suficient de „bogat”.
2 Populații finite. Selecția simplă cu și fără revenire
Începem cu modelul cel mai simplu de culegere a datelor: o populație finită, cunoscută ca listă de indivizi, din care extragem la întâmplare câțiva indivizi.
Definiția 1(Populație finită)
O populație finită este o mulțime \(\mathcal{U}=\{1,2,\dots,N\}\) de indivizi, fiecărui individ \(j\) fiindu-i asociată o valoare numerică (deterministă) \(u_j\) a mărimii studiate. Media populației, totalul populației și varianța populației sunt \[
\mu=\frac1N\sum_{j=1}^Nu_j,\qquad \tau=\sum_{j=1}^Nu_j=N\mu,\qquad \sigma^2=\frac1N\sum_{j=1}^N(u_j-\mu)^2=\frac1N\sum_{j=1}^Nu_j^2-\mu^2 .
\] Un plan de selecție (metodă de selecție, plan de eșantionare) este o regulă probabilistă de alegere a unei submulțimi (sau a unui șir) de indivizi din \(\mathcal{U}\).
A doua expresie a varianței se obține dezvoltând pătratul: \(\frac1N\sum_j(u_j^2-2\mu u_j+\mu^2)=\frac1N\sum_ju_j^2-2\mu\cdot\mu+\mu^2\). Exemple: alegătorii unei țări (\(u_j=1\) dacă alegătorul \(j\) susține un candidat și \(0\) altfel, deci \(\mu\) este o proporție), piesele unui lot (\(u_j\) este diametrul piesei \(j\)), gospodăriile unui oraș (\(u_j\) este venitul lunar). Singura sursă de aleatorism este planul de selecție: valorile \(u_j\) sunt fixe, dar necunoscute. Aceasta este diferența de viziune față de modelul „populației infinite” \(F_\theta\) din Cursul 2; pentru teoria sondajelor, vezi (Rice 2007, cap. 7).
Definiția 2(Selecția aleatoare simplă)
Fie \(1\le n\le N\).
Selecția simplă cu revenire de volum \(n\): se extrage de \(n\) ori, independent, un individ uniform la întâmplare din \(\mathcal{U}\) (individul extras este „pus înapoi”). Indicii extrași \(J_1,\dots,J_n\) sunt i.i.d. uniformi pe \(\{1,\dots,N\}\) și observăm \(X_i=u_{J_i}\).
Selecția simplă fără revenire de volum \(n\): fiecare submulțime de \(n\) indivizi are aceeași probabilitate \(1/\binom Nn\) de a fi aleasă. Echivalent, extragem succesiv \(n\) indivizi, la fiecare pas uniform dintre cei încă neextrași: indicii ordonați \((J_1,\dots,J_n)\) sunt uniform repartizați pe mulțimea celor \(N(N-1)\cdots(N-n+1)\) aranjamente de \(n\) elemente distincte, iar observăm \(X_i=u_{J_i}\).
Echivalența celor două descrieri din (ii) rezultă printr-o numărare. Extrăgând succesiv, un aranjament fixat \((k_1,\dots,k_n)\) are probabilitatea \(\frac1N\cdot\frac1{N-1}\cdots\frac1{N-n+1}\) (formula înmulțirii: la pasul \(i\) mai sunt \(N-i+1\) indivizi disponibili). Fiecărei submulțimi \(\{k_1,\dots,k_n\}\) îi corespund \(n!\) aranjamente (ordonările ei), deci ea are probabilitatea \[
\frac{n!}{N(N-1)\cdots(N-n+1)}=\frac{n!\,(N-n)!}{N!}=\frac{1}{\binom Nn}.
\] În R, ambele planuri sunt implementate de funcția sample: sample(u, n) extrage fără revenire, iar sample(u, n, replace = TRUE) cu revenire.
Înainte de rezultatele generale, urmărim cele două definiții pe cea mai mică populație pe care se vede ceva: trei indivizi, din care extragem doi. Toate calculele se fac prin simplă numărare, iar valorile obținute vor fi regăsite, ca formule generale, în Propoziția 4 și în Teorema 5.
Exemplul 1(Cele două planuri pe o populație cu trei indivizi)
Fie o populație cu \(N=3\) indivizi, cu valorile \(u_1=1\), \(u_2=2\), \(u_3=6\), din care extragem un eșantion de volum \(n=2\).
Parametrii populației (Definiția 1). Media este \(\mu=\frac{1+2+6}{3}=3\), totalul este \(\tau=9\), iar abaterile \(u_j-\mu\) sunt \(-2,\ -1,\ 3\), deci \(\sigma^2=\frac{4+1+9}{3}=\frac{14}{3}\approx4.667\).
Cu revenire. Perechea de indici \((J_1,J_2)\) poate lua \(3^2=9\) valori, fiecare cu probabilitatea \(\frac19\). Valorile observate \((X_1,X_2)=(u_{J_1},u_{J_2})\) și media lor sunt: \[
\begin{array}{c|ccccccccc}
(X_1,X_2) & (1,1)&(1,2)&(1,6)&(2,1)&(2,2)&(2,6)&(6,1)&(6,2)&(6,6)\\\hline
\Xbar\rule{0pt}{2.6ex} & 1&1.5&3.5&1.5&2&4&3.5&4&6
\end{array}
\] Același individ poate fi extras de două ori (perechile \((1,1)\), \((2,2)\), \((6,6)\)). Din tabel, \(\PP(X_2=6)=\frac39=\frac13\) și \(\PP(X_2=6\mid X_1=6)=\frac{1/9}{3/9}=\frac13\): a doua extragere „nu știe” nimic despre prima.
Fără revenire. Rămân cele \(3\cdot2=6\) aranjamente cu indici distincți, fiecare cu probabilitatea \(\frac16\): \[
\begin{array}{c|cccccc}
(X_1,X_2) & (1,2)&(1,6)&(2,1)&(2,6)&(6,1)&(6,2)\\\hline
\Xbar\rule{0pt}{2.6ex} & 1.5&3.5&1.5&4&3.5&4
\end{array}
\] Aranjamentele se grupează două câte două în cele \(\binom32=3\) submulțimi \(\{1,2\}\), \(\{1,6\}\), \(\{2,6\}\), fiecare de probabilitate \(\frac26=\frac13=1/\binom32\): sunt cele două descrieri echivalente din Definiția 2(ii). Și aici \(\PP(X_2=6)=\frac26=\frac13\) (aranjamentele \((1,6)\) și \((2,6)\)): a doua extragere, privită singură, este tot uniformă pe populație. În schimb, \(\PP(X_2=6\mid X_1=6)=0\ne\frac13\): extragerile nu mai sunt independente.
Repartiția mediei eșantionului. Numărând în cele două tabele de câte ori apare fiecare valoare a mediei, obținem \[
\text{cu revenire:}\ \ \Xbar\sim\begin{pmatrix}1&1.5&2&3.5&4&6\\[2pt] \frac19&\frac29&\frac19&\frac29&\frac29&\frac19\end{pmatrix},\qquad
\text{fără revenire:}\ \ \Xbar\sim\begin{pmatrix}1.5&3.5&4\\[2pt] \frac13&\frac13&\frac13\end{pmatrix}.
\] În ambele cazuri media lui \(\Xbar\) este \(\mu\): \(\frac{1+2\cdot1.5+2+2\cdot3.5+2\cdot4+6}{9}=\frac{27}{9}=3\), respectiv \(\frac{1.5+3.5+4}{3}=3\). Varianțele însă diferă: \[
\begin{aligned}
\text{cu revenire:}\quad\Var(\Xbar)&=\frac{(-2)^2+2\,(-1.5)^2+(-1)^2+2\cdot0.5^2+2\cdot1^2+3^2}{9}\\
&=\frac{4+4.5+1+0.5+2+9}{9}=\frac{21}{9}=\frac73\approx2.333,\\
\text{fără revenire:}\quad\Var(\Xbar)&=\frac{(-1.5)^2+0.5^2+1^2}{3}=\frac{3.5}{3}=\frac76\approx1.167 .
\end{aligned}
\] Prima valoare este \(\sigma^2/n=\frac{14}{3}\cdot\frac12\); a doua este de două ori mai mică.
Covarianța extragerilor. Fără revenire, \(\E[X_1X_2]=\frac{1\cdot2+1\cdot6+2\cdot1+2\cdot6+6\cdot1+6\cdot2}{6}=\frac{40}{6}=\frac{20}{3}\), deci \(\Cov(X_1,X_2)=\frac{20}{3}-3\cdot3=-\frac73<0\): când prima valoare extrasă este mare, a doua tinde să fie mică. Cu revenire, suma celor nouă produse este \((1+2+6)^2=81\), deci \(\E[X_1X_2]=\frac{81}{9}=9=\mu^2\) și covarianța este nulă.
Ce am aflat. Cele două planuri dau aceeași repartiție fiecărei extrageri și aceeași medie lui \(\Xbar\), dar fără revenire extragerile sunt corelate negativ, iar media eșantionului este mai precisă. Teorema 5 va da formulele generale: covarianța este \(-\frac{\sigma^2}{N-1}=-\frac{14/3}{2}\), iar varianța mediei se înmulțește cu \(\frac{N-n}{N-1}=\frac{3-2}{3-1}=\frac12\).
Atât în cazul cu revenire, cât și în cel fără revenire, vom folosi următoarea identitate algebrică, valabilă pentru orice numere reale.
Lema 3(Descompunerea sumei pătratelor abaterilor)
Pentru orice numere reale \(x_1,\dots,x_n\), cu media \(\bar x=\frac1n\sum_ix_i\), și orice \(c\in\R\), \[
\sum_{i=1}^n(x_i-c)^2=\sum_{i=1}^n(x_i-\bar x)^2+n(\bar x-c)^2 .
\tag{1}\]
Demonstrație. Scriem \(x_i-c=(x_i-\bar x)+(\bar x-c)\) și ridicăm la pătrat: \[
(x_i-c)^2=(x_i-\bar x)^2+2(\bar x-c)(x_i-\bar x)+(\bar x-c)^2 .
\] Sumăm după \(i=1,\dots,n\); factorul \(2(\bar x-c)\) și termenul \((\bar x-c)^2\) nu depind de \(i\), deci \[
\sum_{i=1}^n(x_i-c)^2=\sum_{i=1}^n(x_i-\bar x)^2+2(\bar x-c)\sum_{i=1}^n(x_i-\bar x)+n(\bar x-c)^2 .
\] Din definiția mediei, \(\sum_{i=1}^nx_i=n\bar x\), deci \(\sum_{i=1}^n(x_i-\bar x)=n\bar x-n\bar x=0\): termenul din mijloc dispare și rămâne exact (1).■
2.1 Selecția cu revenire
Propoziția 4(Selecția simplă cu revenire)
La selecția simplă cu revenire, variabilele \(X_1,\dots,X_n\) sunt i.i.d., fiecare cu repartiția uniformă discretă pe valorile \(u_1,\dots,u_N\): \[
\PP(X_i=v)=\frac{\#\{j:\ u_j=v\}}{N},\qquad \E[X_i]=\mu,\qquad\Var(X_i)=\sigma^2 .
\] În consecință, \(\E[\Xbar]=\mu\), \(\Var(\Xbar)=\dfrac{\sigma^2}{n}\) și \(\E[S_n^2]=\sigma^2\) (pentru \(n\ge2\)).
Demonstrație.Ideea demonstrației. Indicii extrași sunt i.i.d. uniformi, iar observațiile sunt funcții de indici; suntem deci exact în cadrul eșantionului i.i.d. din Cursul 2.
Pasul 1 (independența). Extragerile fiind independente și uniforme, pentru orice \(k_1,\dots,k_n\in\{1,\dots,N\}\), \[
\PP(J_1=k_1,\dots,J_n=k_n)=\frac{1}{N^n}=\prod_{i=1}^n\PP(J_i=k_i):
\] funcția de masă comună a vectorului discret \((J_1,\dots,J_n)\) este produsul funcțiilor de masă marginale (fiecare \(J_i\) fiind uniformă, \(\PP(J_i=k_i)=\frac1N\)), deci \(J_1,\dots,J_n\) sunt independente (Propoziția 38 din Cursul 1). Cum \(X_i=g(J_i)\), cu aceeași funcție \(g(k)=u_k\) pentru orice \(i\), variabilele \(X_1,\dots,X_n\) sunt independente (Propoziția 39 din Cursul 1) și au aceeași repartiție (variabilele \(J_i\) au aceeași repartiție).
Pasul 2 (repartiția, media și varianța). Evenimentul \(\{X_i=v\}\) este \(\big\{J_i\in\{j:u_j=v\}\big\}\), o reuniune disjunctă de evenimente \(\{J_i=j\}\), fiecare de probabilitate \(\frac1N\); deci \(\PP(X_i=v)=\#\{j:u_j=v\}/N\). Media o calculăm cu formula de transport (Teorema 22 din Cursul 1), aplicată v.a. discrete \(J_i\) și funcției \(k\mapsto u_k\); varianța, \(\Var(X_i)=\E[(X_i-\mu)^2]\), cu aceeași formulă aplicată funcției \(k\mapsto(u_k-\mu)^2\): \[
\begin{aligned}
\E[X_i]&=\sum_{k=1}^N u_k\,\PP(J_i=k)=\frac1N\sum_{k=1}^Nu_k=\mu,\\
\Var(X_i)&=\sum_{k=1}^N(u_k-\mu)^2\,\PP(J_i=k)=\frac1N\sum_{k=1}^N(u_k-\mu)^2=\sigma^2 .
\end{aligned}
\]
Pasul 3 (media și varianța lui \(\Xbar\)). Variabilele \(X_i\) sunt independente, deci necorelate (Propoziția 42 din Cursul 1), cu media \(\mu\) și varianța \(\sigma^2\) (Pasul 2); Corolarul 43 din Cursul 1 dă \(\E[\Xbar]=\mu\) și \(\Var(\Xbar)=\sigma^2/n\).
Pasul 4 (media lui \(S_n^2\)). Aplicăm Lema 3 valorilor \(X_1(\omega),\dots,X_n(\omega)\), cu \(c=\mu\): \(\sum_i(X_i-\Xbar)^2=\sum_i(X_i-\mu)^2-n(\Xbar-\mu)^2\). Luăm media (liniaritatea, Propoziția 23 din Cursul 1) și folosim \(\E[(X_i-\mu)^2]=\Var(X_i)=\sigma^2\) și \(\E[(\Xbar-\mu)^2]=\Var(\Xbar)=\sigma^2/n\) (deoarece \(\E[\Xbar]=\mu\)): \[
\E\Big[\sum_{i=1}^n(X_i-\Xbar)^2\Big]=n\sigma^2-n\cdot\frac{\sigma^2}{n}=(n-1)\sigma^2,
\] iar împărțind la \(n-1\) obținem \(\E[S_n^2]=\sigma^2\).■
2.2 Selecția fără revenire. Factorul de corecție pentru populație finită
La selecția fără revenire, variabilele \(X_i\)nu mai sunt independente: dacă primul individ extras are o valoare mare, el nu mai poate fi extras din nou, deci următoarele valori tind să fie mai mici. Totuși, după cum vom vedea, fiecare \(X_i\) are aceeași repartiție marginală ca în cazul cu revenire.
Teorema 5(Selecția simplă fără revenire)
Fie \(X_1,\dots,X_n\) valorile obținute prin selecție simplă fără revenire de volum \(n\le N\) dintr-o populație finită cu media \(\mu\) și varianța \(\sigma^2\), cu \(N\ge2\). Atunci:
fiecare \(J_i\) este uniform pe \(\{1,\dots,N\}\), iar pentru \(i\ne j\), \(\PP(J_i=k,J_j=l)=\frac{1}{N(N-1)}\) dacă \(k\ne l\) și \(0\) dacă \(k=l\); în particular, \(\E[X_i]=\mu\) și \(\Var(X_i)=\sigma^2\);
\(\Cov(X_i,X_j)=-\dfrac{\sigma^2}{N-1}\) pentru \(i\ne j\);
\(\E[\Xbar]=\mu\) și \[
\Var(\Xbar)=\frac{\sigma^2}{n}\cdot\frac{N-n}{N-1};
\tag{2}\]
Demonstrație.Ideea demonstrației. Toate variabilele \(X_i\) au aceeași repartiție marginală, iar toate perechile \((X_i,X_j)\), \(i\ne j\), au aceeași repartiție comună (simetria planului); calculăm deci o singură varianță și o singură covarianță și le introducem în formula varianței unei sume.
Pasul 1 (repartițiile marginale și ale perechilor). Aranjamentele \((k_1,\dots,k_n)\) sunt egal probabile, fiecare cu probabilitatea \(1/[N(N-1)\cdots(N-n+1)]\) (Definiția 2). Fixăm \(i\) și \(k\in\{1,\dots,N\}\). Numărul aranjamentelor cu \(k_i=k\) este \((N-1)(N-2)\cdots(N-n+1)\): celelalte \(n-1\) poziții se completează, în ordine, cu elemente distincte dintre cele \(N-1\) rămase. Deci \[
\PP(J_i=k)=\frac{(N-1)\cdots(N-n+1)}{N(N-1)\cdots(N-n+1)}=\frac1N .
\] Așadar \(X_i=u_{J_i}\) are aceeași repartiție ca la selecția cu revenire, iar calculul de la Pasul 2 al demonstrației Propoziției 4 dă \(\E[X_i]=\mu\) și \(\Var(X_i)=\sigma^2\). Analog, pentru \(i\ne j\) și \(k\ne l\), fixând pozițiile \(i\) și \(j\), celelalte \(n-2\) poziții se completează în \((N-2)\cdots(N-n+1)\) moduri (pentru \(n=2\) produsul este gol, egal cu \(1\)), deci \[
\PP(J_i=k,J_j=l)=\frac{(N-2)\cdots(N-n+1)}{N(N-1)\cdots(N-n+1)}=\frac{1}{N(N-1)},
\] iar \(\PP(J_i=k,J_j=k)=0\), deoarece indicii extrași sunt distincți. Aceasta este partea (a).
Pasul 2 (covarianța). Notăm \(d_k=u_k-\mu\); avem \(\sum_kd_k=N\mu-N\mu=0\) și \(\sum_kd_k^2=N\sigma^2\) (definițiile lui \(\mu\) și \(\sigma^2\)). Cum \(\E[X_i]=\E[X_j]=\mu\) (Pasul 1), covarianța este media produsului \((X_i-\mu)(X_j-\mu)=d_{J_i}d_{J_j}\). O calculăm cu formula de transport pentru vectorul discret \((J_i,J_j)\) și funcția \((k,l)\mapsto d_kd_l\), folosind repartiția perechii de la Pasul 1 (doar perechile \(k\ne l\) au probabilitate nenulă): \[
\begin{aligned}
\Cov(X_i,X_j)&=\E\big[(X_i-\mu)(X_j-\mu)\big]=\sum_{k\ne l}d_kd_l\,\frac{1}{N(N-1)}
=\frac{1}{N(N-1)}\Big[\Big(\sum_{k=1}^Nd_k\Big)^2-\sum_{k=1}^Nd_k^2\Big]\\
&=\frac{1}{N(N-1)}\big[0-N\sigma^2\big]=-\frac{\sigma^2}{N-1},
\end{aligned}
\] unde am folosit identitatea \(\big(\sum_kd_k\big)^2=\sum_k\sum_ld_kd_l=\sum_kd_k^2+\sum_{k\ne l}d_kd_l\) (dezvoltarea pătratului unei sume: separăm termenii cu \(k=l\) de cei cu \(k\ne l\)). Aceasta este partea (b).
O verificare independentă. Aceeași valoare rezultă dintr-un argument elegant. Covarianța \(c=\Cov(X_i,X_j)\) depinde doar de repartiția perechii \((J_i,J_j)\), care, după Pasul 1, nu depinde de \(n\). În cazul extrem \(n=N\) (selecția întregii populații), \(\sum_{i=1}^NX_i=\sum_{k=1}^Nu_k\) este constantă, deci varianța ei este nulă; scriind varianța sumei cu \(N\) varianțe și \(N(N-1)\) covarianțe egale, \[
0=\Var\Big(\sum_{i=1}^NX_i\Big)=N\sigma^2+N(N-1)\,c\quad\Longrightarrow\quad c=-\frac{\sigma^2}{N-1}.
\]
Pasul 3 (media și varianța mediei). Din liniaritatea mediei, \(\E[\Xbar]=\frac1n\sum_i\E[X_i]=\mu\). Pentru varianță, \(\Var(\Xbar)=\frac1{n^2}\Var\big(\sum_iX_i\big)\) (Propoziția 25 din Cursul 1), iar varianța sumei (Propoziția 42 din Cursul 1) conține \(n\) varianțe și \(n(n-1)\) covarianțe (perechile ordonate \((i,j)\) cu \(i\ne j\)), toate egale conform Pașilor 1 și 2: \[
\begin{aligned}
\Var(\Xbar)&=\frac1{n^2}\Big(\sum_{i=1}^n\Var(X_i)+\sum_{i\ne j}\Cov(X_i,X_j)\Big)=\frac1{n^2}\Big(n\sigma^2-n(n-1)\frac{\sigma^2}{N-1}\Big)\\
&=\frac{\sigma^2}{n}\Big(1-\frac{n-1}{N-1}\Big)=\frac{\sigma^2}{n}\cdot\frac{(N-1)-(n-1)}{N-1}=\frac{\sigma^2}n\cdot\frac{N-n}{N-1}.
\end{aligned}
\]
Pasul 4 (media lui \(S_n^2\)). Din Lema 3 cu \(c=\mu\), \(\sum_i(X_i-\Xbar)^2=\sum_i(X_i-\mu)^2-n(\Xbar-\mu)^2\). Luând media și folosind \(\E[(X_i-\mu)^2]=\sigma^2\) (Pasul 1) și \(\E[(\Xbar-\mu)^2]=\Var(\Xbar)\) (Pasul 3), \[
\E\Big[\sum_{i=1}^n(X_i-\Xbar)^2\Big]=n\sigma^2-n\cdot\frac{\sigma^2}{n}\cdot\frac{N-n}{N-1}
=\sigma^2\,\frac{n(N-1)-(N-n)}{N-1}=\sigma^2\,\frac{N(n-1)}{N-1},
\] deoarece \(n(N-1)-(N-n)=nN-N=N(n-1)\). Împărțind la \(n-1\) obținem \(\E[S_n^2]=\frac{N}{N-1}\sigma^2\).■
Observație
Cazurile extreme verifică formula (2): pentru \(n=1\) factorul este \(1\) (o singură extragere nu „știe” dacă urmează reveniri), iar pentru \(n=N\) el este \(0\) (am observat întreaga populație, deci \(\Xbar=\mu\) fără eroare). (2) Covarianța negativă \(-\sigma^2/(N-1)\) formalizează intuiția: valorile extrase se „resping” reciproc. (3) Simetria planului (toate submulțimile sunt egal probabile) a fost folosită la Pasul 1; pentru planuri în care indivizii au probabilități inegale de a fi selectați formulele se schimbă. (4) Pasul 4 arată că la selecția fără revenire \(S_n^2\) estimează nu pe \(\sigma^2\), ci pe \(\frac{N}{N-1}\sigma^2=\frac{1}{N-1}\sum_j(u_j-\mu)^2\); de aceea, în teoria sondajelor, varianța populației se definește adesea cu numitorul \(N-1\).
Factorul \(\frac{N-n}{N-1}\le1\) se numește factorul de corecție pentru populație finită. Selecția fără revenire este deci întotdeauna cel puțin la fel de precisă ca selecția cu revenire, dar câștigul este neglijabil când fracția de selecție\(f=n/N\) este mică: pentru un sondaj cu \(n=1\,000\) de persoane dintr-o populație de \(N=10^6\), factorul este \(\frac{999\,000}{999\,999}\approx0.999\). De aceea modelul i.i.d. este folosit și pentru selecțiile fără revenire, cu condiția ca \(n/N\) să fie mic (practic \(n\le0.05N\)).
Corolarul 6(Estimarea erorii standard la selecția fără revenire)
În condițiile Teoremei 5, cu \(n\ge2\) și \(f=n/N\), statistica \[
\widehat{\Var}(\Xbar)=(1-f)\,\frac{S_n^2}{n}
\] este un estimator nedeplasat al lui \(\Var(\Xbar)\), iar \(N\Xbar\) este un estimator nedeplasat al totalului \(\tau\), cu \(\Var(N\Xbar)=N^2\Var(\Xbar)\).
Demonstrație. Din Teorema 5(d) și liniaritatea mediei, \[
\E\Big[(1-f)\frac{S_n^2}{n}\Big]=\frac{N-n}{N}\cdot\frac1n\cdot\frac{N}{N-1}\sigma^2=\frac{\sigma^2}{n}\cdot\frac{N-n}{N-1}=\Var(\Xbar),
\] conform părții (c). Pentru total, \(\E[N\Xbar]=N\mu=\tau\) (partea (c)) și \(\Var(N\Xbar)=N^2\Var(\Xbar)\) (Propoziția 25 din Cursul 1).■
Eroarea standard estimată a mediei este \(\sqrt{(1-f)S_n^2/n}\); pentru selecția cu revenire (sau \(f\approx0\)) se folosește \(S_n/\sqrt n\). Aplicăm aceste formule în Exercițiul 1.
Observație (La ce folosește eroarea standard)
Pentru \(n\) și \(N-n\) mari (și o populație fără valori extreme dominante), media eșantionului este aproximativ normal repartizată și la selecția fără revenire, deși observațiile nu sunt independente: este o variantă a Teoremei limită centrale pentru populații finite, pe care o admitem (Rice 2007, sec. 7.3). Prin urmare, cu o probabilitate de aproximativ \(0.95\), media \(\mu\) a populației se află la cel mult \(1.96\) erori standard de \(\Xbar\), unde \(1.96\approx z_{0.975}\) este cuantila de ordin \(0.975\) a repartiției normale standard (Exemplul 9). Cantitatea \(1.96\sqrt{\Var(\Xbar)}\), estimată prin \(1.96\sqrt{(1-f)S_n^2/n}\), se numește marja de eroare a sondajului; o folosim în Exercițiul 2 pentru a alege volumul eșantionului.
În primul dintre următoarele două exemple avem un singur eșantion, ca în practică, și calculăm eroarea standard estimată; în al doilea cunoaștem întreaga populație și verificăm teorema enumerând toate eșantioanele.
Exemplul 2(Eroarea standard estimată și factorul de corecție, în cifre)
O asociație de proprietari are \(N=120\) de apartamente. Administratorul citește apometrele din \(n=30\) de apartamente, alese prin selecție simplă fără revenire, și obține consumurile lunare de mai jos (în metri cubi, rotunjite la întreg): \[
\begin{array}{l|cccccccccc}
\text{consumul } x & 3&4&5&6&7&8&9&10&12&13\\\hline
\text{numărul de apartamente}\rule{0pt}{2.6ex} & 3&3&5&3&4&3&4&2&1&2
\end{array}
\] Estimăm consumul mediu pe apartament și consumul total al asociației, împreună cu precizia acestor estimări.
Pasul 1 (media eșantionului). Suma observațiilor se obține ponderând fiecare valoare cu frecvența ei: \[
\sum_ix_i=3\cdot3+4\cdot3+5\cdot5+6\cdot3+7\cdot4+8\cdot3+9\cdot4+10\cdot2+12\cdot1+13\cdot2=210,\qquad\bar x=\frac{210}{30}=7 .
\]
Pasul 2 (varianța eșantionului). La fel, \(\sum_ix_i^2=9\cdot3+16\cdot3+25\cdot5+36\cdot3+49\cdot4+64\cdot3+81\cdot4+100\cdot2+144+169\cdot2=1702\). Din Lema 3 cu \(c=0\), \(\sum_i(x_i-\bar x)^2=\sum_ix_i^2-n\bar x^2=1702-30\cdot49=232\), deci \(s^2=\frac{232}{30-1}=8\).
Pasul 3 (eroarea standard a mediei). Fracția de selecție este \(f=\frac{30}{120}=0.25\). Din Corolarul 6, \[
\widehat{\Var}(\Xbar)=(1-f)\frac{s^2}{n}=0.75\cdot\frac{8}{30}=0.2,\qquad\widehat{\mathrm{es}}(\Xbar)=\sqrt{0.2}\approx0.447 .
\] Fără factorul \(1-f\) am fi obținut \(\sqrt{8/30}\approx0.516\), adică am fi supraestimat eroarea standard cu aproximativ \(15\%\) (\(1/\sqrt{0.75}\approx1.155\)).
Pasul 4 (marja de eroare și totalul). Marja de eroare (observația precedentă) este \(1.96\cdot0.447\approx0.88\): consumul mediu pe apartament este estimat la \(7\pm0.88\) metri cubi. Pentru total, Corolarul 6 dă \(\hat\tau=N\bar x=120\cdot7=840\) de metri cubi, cu eroarea standard estimată \(N\cdot\widehat{\mathrm{es}}(\Xbar)=120\cdot0.447\approx53.7\) și marja de eroare \(1.96\cdot53.7\approx105\) metri cubi.
Cât contează mărimea populației? Păstrăm același eșantion (\(n=30\), \(s^2=8\)) și schimbăm doar numărul \(N\) al apartamentelor: \[
\begin{array}{l|cccccc}
N & 40 & 60 & 120 & 300 & 3\,000 & \infty\\\hline
f=n/N\rule{0pt}{2.6ex} & 0.75 & 0.5 & 0.25 & 0.1 & 0.01 & 0\\
\widehat{\mathrm{es}}(\Xbar)=\sqrt{(1-f)\,s^2/n} & 0.258 & 0.365 & 0.447 & 0.490 & 0.514 & 0.516
\end{array}
\] Când eșantionul acoperă cea mai mare parte a populației (\(N=40\)), eroarea standard se înjumătățește; pentru \(f\le0.05\) corecția este practic invizibilă. Când populația este mult mai mare decât eșantionul, precizia mediei de selecție depinde deci de volumul eșantionului\(n\) și aproape deloc de mărimea populației: \(30\) de apartamente spun la fel de mult despre un cartier cu \(3\,000\) de apartamente ca despre un oraș întreg.
Exemplul 3(Enumerarea tuturor eșantioanelor pentru N=6)
O populație are \(N=6\) indivizi, cu valorile \(2,4,5,7,9,15\). Se extrage un eșantion de volum \(n=2\). Verificăm Teorema 5 prin enumerarea tuturor eșantioanelor posibile.
Parametrii populației.\(\mu=(2+4+5+7+9+15)/6=42/6=7\). Abaterile \(u_j-\mu\) sunt \(-5,-3,-2,0,2,8\), cu suma pătratelor \(25+9+4+0+4+64=106\), deci \(\sigma^2=106/6=53/3\approx17.667\).
Formulele. Cu revenire, \(\Var(\Xbar)=\sigma^2/n=\frac{53}{6}\approx8.833\). Fără revenire, din (2) și din partea (d), \[
\Var(\Xbar)=\frac{53}{6}\cdot\frac{6-2}{6-1}=\frac{53}{6}\cdot\frac45=\frac{106}{15}\approx7.067,\qquad \E[S_2^2]=\frac65\cdot\frac{53}{3}=\frac{106}{5}=21.2 .
\]
Enumerarea fără revenire. Cele \(\binom62=15\) submulțimi sunt egal probabile, fiecare cu probabilitatea \(\frac1{15}\). Pentru fiecare eșantion \(\{a,b\}\) calculăm media \(\bar x=\frac{a+b}2\), abaterea pătratică \((\bar x-7)^2\) față de \(\mu=7\) și varianța eșantionului, care pentru două observații este \[
s^2=\frac{1}{2-1}\Big[\Big(a-\frac{a+b}2\Big)^2+\Big(b-\frac{a+b}2\Big)^2\Big]=2\cdot\frac{(a-b)^2}{4}=\frac{(a-b)^2}{2}.
\] Eșantioanele, în ordine lexicografică, sunt: \[
\begin{array}{l|cccccccc}
\text{eșantionul} & 2,4 & 2,5 & 2,7 & 2,9 & 2,15 & 4,5 & 4,7 & 4,9\\\hline
\bar x\rule{0pt}{2.6ex} & 3 & 3.5 & 4.5 & 5.5 & 8.5 & 4.5 & 5.5 & 6.5\\
(\bar x-7)^2 & 16 & 12.25 & 6.25 & 2.25 & 2.25 & 6.25 & 2.25 & 0.25\\
s^2 & 2 & 4.5 & 12.5 & 24.5 & 84.5 & 0.5 & 4.5 & 12.5
\end{array}
\]\[
\begin{array}{l|ccccccc}
\text{eșantionul} & 4,15 & 5,7 & 5,9 & 5,15 & 7,9 & 7,15 & 9,15\\\hline
\bar x\rule{0pt}{2.6ex} & 9.5 & 6 & 7 & 10 & 8 & 11 & 12\\
(\bar x-7)^2 & 6.25 & 1 & 0 & 9 & 1 & 16 & 25\\
s^2 & 60.5 & 2 & 8 & 50 & 2 & 32 & 18
\end{array}
\] Adunăm pe linii. Suma mediilor este \(41.5+63.5=105\), deci \(\E[\Xbar]=\frac{105}{15}=7=\mu\). Suma abaterilor pătratice este \(47.75+58.25=106\), deci \(\Var(\Xbar)=\frac{106}{15}\approx7.067\), exact valoarea din formulă. Suma valorilor \(s^2\) este \(145.5+172.5=318\), deci \(\E[S_2^2]=\frac{318}{15}=21.2\), în acord cu partea (d): în medie, \(S_2^2\) nu estimează \(\sigma^2\approx17.67\), ci \(\frac{N}{N-1}\sigma^2=21.2\).
Repartiția exactă a mediei, fără revenire. Ordonând cele \(15\) medii, obținem repartiția lui \(\Xbar\): fiecare valoare \(\bar x\) are probabilitatea egală cu numărul eșantioanelor care o produc, împărțit la \(15\). \[
\begin{array}{l|ccccccccccccc}
\bar x & 3&3.5&4.5&5.5&6&6.5&7&8&8.5&9.5&10&11&12\\\hline
\text{nr. eșantioane}\rule{0pt}{2.6ex} & 1&1&2&2&1&1&1&1&1&1&1&1&1
\end{array}
\] Media eșantionului nu este niciodată mai mică decât \(3\) sau mai mare decât \(12\), iar \(\PP(|\Xbar-7|\le1.5)=\frac{7}{15}\approx0.467\) (mediile \(5.5\), \(5.5\), \(6\), \(6.5\), \(7\), \(8\), \(8.5\)).
Enumerarea cu revenire. Cele \(36\) de perechi ordonate \((i,j)\) de indivizi sunt egal probabile. Mediile \(\frac{u_i+u_j}{2}\) formează un tablou simetric (linia: prima extragere; coloana: a doua): \[
\begin{array}{c|cccccc}
& 2 & 4 & 5 & 7 & 9 & 15\\\hline
2\rule{0pt}{2.6ex} & 2 & 3 & 3.5 & 4.5 & 5.5 & 8.5\\
4 & 3 & 4 & 4.5 & 5.5 & 6.5 & 9.5\\
5 & 3.5 & 4.5 & 5 & 6 & 7 & 10\\
7 & 4.5 & 5.5 & 6 & 7 & 8 & 11\\
9 & 5.5 & 6.5 & 7 & 8 & 9 & 12\\
15 & 8.5 & 9.5 & 10 & 11 & 12 & 15
\end{array}
\] Deasupra diagonalei se află exact cele \(15\) eșantioane fără revenire; sub diagonală ele apar a doua oară (cu ordinea extragerilor schimbată), iar pe diagonală se află cele \(6\) perechi în care același individ este extras de două ori, cu media \(u_i\) și abaterea pătratică \(d_i^2\), unde \(d_i=u_i-\mu\). Prin urmare suma celor \(36\) de abateri pătratice este \(2\cdot106+\sum_id_i^2=2\cdot106+106=318\) și \(\Var(\Xbar)=\frac{318}{36}=\frac{53}{6}\approx8.833\), din nou în acord cu formula. Aceeași sumă se obține și fără tablou: media perechii \((i,j)\) are abaterea \(\frac{u_i+u_j}{2}-\mu=\frac{d_i+d_j}{2}\) și, cum \(\sum_id_i=0\) și \(\sum_id_i^2=106\), \[
\sum_{i=1}^6\sum_{j=1}^6\Big(\frac{d_i+d_j}{2}\Big)^2=\frac14\Big(6\sum_id_i^2+6\sum_jd_j^2+2\sum_id_i\sum_jd_j\Big)=\frac{6\cdot106+6\cdot106+0}{4}=318 .
\] Numărând aparițiile fiecărei valori în tablou, obținem repartiția mediei cu revenire (probabilitatea fiecărei valori este numărul perechilor care o produc, împărțit la \(36\)): \[
\begin{array}{l|cccccccccccccccccc}
\bar x & 2&3&3.5&4&4.5&5&5.5&6&6.5&7&8&8.5&9&9.5&10&11&12&15\\\hline
\text{nr. perechi}\rule{0pt}{2.6ex} & 1&2&2&1&4&1&4&2&2&3&2&2&1&2&2&2&2&1
\end{array}
\] Față de selecția fără revenire apar valorile de pe diagonală, printre care extremele \(2\) și \(15\), iar \(\PP(|\Xbar-7|\le1.5)=\frac{4+2+2+3+2+2}{36}=\frac{15}{36}\approx0.417<0.467\): media cu revenire este mai împrăștiată. Codul de mai jos reface ambele enumerări: combn(u, 2) construiește cele \(15\) submulțimi (pe coloane), iar outer(u, u, "+") tabloul sumelor \(u_i+u_j\).
u <-c(2, 4, 5, 7, 9, 15); mu <-mean(u)E <-combn(u, 2) # cele 15 eșantioane fără revenirem_fara <-colMeans(E) # mediile lorm_cu <-as.vector(outer(u, u, "+")) /2# cele 36 de perechi ordonatec(E_medie =mean(m_fara), var_fara =mean((m_fara - mu)^2),var_cu =mean((m_cu - mu)^2), E_S2 =mean(apply(E, 2, var)))
Rezultatul afișează, în ordine, media mediilor (\(7=\mu\)), varianța mediei la selecția fără revenire (\(\frac{106}{15}\approx7.067\)), varianța mediei la selecția cu revenire (\(\frac{53}{6}\approx8.833\)) și media varianțelor de selecție (\(21.2\)): sunt valorile calculate mai sus de mână. Raportul varianțelor, \(\frac{106/15}{53/6}=\frac45\), este chiar factorul de corecție; aici fracția de selecție \(n/N=1/3\) este mare, deci câștigul selecției fără revenire (\(20\%\) din varianță) este important.
Exemplul 4(Proporții și repartiția hipergeometrică)
Fie o populație cu \(K\) indivizi „marcați” (\(u_j=1\)) și \(N-K\) nemarcați (\(u_j=0\)). Atunci \(\mu=K/N=:p\) și, cum \(u_j^2=u_j\), \(\sigma^2=\frac1N\sum_ju_j^2-\mu^2=p-p^2=p(1-p)\). Numărul \(Y=n\Xbar\) de indivizi marcați dintr-un eșantion fără revenire de volum \(n\) are repartiția hipergeometrică \(\HGeom(N,K,n)\): \[
\PP(Y=y)=\frac{\binom Ky\binom{N-K}{n-y}}{\binom Nn},
\] deoarece dintre cele \(\binom Nn\) submulțimi egal probabile, exact \(\binom Ky\binom{N-K}{n-y}\) conțin \(y\) indivizi marcați și \(n-y\) nemarcați. Din Teorema 5, \[
\E[Y]=n\mu=np,\qquad \Var(Y)=n^2\Var(\Xbar)=n^2\cdot\frac{p(1-p)}{n}\cdot\frac{N-n}{N-1}=n\,p(1-p)\,\frac{N-n}{N-1},
\] adică formulele cunoscute pentru repartiția hipergeometrică, obținute aici fără niciun calcul cu coeficienți binomiali. Prin comparație, la selecția cu revenire \(Y\sim\Bin(n,p)\) și \(\Var(Y)=np(1-p)\). De exemplu, pentru \(N=50\), \(K=15\), \(n=10\): \(p=0.3\), \(\E[Y]=3\) și \(\Var(Y)=10\cdot0.21\cdot\frac{40}{49}\approx1.714\), față de \(2.1\) la binomială.
Un caz calculat de mână. Într-o grupă de \(N=8\) studenți, \(K=3\) au permis de conducere; alegem fără revenire \(n=4\) studenți și notăm cu \(Y\) numărul celor cu permis din eșantion. Sunt \(\binom84=\frac{8\cdot7\cdot6\cdot5}{4\cdot3\cdot2\cdot1}=70\) de eșantioane egal probabile. Un eșantion cu \(y\) posesori de permis se formează alegând \(y\) dintre cei \(3\) și \(4-y\) dintre ceilalți \(5\): \[
\begin{array}{l|cccc}
y & 0 & 1 & 2 & 3\\\hline
\binom3y\rule{0pt}{2.8ex} & 1 & 3 & 3 & 1\\[2pt]
\binom5{4-y} & \binom54=5 & \binom53=10 & \binom52=10 & \binom51=5\\[2pt]
\text{numărul eșantioanelor} & 5 & 30 & 30 & 5\\[2pt]
\PP(Y=y) & \frac{5}{70}\approx0.071 & \frac{30}{70}\approx0.429 & \frac{30}{70}\approx0.429 & \frac{5}{70}\approx0.071
\end{array}
\] Verificare: \(5+30+30+5=70\). Valoarea \(y=4\) este imposibilă, fiindcă populația conține doar trei indivizi marcați. Media și varianța, calculate direct din tabel, sunt \[
\begin{aligned}
\E[Y]&=\frac{0\cdot5+1\cdot30+2\cdot30+3\cdot5}{70}=\frac{105}{70}=1.5,\\
\E[Y^2]&=\frac{0\cdot5+1\cdot30+4\cdot30+9\cdot5}{70}=\frac{195}{70}=\frac{39}{14},
\end{aligned}
\] deci \(\Var(Y)=\frac{39}{14}-\frac94=\frac{78-63}{28}=\frac{15}{28}\approx0.536\). Formulele generale dau același lucru, fără enumerare: cu \(p=\frac38\), \(\E[Y]=np=4\cdot\frac38=1.5\) și \[
\Var(Y)=n\,p(1-p)\,\frac{N-n}{N-1}=4\cdot\frac38\cdot\frac58\cdot\frac{8-4}{8-1}=\frac{15}{16}\cdot\frac47=\frac{15}{28}.
\] La selecția cu revenire am avea \(Y\sim\Bin\big(4,\frac38\big)\), cu aceeași medie \(1.5\), dar cu varianța \(\frac{15}{16}\approx0.94\) și cu probabilitățile \(0.153,\ 0.366,\ 0.330,\ 0.132,\ 0.020\) pentru \(y=0,1,2,3,4\): repartiția hipergeometrică este mai strânsă în jurul mediei și nu permite valoarea \(4\). Fracția de selecție fiind aici \(f=\frac12\), factorul de corecție \(\frac47\) aproape înjumătățește varianța.
Populații mari. Pentru \(n\) și \(y\) fixați, scriind coeficienții binomiali ca produse (\(\binom Ky=\frac1{y!}\prod_{i=0}^{y-1}(K-i)\) și analoagele), \[
\PP(Y=y)=\binom ny\,\frac{\prod_{i=0}^{y-1}(K-i)\ \prod_{i=0}^{n-y-1}(N-K-i)}{\prod_{i=0}^{n-1}(N-i)}
=\binom ny\ \prod_{i=0}^{y-1}\frac{K-i}{N-i}\ \prod_{i=0}^{n-y-1}\frac{N-K-i}{N-y-i} .
\] Dacă \(N\to\infty\) și \(K/N\to p\in(0,1)\), fiecare factor al primului produs tinde la \(p\), iar fiecare factor al celui de-al doilea produs tinde la \(1-p\), deci \(\PP(Y=y)\to\binom nyp^y(1-p)^{n-y}\). Pentru o populație mare în raport cu eșantionul, repartiția hipergeometrică este deci practic binomială: selecția fără revenire nu se mai distinge de cea cu revenire, nu doar la nivelul varianței, ci și al repartiției.
Exemplul 5(Indivizi repetați la selecția cu revenire)
De ce este selecția cu revenire mai puțin precisă? Pentru că același individ poate fi extras de mai multe ori, iar o valoare repetată nu aduce nicio informație nouă. Fie o populație de \(N\) indivizi și un eșantion de volum \(n\).
Probabilitatea ca un individ fixat \(j\) să apară în eșantion. Fără revenire, evenimentele \(\{J_1=j\},\dots,\{J_n=j\}\) sunt disjuncte două câte două (indicii extrași sunt distincți) și fiecare are probabilitatea \(\frac1N\) (Teorema 5(a)), deci probabilitatea căutată este \(\frac nN\), fracția de selecție. Cu revenire, individul \(j\)nu apare dacă și numai dacă \(J_i\ne j\) pentru fiecare dintre cele \(n\) extrageri; extragerile sunt independente (Propoziția 4) și \(\PP(J_i\ne j)=1-\frac1N\), deci \[
\PP(j\text{ nu apare})=\prod_{i=1}^n\PP(J_i\ne j)=\Big(1-\frac1N\Big)^n,\qquad \PP(j\text{ apare})=1-\Big(1-\frac1N\Big)^n .
\]
Numărul mediu de indivizi distincți din eșantionul cu revenire. Fie \(I_j'\) indicatorul evenimentului „individul \(j\) apare cel puțin o dată în eșantion”. Numărul indivizilor distincți este \(D=\sum_{j=1}^NI_j'\), iar din liniaritatea mediei (care nu cere independența indicatorilor) și din (a), \[
\E[D]=\sum_{j=1}^N\PP(I_j'=1)=N\Big(1-\Big(1-\frac1N\Big)^n\Big).
\]
Numeric, pentru \(N=1\,000\) și \(n=100\): fără revenire, probabilitatea de la (a) este \(\frac{100}{1000}=0.1\); cu revenire, \(0.999^{100}=e^{100\ln0.999}\approx e^{-0.10005}\approx0.9048\), deci probabilitatea este \(\approx0.0952\), iar \(\E[D]\approx1000\cdot0.0952=95.2\): în medie, aproape \(5\) dintre cele \(100\) de extrageri repetă un individ deja extras.
Formulele din Propoziția 4 și din Teorema 5 sunt exacte, deci pot fi verificate prin simulare pe o populație artificială, în care cunoaștem toate valorile. Construim o populație de \(N=200\) de „venituri” (în mii de lei, cu o repartiție asimetrică la dreapta) și extragem de \(B=10^4\) ori câte un eșantion de volum \(n=50\) (fracția de selecție este \(f=0.25\)), cu și fără revenire; pentru fiecare eșantion reținem media și varianța \(S_n^2\).
set.seed(2026)N <-200; n <-50; B <-1e4; fpc <- (N - n) / (N -1)u <-round(rgamma(N, shape =2, rate =1/1.5), 2) # populația (fixată)mu <-mean(u); sig2 <-mean((u - mu)^2) # media și varianța eistat <-function(x) c(mean(x), var(x)) # media și S^2cu <-replicate(B, stat(sample(u, n, replace =TRUE)))fara <-replicate(B, stat(sample(u, n)))rez <-function(m) c(E_medie =mean(m[1, ]), sd_medie =sd(m[1, ]),E_S2 =mean(m[2, ]))round(rbind(cu_simulat =rez(cu), cu_teoretic =c(mu, sqrt(sig2 / n), sig2),fara_simulat =rez(fara),fara_teoretic =c(mu, sqrt(sig2 / n * fpc), sig2 * N / (N -1))), 3)
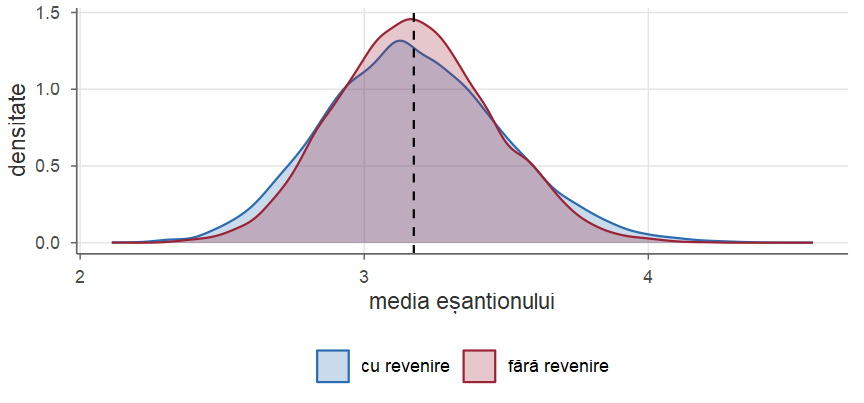
Ambele medii de selecție sunt centrate în \(\mu\approx3.175\), iar valorile simulate concordă cu cele teoretice. Abaterea standard a mediei scade de la \(\sigma/\sqrt n\approx0.314\) (cu revenire) la \(\approx0.273\) (fără revenire): raportul lor este \(\sqrt{(N-n)/(N-1)}=\sqrt{150/199}\approx0.868\), rădăcina factorului de corecție. Media lui \(S_n^2\) este \(\sigma^2\approx4.933\) la selecția cu revenire (Propoziția 4) și \(\frac{N}{N-1}\sigma^2\approx4.957\) la cea fără revenire (partea (d) a teoremei); valorile simulate le reproduc cu erori de ordinul \(10^{-2}\), cât eroarea de simulare. Figura 1 compară repartițiile celor două medii de selecție.
Arată codul R
dd <-data.frame(medie =c(cu[1, ], fara[1, ]),plan =rep(c("cu revenire", "fără revenire"), each = B))ggplot(dd, aes(medie, colour = plan, fill = plan)) +geom_density(alpha =0.25) +# densitățile estimategeom_vline(xintercept = mu, linetype =2) +# media populațieilabs(x ="media eșantionului", y ="densitate", colour =NULL, fill =NULL)
Figura 1: Repartiția mediei eșantionului (\(n=50\), \(10^4\) repetări) la selecția simplă cu revenire și fără revenire dintr-o populație de \(N=200\) de valori. Ambele repartiții sunt centrate în media populației (linia întreruptă); cea fără revenire este mai concentrată: abaterea ei standard este cea de la selecția cu revenire înmulțită cu \(\sqrt{(N-n)/(N-1)}\approx0.87\).
2.3 Alte planuri de selecție
Selecția simplă tratează toți indivizii la fel. Atunci când avem informații suplimentare despre populație (o împărțire în categorii, o listă ordonată), le putem folosi pentru a obține estimatori mai preciși sau mai ieftini. Menționăm aici, fără demonstrații, cele mai folosite planuri; pentru detalii, vezi (Rice 2007, cap. 7).
Selecția stratificată. Populația este împărțită în \(H\) grupuri disjuncte, numite straturi (regiuni, categorii de vârstă, mediul urban și mediul rural), de volume \(N_h\) și ponderi \(W_h=N_h/N\), pe cât posibil omogene în interior. Din fiecare strat se extrage, independent de celelalte straturi, o selecție simplă de volum \(n_h\), cu media \(\bar X_h\), iar media populației se estimează prin estimatorul stratificat\(\bar X_{st}=\sum_{h=1}^HW_h\bar X_h\), care este nedeplasat. Fiecare strat este sigur reprezentat în eșantion, iar la varianța estimatorului contribuie numai variabilitatea din interiorul straturilor, nu și diferențele dintre mediile straturilor; stratificarea este deci cu atât mai utilă cu cât straturile diferă mai mult între ele. Împărțirea volumului total \(n=n_1+\dots+n_H\) între straturi se numește alocare. La alocarea proporțională, volumul extras din fiecare strat este proporțional cu ponderea stratului; dacă neglijăm factorii de corecție pentru populație finită, estimatorul stratificat este atunci cel puțin la fel de precis ca media unei selecții simple de același volum. Alocarea Neyman (sau alocarea optimă) este cea care minimizează varianța estimatorului pentru un volum total dat: ea trimite mai multe observații în straturile mari și în cele cu variabilitate mare.
Selecția sistematică. Indivizii sunt așezați într-o listă, se alege la întâmplare un punct de plecare printre primii \(k\) indivizi și apoi se ia fiecare al \(k\)-lea individ din listă. Planul cere o singură tragere la sorți și este foarte ușor de aplicat; el este precis atunci când lista este ordonată după o mărime legată de cea studiată și poate fi foarte imprecis atunci când lista are o periodicitate legată de pasul \(k\).
Selecția pe grupuri. Populația este împărțită în grupuri (blocuri de locuințe, școli, loturi), se aleg la întâmplare câteva grupuri și se observă toți indivizii din grupurile alese. Planul este ieftin, deoarece cere doar lista grupurilor, nu și pe cea a indivizilor; în schimb, la același număr de observații, este de regulă mai puțin precis decât selecția simplă, fiindcă indivizii din același grup seamănă între ei.
În restul semestrului vom presupune, cu excepția mențiunilor explicite, că eșantioanele sunt i.i.d., adică provin dintr-o selecție simplă cu revenire sau dintr-o populație „infinită” (fracție de selecție neglijabilă). Rămâne întrebarea teoretică: există șiruri infinite de v.a. i.i.d. cu o repartiție dată? Pentru a răspunde, avem nevoie mai întâi de un instrument care să transforme o variabilă uniformă într-o variabilă cu o repartiție oarecare.
3 Funcția cuantilă
Fie \(X\) o variabilă aleatoare cu funcția de repartiție \(F(x)=\PP(X\le x)\). Reamintim că \(F\) este crescătoare, continuă la dreapta și are limitele \(0\) la \(-\infty\) și \(1\) la \(+\infty\) (proprietățile (a)–(c) din recapitulare). Mai general, orice probabilitate \(\mu\) pe \(\big(\R,\B(\R)\big)\) are o funcție de repartiție, \(F(x)=\mu\big((-\infty,x]\big)\), numită funcția de repartiție indusă de \(\mu\): este funcția de repartiție a variabilei aleatoare \(X(x)=x\) pe câmpul \(\big(\R,\B(\R),\mu\big)\), deci are aceleași proprietăți.
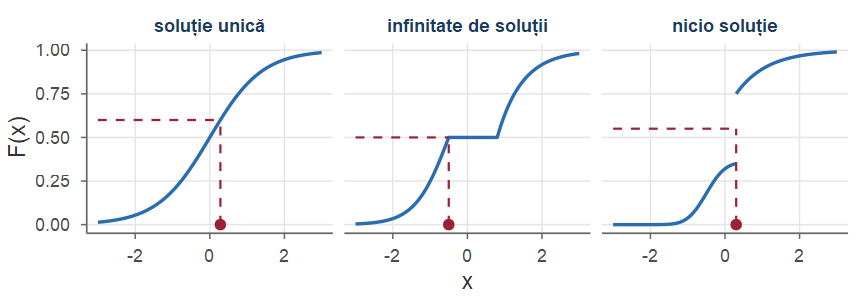
Dacă \(F\) este continuă și strict crescătoare, ecuația \(F(x)=u\) are, pentru orice \(u\in(0,1)\), o soluție unică \(x=F^{-1}(u)\), iar inversa \(F^{-1}\) „transportă” nivelurile de probabilitate în valori ale variabilei. Pentru a construi (și, în Cursul 4, pentru a simula) variabile cu o repartiție oarecare, avem nevoie de o astfel de inversă pentru orice funcție de repartiție. În general însă ecuația \(F(x)=u\) poate avea o infinitate de soluții (când \(F\) are un palier la nivelul \(u\)) sau nicio soluție (când \(F\) sare peste nivelul \(u\)), ca în Figura 2. Definiția următoare alege, în toate cazurile, „cea mai mică soluție a inecuației \(F(x)\ge u\)” (Panaretos 2016, Def. 6.6).
Fie \(F\) o funcție de repartiție. Funcția \(F^{-1}:(0,1)\to\R\), \[
F^{-1}(u)=\inf\{x\in\R:\ F(x)\ge u\},\qquad u\in(0,1),
\] se numește funcția cuantilă (sau inversa generalizată) asociată lui \(F\). Pentru \(p\in(0,1)\), numărul \(q_p=F^{-1}(p)\) se numește cuantila de ordin \(p\) a repartiției. Cuantila de ordin \(\frac12\) este mediana, \(\mathrm{Me}=q_{1/2}\); \(Q_1=q_{1/4}\) și \(Q_3=q_{3/4}\) sunt prima și a treia cuartilă, iar \(Q_3-Q_1\) este abaterea intercuartilică.
Faptul că infimumul este un număr real (și nu \(\pm\infty\)) face parte din lema de mai jos. Pentru \(u=0\) mulțimea \(\{x:F(x)\ge0\}\) este \(\R\), cu infimumul \(-\infty\), iar pentru \(u=1\) ea poate fi vidă (de exemplu pentru \(F=\Phi\)); de aceea restrângem definiția la \(u\in(0,1)\).
Arată codul R
xx <-seq(-3, 3, length.out =601)cazuri <-c("soluție unică", "infinitate de soluții", "nicio soluție")F2 <-ifelse(xx <-0.5, plogis(xx +0.5, 0, 0.45), # palier la 0.5ifelse(xx <=0.8, 0.5, 1-0.5*exp(-1.5* (xx -0.8))))F3 <-ifelse(xx <0.3, 0.35*pnorm(xx, -0.5, 0.4) /pnorm(0.3, -0.5, 0.4),0.75+0.25* (1-exp(-1.2* (xx -0.3)))) # salt în 0.3d <-data.frame(x = xx, F =c(plogis(xx, 0, 0.7), F2, F3),caz =factor(rep(cazuri, each =601), levels = cazuri),ramura =c(rep(1, 1202), (xx >=0.3) +1)) # ramurile lui F3dq <-data.frame(caz =factor(cazuri, levels = cazuri), # nivelul uu =c(0.6, 0.5, 0.55), q =c(qlogis(0.6, 0, 0.7), -0.5, 0.3))ggplot(d, aes(x, F)) +geom_line(aes(group = ramura)) +geom_segment(data = dq, aes(x =-3, xend = q, y = u, yend = u),linetype =2, colour = culori[["rosu"]]) +geom_segment(data = dq, aes(x = q, xend = q, y =0, yend = u),linetype =2, colour = culori[["rosu"]]) +geom_point(data = dq, aes(q, 0), colour = culori[["rosu"]], size =2) +facet_wrap(~ caz) +labs(x ="x", y ="F(x)")
Figura 2: Cele trei situații posibile pentru ecuația \(F(x)=u\): soluție unică (stânga), un palier la nivelul \(u\) (mijloc; \(F^{-1}(u)\) este capătul din stânga al palierului) și un salt peste nivelul \(u\) (dreapta; \(F^{-1}(u)\) este punctul de salt). Punctul roșu marchează \(F^{-1}(u)\).
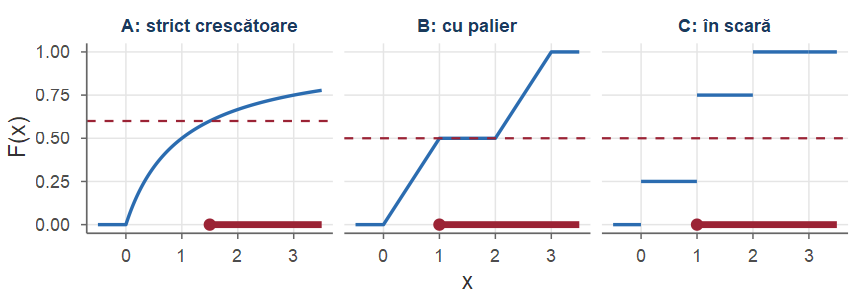
Cum se calculează cu definiția. Pentru a găsi \(F^{-1}(u)\) parcurgem întotdeauna aceiași trei pași: (1) fixăm nivelul \(u\in(0,1)\); (2) determinăm mulțimea \(I_u=\{x\in\R:\ F(x)\ge u\}\) a punctelor în care \(F\) a atins sau a depășit nivelul \(u\), adică rezolvăm o inecuație, nu ecuația \(F(x)=u\); (3) luăm cel mai mic element al acestei mulțimi (vom demonstra în Lema 8 că el există întotdeauna). Exemplul următor face acest calcul, pas cu pas, pentru câte o funcție de repartiție din fiecare dintre cele trei situații; funcțiile sunt desenate în Figura 3.
Arată codul R
FA <-function(x) pmax(x, 0) / (1+pmax(x, 0)) # x/(1+x), x >= 0FB <-function(x) ifelse(x <0, 0, ifelse(x <1, x /2, # palier pe [1, 2)ifelse(x <2, 0.5, ifelse(x <3, (x -1) /2, 1))))FC <-function(x) 0.25* (x >=0) +0.5* (x >=1) +0.25* (x >=2)xg <-seq(-0.5, 3.5, by =0.002)tip <-c("A: strict crescătoare", "B: cu palier", "C: în scară")dt <-data.frame(x = xg, F =c(FA(xg), FB(xg), FC(xg)),tip =factor(rep(tip, each =length(xg)), levels = tip),ram =c(rep(0, 2*length(xg)), floor(xg))) # trepteledi <-data.frame(tip =factor(tip, levels = tip), # u și F^{-1}(u)u =c(0.6, 0.5, 0.5), q =c(1.5, 1, 1))ggplot(dt, aes(x, F)) +geom_line(aes(group = ram)) +geom_hline(data = di, aes(yintercept = u), linetype =2,colour = culori[["rosu"]]) +geom_segment(data = di, aes(x = q, xend =3.5, y =0, yend =0),colour = culori[["rosu"]], linewidth =1.6) +# mulțimea I_ugeom_point(data = di, aes(q, 0), colour = culori[["rosu"]], size =2.2) +facet_wrap(~ tip) +labs(x ="x", y ="F(x)")
Figura 3: Funcțiile de repartiție din exemplul de mai jos: \(F_A\) continuă și strict crescătoare pe \((0,\infty)\), \(F_B\) continuă, cu un palier la nivelul \(\frac12\), și \(F_C\) în scară. Linia întreruptă marchează nivelul \(u\) (\(0.6\), \(0.5\), respectiv \(0.5\)); segmentul roșu de pe axă este mulțimea \(I_u=\{x:F(x)\ge u\}\), iar capătul ei din stânga (punctul roșu) este \(F^{-1}(u)\).
Exemplul 6(Calculul funcției cuantilă direct din definiție)
\(F\) continuă și strict crescătoare: soluție unică. Fie \(F_A(x)=0\) pentru \(x<0\) și \(F_A(x)=\frac{x}{1+x}\) pentru \(x\ge0\) (funcția de repartiție a unei v.a. cu densitatea \(\frac{1}{(1+x)^2}\) pe \((0,\infty)\)). Luăm \(u=0.6\) și căutăm toate punctele \(x\) cu \(F_A(x)\ge0.6\), pe fiecare ramură: pentru \(x<0\), \(F_A(x)=0<0.6\), deci niciun astfel de punct nu convine; pentru \(x\ge0\), înmulțind cu \(1+x>0\), \(\frac{x}{1+x}\ge0.6\iff x\ge0.6+0.6x\iff0.4x\ge0.6\iff x\ge1.5\). Așadar \[
I_{0.6}=[1.5,\infty),\qquad F_A^{-1}(0.6)=\inf I_{0.6}=1.5,
\] adică exact soluția ecuației \(\frac{x}{1+x}=0.6\). Același calcul pentru un nivel oarecare \(u\in(0,1)\): pentru \(x\ge0\), \(\frac{x}{1+x}\ge u\iff x\ge u+ux\iff(1-u)x\ge u\iff x\ge\frac{u}{1-u}\) (am împărțit la \(1-u>0\)), deci \(I_u=\big[\frac{u}{1-u},\infty\big)\) și \(F_A^{-1}(u)=\frac{u}{1-u}\), inversa obișnuită a bijecției \(x\mapsto\frac{x}{1+x}\) de la \((0,\infty)\) la \((0,1)\).
\(F\) continuă, cu un palier: o infinitate de soluții. Fie \(X\) uniformă pe reuniunea \((0,1)\cup(2,3)\), adică având densitatea \(\frac12\) pe fiecare dintre cele două intervale. Funcția ei de repartiție este \[
F_B(x)=\begin{cases}0, & x<0,\\ x/2, & 0\le x<1,\\ 1/2, & 1\le x<2,\\ (x-1)/2, & 2\le x<3,\\ 1, & x\ge3:\end{cases}
\] cum \(X\) nu ia valori în \((1,2)\), \(F_B\) nu crește pe acest interval. Pentru \(u=\frac12\), ecuația \(F_B(x)=\frac12\) are ca soluții toate punctele intervalului \([1,2]\). Rezolvăm inecuația \(F_B(x)\ge\frac12\): pe \([0,1)\), \(\frac x2\ge\frac12\iff x\ge1\), imposibil; pe \([1,2)\) avem egalitate, deci toate punctele convin; pe \([2,3)\), \(\frac{x-1}{2}\ge\frac12\iff x\ge2\), adevărat; pentru \(x\ge3\), \(F_B(x)=1\). Deci \(I_{1/2}=[1,\infty)\) și \(F_B^{-1}\big(\frac12\big)=1\), capătul din stânga al palierului. Pentru un nivel de sub palier, de exemplu \(u=0.3\): pe \([0,1)\), \(\frac x2\ge0.3\iff x\ge0.6\), iar toate punctele \(x\ge1\) convin; deci \(I_{0.3}=[0.6,\infty)\) și \(F_B^{-1}(0.3)=0.6\). Pentru un nivel de deasupra palierului, de exemplu \(u=0.8\): pentru \(x<2\) avem \(F_B(x)\le\frac12<0.8\); pe \([2,3)\), \(\frac{x-1}2\ge0.8\iff x\ge2.6\); deci \(I_{0.8}=[2.6,\infty)\) și \(F_B^{-1}(0.8)=2.6\). În general, \[
F_B^{-1}(u)=\begin{cases}2u, & 0<u\le\frac12,\\ 2u+1, & \frac12<u<1.\end{cases}
\] În \(u=\frac12\) funcția cuantilă sare de la \(1\) la \(\lim_{u\searrow1/2}(2u+1)=2\): niciun număr din \((1,2]\) nu este o cuantilă, ceea ce este firesc, deoarece \(X\) nu ia valori în \((1,2)\).
\(F\) cu salturi: nicio soluție. Fie \(X\) numărul de steme obținute la două aruncări ale unei monede echilibrate: \(\PP(X=0)=\frac14\), \(\PP(X=1)=\frac12\), \(\PP(X=2)=\frac14\). Funcția de repartiție este în scară: \(F_C(x)=0\) pentru \(x<0\), \(F_C(x)=\frac14\) pentru \(0\le x<1\), \(F_C(x)=\frac34\) pentru \(1\le x<2\) și \(F_C(x)=1\) pentru \(x\ge2\). Pentru \(u=0.5\), ecuația \(F_C(x)=0.5\) nu are nicio soluție (\(F_C\) ia doar valorile \(0,\frac14,\frac34,1\)). Inecuația are însă soluții: pentru \(x<1\), \(F_C(x)\le\frac14<0.5\); pentru \(x\ge1\), \(F_C(x)\ge\frac34\ge0.5\). Deci \(I_{0.5}=[1,\infty)\) și \(F_C^{-1}(0.5)=1\), punctul în care \(F_C\) sare peste nivelul \(0.5\). La fel: \[
\begin{array}{l|cccc}
u & 0.25 & 0.26 & 0.75 & 0.9\\\hline
I_u=\{x:\ F_C(x)\ge u\}\rule{0pt}{2.6ex} & [0,\infty) & [1,\infty) & [1,\infty) & [2,\infty)\\
F_C^{-1}(u) & 0 & 1 & 1 & 2
\end{array}
\] Nivelul \(u=0.25\) este atins exact pe treapta \([0,1)\), iar cuantila este capătul ei din stânga; o creștere oricât de mică a nivelului peste \(\frac14\) mută cuantila de la \(0\) la \(1\). În general, \(F_C^{-1}(u)=0\) pentru \(0<u\le\frac14\), \(F_C^{-1}(u)=1\) pentru \(\frac14<u\le\frac34\) și \(F_C^{-1}(u)=2\) pentru \(\frac34<u<1\).
Ce am aflat. În toate cazurile, mulțimea \(I_u\) a fost o semidreaptă închisă\([a,\infty)\), iar \(F^{-1}(u)\) capătul ei. Acesta este conținutul lemei care urmează.
Rezultatul-cheie al secțiunii este următoarea echivalență, care permite „inversarea” inegalităților ce conțin \(F^{-1}\), chiar dacă \(F\) nu este bijectivă. Ea spune că a compara cuantila \(F^{-1}(u)\) cu un prag \(x\) este același lucru cu a compara nivelul \(u\) cu \(F(x)\). De exemplu, pentru \(F_C\) din Exemplul 6 și \(u=0.5\) avem \(F_C^{-1}(0.5)=1\): pentru \(x=1.3\) ambele inegalități, \(1\le1.3\) și \(0.5\le F_C(1.3)=0.75\), sunt adevărate, iar pentru \(x=0.4\) ambele, \(1\le0.4\) și \(0.5\le F_C(0.4)=0.25\), sunt false.
Lema 8(Lema fundamentală a funcției cuantilă)
Fie \(F\) o funcție de repartiție. Pentru orice \(u\in(0,1)\) și orice \(x\in\R\), \[
F^{-1}(u)\le x\quad\Longleftrightarrow\quad u\le F(x).
\tag{3}\] Echivalent, \(\{x\in\R:\ F(x)\ge u\}=\big[F^{-1}(u),\infty\big)\), cu \(F^{-1}(u)\in\R\): infimumul din definiție este atins.
Demonstrație.Ideea demonstrației. Arătăm că mulțimea \(I_u=\{x\in\R:\ F(x)\ge u\}\), al cărei infimum este \(F^{-1}(u)\), este o semidreaptă închisă\([a,\infty)\) cu \(a\in\R\); echivalența cerută este atunci doar o reformulare a apartenenței la această semidreaptă. Fiecare dintre proprietățile (a)–(c) ale funcției de repartiție (recapitulare; Propoziția 14 din Cursul 1) este folosită exact o dată.
Fixăm \(u\in(0,1)\).
Pasul 1: \(I_u\) este nevidă (folosim \(\lim_{x\to\infty}F(x)=1\) și \(u<1\)). Cum \(F(x)\to1\) pentru \(x\to\infty\) și \(1-u>0\), există \(x_0\) astfel încât \(F(x)>1-(1-u)=u\) pentru orice \(x\ge x_0\); în particular \(x_0\in I_u\).
Pasul 2: \(I_u\) este un interval nemărginit la dreapta (folosim monotonia lui \(F\)). Dacă \(x\in I_u\) și \(y>x\), atunci \(F(y)\ge F(x)\ge u\), deci \(y\in I_u\). Așadar \([x,\infty)\subseteq I_u\) pentru orice \(x\in I_u\).
Pasul 3: \(I_u\) nu este toată dreapta reală, ci este mărginită inferior (folosim \(\lim_{x\to-\infty}F(x)=0\) și \(u>0\)). Cum \(F(x)\to0\) pentru \(x\to-\infty\) și \(u>0\), există \(x_1\) cu \(F(x)<u\) pentru orice \(x\le x_1\). Atunci \(I_u\subseteq(x_1,\infty)\), deci \(x_1\) este un minorant al lui \(I_u\). Împreună cu Pasul 1, rezultă că \(a:=\inf I_u\) este un număr real. Din Pasul 2, \[
(a,\infty)\subseteq\bigcup_{x\in I_u}[x,\infty)\subseteq I_u\subseteq[a,\infty).
\] Prima incluziune: dacă \(y>a=\inf I_u\), atunci \(y\) nu este un minorant al lui \(I_u\), deci există \(x\in I_u\) cu \(x<y\), adică \(y\in[x,\infty)\). Ultima incluziune: \(a\) este un minorant al lui \(I_u\). Deci \(I_u\) este fie \((a,\infty)\), fie \([a,\infty)\), iar singura întrebare rămasă este dacă \(a\) aparține lui \(I_u\).
Pasul 4: \(I_u\) este un interval închis, adică \(a\in I_u\) (folosim continuitatea la dreapta a lui \(F\)). Fie \(x_n=a+\frac1n\), \(n\ge1\). Din Pasul 3, \(x_n\in(a,\infty)\subseteq I_u\), adică \(F(x_n)\ge u\) pentru orice \(n\). Cum \(x_n\searrow a\), continuitatea la dreapta a lui \(F\) în \(a\) dă \[
F(a)=\lim_{n\to\infty}F\Big(a+\frac1n\Big)\ge u ,
\] deci \(a\in I_u\) și \(I_u=[a,\infty)\).
Concluzia.\(a=\inf I_u=F^{-1}(u)\) și, pentru orice \(x\in\R\), \(u\le F(x)\iff x\in I_u\iff x\ge a=F^{-1}(u)\), adică (3).■
Observație
Fiecare ingredient contează. Fără continuitatea la dreapta (Pasul 4), infimumul nu ar mai fi atins. Dacă am folosi inegalitatea strictă, \(u\mapsto\inf\{x:F(x)>u\}\), am obține o funcție diferită de \(F^{-1}\) la nivelurile palierelor lui \(F\): pentru \(X\sim\Bern(1/2)\), \(\inf\{x:F(x)>\frac12\}=1\ne F^{-1}(\frac12)=0\), iar echivalența (3) ar cădea (\(\frac12\le F(0)\), dar \(1>0\)).
Din lemă obținem toate proprietățile funcției cuantilă. Le grupăm într-o propoziție la care vom face trimitere în cursurile următoare (metoda inversă, statisticile de ordine, cuantilele empirice, teorema Glivenko–Cantelli).
Propoziția 9(Proprietățile funcției cuantilă)
Fie \(F\) o funcție de repartiție și \(F^{-1}\) funcția cuantilă asociată. Atunci:
\(F^{-1}(u)\in\R\) pentru orice \(u\in(0,1)\), iar \(F^{-1}\) este crescătoare (nedescrescătoare) și boreliană pe \((0,1)\);
\(F\big(F^{-1}(u)\big)\ge u\) și \(F\big(F^{-1}(u)-\big)\le u\) pentru orice \(u\in(0,1)\); în particular, dacă \(F\) este continuă în \(F^{-1}(u)\) (de exemplu, dacă \(F\) este continuă), atunci \(F\big(F^{-1}(u)\big)=u\);
\(F^{-1}\big(F(x)\big)\le x\) pentru orice \(x\) cu \(0<F(x)<1\), cu egalitate dacă și numai dacă \(F(x')<F(x)\) pentru orice \(x'<x\);
\(F^{-1}\) este continuă la stânga pe \((0,1)\);
\(F(x)<u\iff x<F^{-1}(u)\), pentru orice \(u\in(0,1)\) și \(x\in\R\);
dacă \(F\) este continuă și strict crescătoare pe un interval \((a,b)\) (\(-\infty\le a<b\le\infty\)), cu \(F(a+)=0\) și \(F(b-)=1\), atunci \(F^{-1}\) este inversa obișnuită a bijecției \(F:(a,b)\to(0,1)\).
Demonstrație.Ideea demonstrației. Toate punctele sunt consecințe ale Lemei 8, aplicată pentru alegeri potrivite ale lui \(u\) și \(x\): echivalența \(F^{-1}(u)\le x\iff u\le F(x)\) transformă fiecare afirmație despre \(F^{-1}\) într-o afirmație despre \(F\). Păstrăm notația \(I_u=\{x\in\R:\ F(x)\ge u\}=[F^{-1}(u),\infty)\).
1. Finitudinea, monotonia, măsurabilitatea. Finitudinea este parte a lemei. Fie \(0<u\le v<1\). Dacă \(F(x)\ge v\), atunci \(F(x)\ge u\), deci \(I_v\subseteq I_u\); infimumul unei submulțimi este mai mare sau egal cu infimumul mulțimii, deci \(F^{-1}(u)=\inf I_u\le\inf I_v=F^{-1}(v)\). Pentru măsurabilitate, fie \(x\in\R\); din lemă, \[
\{u\in(0,1):\ F^{-1}(u)\le x\}=\{u\in(0,1):\ u\le F(x)\}=(0,F(x)]\cap(0,1),
\] un interval, deci o mulțime boreliană. O funcție \(h\) cu \(\{h\le x\}\) boreliană pentru orice \(x\) este boreliană (criteriul de măsurabilitate cu semidrepte din Cursul 1, aplicat pe \(\big((0,1),\B((0,1))\big)\)).
2. \(F(F^{-1}(u))\ge u\) și \(F(F^{-1}(u)-)\le u\). Aplicăm lema cu \(x=F^{-1}(u)\): inegalitatea \(F^{-1}(u)\le F^{-1}(u)\) fiind adevărată, rezultă \(u\le F(F^{-1}(u))\). Fie acum \(q=F^{-1}(u)\) și \(x<q\); inegalitatea \(F^{-1}(u)\le x\) este falsă, deci, din lemă, și \(u\le F(x)\) este falsă, adică \(F(x)<u\). Trecând la limită pe \(x_n=q-\frac1n\nearrow q\) (limita la stânga există, \(F\) fiind monotonă), \(F(q-)=\lim_nF(q-\frac1n)\le u\). Dacă \(F\) este continuă în \(q\), atunci \(F(q)=F(q-)\), iar cele două inegalități dau \(F(q)=u\).
3. \(F^{-1}(F(x))\le x\). Fie \(x\) cu \(0<F(x)<1\), astfel încât \(u=F(x)\) este un argument admisibil pentru \(F^{-1}\). Cum \(u\le F(x)\) este adevărată, lema dă \(F^{-1}(u)\le x\), adică \(F^{-1}(F(x))\le x\). Dacă există \(x'<x\) cu \(F(x')=F(x)\), atunci \(x'\in I_{F(x)}\) și \(F^{-1}(F(x))\le x'<x\): inegalitatea este strictă. Dacă \(F(x')<F(x)\) pentru orice \(x'<x\), atunci niciun \(x'<x\) nu aparține lui \(I_{F(x)}\), deci \(I_{F(x)}\subseteq[x,\infty)\) și \(F^{-1}(F(x))=\inf I_{F(x)}\ge x\); împreună cu prima inegalitate, \(F^{-1}(F(x))=x\).
4. Continuitatea la stânga. Fie \(u\in(0,1)\) și un șir \(u_n\nearrow u\), \(u_n\in(0,1)\). Din punctul 1, șirul \(\big(F^{-1}(u_n)\big)_n\) este crescător și majorat de \(F^{-1}(u)\), deci are o limită \(\ell=\lim_nF^{-1}(u_n)\le F^{-1}(u)\). Pentru inegalitatea inversă, fixăm \(m\); cum \(F^{-1}(u_m)\le\ell\), monotonia lui \(F\) și punctul 2 dau \[
F(\ell)\ge F\big(F^{-1}(u_m)\big)\ge u_m .
\] Făcând \(m\to\infty\) obținem \(F(\ell)\ge\lim_mu_m=u\), iar lema (cu \(x=\ell\)) dă \(F^{-1}(u)\le\ell\). Așadar \(\lim_nF^{-1}(u_n)=F^{-1}(u)\) pentru orice șir \(u_n\nearrow u\). Aceasta este continuitatea la stânga în \(u\): \(F^{-1}\) fiind crescătoare, limita ei la stânga în \(u\) există (este \(\sup_{v<u}F^{-1}(v)\)) și coincide cu limita pe orice șir strict crescător către \(u\), de exemplu \(u_n=u\big(1-\frac1{n+1}\big)\), pentru care am arătat că limita este \(F^{-1}(u)\).
5. Forma strictă. Negând ambii membri ai echivalenței (3), \(\neg\big(F^{-1}(u)\le x\big)\iff\neg\big(u\le F(x)\big)\), adică \(x<F^{-1}(u)\iff F(x)<u\).
6. Cazul strict crescător. Arătăm întâi că \(F:(a,b)\to(0,1)\) este bijectivă. Valorile sunt în \((0,1)\): dacă am avea \(F(x_0)=0\) pentru un \(x_0\in(a,b)\), atunci, pentru \(x\in(a,x_0)\), stricta monotonie ar da \(F(x)<F(x_0)=0\), imposibil; la fel, \(F(x_0)=1\) ar da \(F(x)>1\) pentru \(x\in(x_0,b)\). Injectivitatea rezultă din stricta monotonie. Surjectivitatea: fie \(u\in(0,1)\). Cum \(F(a+)=0<u\) și \(F(b-)=1>u\), există \(x'<x''\) în \((a,b)\) cu \(F(x')<u<F(x'')\); \(F\) fiind continuă pe \([x',x'']\), teorema valorilor intermediare dă un punct \(x_u\in(x',x'')\) cu \(F(x_u)=u\).
Fie acum \(u\in(0,1)\) și \(x_u\in(a,b)\) unicul punct cu \(F(x_u)=u\); arătăm că \(F^{-1}(u)=x_u\). Avem \(x_u\in I_u\). Pentru \(x<x_u\): dacă \(x\in(a,x_u)\), atunci \(F(x)<F(x_u)=u\) (\(F\) este strict crescătoare pe \((a,b)\)); dacă \(x\le a\) (caz posibil doar când \(a>-\infty\)), atunci \(F(x)\le F(y)\) pentru orice \(y\in(a,b)\), deci \(F(x)\le\lim_{y\searrow a}F(y)=F(a+)=0<u\). Deci niciun \(x<x_u\) nu aparține lui \(I_u\), iar \(x_u\in I_u\); rezultă \(F^{-1}(u)=\inf I_u=x_u\), adică \(F^{-1}\) este inversa bijecției \(F:(a,b)\to(0,1)\).■
Punctele 2 și 3 spun că \(F^{-1}\) este o inversă „pe jumătate”: \(F\circ F^{-1}\ge\mathrm{id}\) și \(F^{-1}\circ F\le\mathrm{id}\). Inegalitățile pot fi stricte, iar corolarul următor arată exact când: salturile lui \(F\) devin paliere ale lui \(F^{-1}\), iar palierele lui \(F\) devin salturi ale lui \(F^{-1}\).
Corolarul 10(Salturi și paliere)
Fie \(F\) o funcție de repartiție.
Dacă \(F\) are un salt în \(x_0\), adică \(F(x_0-)<F(x_0)\), atunci \(F^{-1}(u)=x_0\) pentru orice \(u\in\big(F(x_0-),F(x_0)\big]\cap(0,1)\); pentru un astfel de \(u<F(x_0)\), \(F(F^{-1}(u))=F(x_0)>u\).
Dacă \(F\) are un palier la nivelul \(u_0\in(0,1)\), adică \(F(x)=u_0\) pentru \(x\in[x_1,x_2)\) și \(F(x)<u_0\) pentru \(x<x_1\), atunci \(F^{-1}(u_0)=x_1\), iar \(F^{-1}(u)\ge x_2\) pentru orice \(u>u_0\): \(F^{-1}\) are în \(u_0\) un salt de mărime cel puțin \(x_2-x_1\); pentru \(x\in(x_1,x_2)\), \(F^{-1}(F(x))=x_1<x\).
Demonstrație.
Fie \(u\in(F(x_0-),F(x_0)]\cap(0,1)\). Cum \(F(x_0)\ge u\), lema dă \(F^{-1}(u)\le x_0\). Pentru \(x<x_0\), monotonia dă \(F(x)\le F(x_0-)<u\), deci \(x\notin I_u\); rezultă \(I_u\subseteq[x_0,\infty)\) și \(F^{-1}(u)\ge x_0\). Așadar \(F^{-1}(u)=x_0\) și \(F(F^{-1}(u))=F(x_0)\), strict mai mare decât \(u\) dacă \(u<F(x_0)\).
Cum \(F(x_1)=u_0\) și \(F(x)<u_0\) pentru \(x<x_1\), avem \(x_1\in I_{u_0}\) și niciun \(x<x_1\) nu este în \(I_{u_0}\), deci \(F^{-1}(u_0)=x_1\). Fie \(u>u_0\) și \(x<x_2\): dacă \(x\in[x_1,x_2)\), \(F(x)=u_0<u\); dacă \(x<x_1\), \(F(x)<u_0<u\). Deci \(I_u\subseteq[x_2,\infty)\) și \(F^{-1}(u)\ge x_2\). În fine, pentru \(x\in(x_1,x_2)\), \(F^{-1}(F(x))=F^{-1}(u_0)=x_1<x\).
■
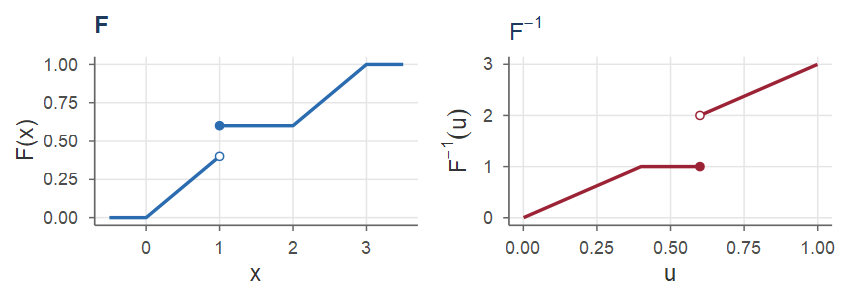
Figura 4 ilustrează corolarul pe funcția de repartiție mixtă din exemplul care urmează: saltul lui \(F\) devine un palier al lui \(F^{-1}\), iar palierul lui \(F\) devine un salt al lui \(F^{-1}\).
Arată codul R
Fmix <-function(x) ifelse(x <0, 0, ifelse(x <1, 0.4* x, # Fifelse(x <2, 0.6, ifelse(x <3, 0.6+0.4* (x -2), 1))))Qmix <-function(u) ifelse(u <=0.4, 2.5* u, # F^{-1}ifelse(u <=0.6, 1, 2+2.5* (u -0.6)))xs <-seq(-0.5, 3.5, by =0.001); us <-seq(0.001, 0.999, by =0.001)dF <-data.frame(x = xs, y =Fmix(xs), r = xs >=1) # ramurile lui FdQ <-data.frame(u = us, y =Qmix(us), r = us >0.6) # ramurile lui F^{-1}p1 <-ggplot(dF, aes(x, y, group = r)) +geom_line() +annotate("point", x =1, y =c(0.4, 0.6), shape =c(21, 19), fill ="white",colour = culori[["albastru"]]) +labs(title ="F", y ="F(x)")p2 <-ggplot(dQ, aes(u, y, group = r)) +geom_line(colour = culori[["rosu"]]) +annotate("point", x =0.6, y =c(1, 2), shape =c(19, 21), fill ="white",colour = culori[["rosu"]]) +labs(title =expression(F^{-1}), y =expression(F^{-1}*(u)))p1 + p2
Figura 4: Funcția de repartiție mixtă din exemplul de mai jos (stânga), cu un salt în \(x=1\) și un palier pe \([1,2)\), și funcția cuantilă asociată (dreapta). Saltul lui \(F\) devine un palier al lui \(F^{-1}\), iar palierul lui \(F\) devine un salt al lui \(F^{-1}\); \(F^{-1}\) este continuă la stânga (punctul plin în \(u=0.6\)).
Exemplul 7(Funcția cuantilă a unei repartiții mixte)
Fie \(F(x)=0\) pentru \(x<0\), \(F(x)=0.4x\) pentru \(0\le x<1\), \(F(x)=0.6\) pentru \(1\le x<2\), \(F(x)=0.6+0.4(x-2)\) pentru \(2\le x<3\) și \(F(x)=1\) pentru \(x\ge3\). Este repartiția unei v.a. care, cu probabilitatea \(0.4\), este uniformă pe \((0,1)\), cu probabilitatea \(0.2\) este egală cu \(1\) și, cu probabilitatea \(0.4\), este uniformă pe \((2,3)\). \(F\) are un salt în \(x_0=1\) (de la \(F(1-)=0.4\) la \(F(1)=0.6\)) și un palier la nivelul \(0.6\) pe \([1,2)\).
Funcția cuantilă. Urmăm cei trei pași de calcul (nivelul \(u\), mulțimea \(I_u=\{x:\ F(x)\ge u\}\), cel mai mic element al ei). Nivelurile \(u\in(0,1)\) se împart în trei zone, după valorile lui \(F\) la capetele ramurilor: \(F(1-)=0.4\) și \(F(1)=F(2)=0.6\).
Zona \(0<u\le0.4\) (ramura continuă de pe \([0,1)\)). Pe \((0,1)\), \(F\) este continuă și strict crescătoare, cu valori în \((0,0.4)\). Pentru \(u\in(0,0.4)\), inecuația \(0.4x\ge u\) are pe \([0,1)\) soluțiile \(x\ge u/0.4\), iar toate punctele \(x\ge1\) convin, deoarece acolo \(F(x)\ge0.6>u\); deci \(I_u=[u/0.4,\infty)\) și \(F^{-1}(u)=u/0.4=2.5u\). De exemplu, \(F^{-1}(0.2)=0.5\). Pentru \(u=0.4\): \(F(x)=0.4x<0.4\) pentru orice \(x<1\), iar \(F(1)=0.6\ge0.4\), deci \(I_{0.4}=[1,\infty)\) și \(F^{-1}(0.4)=1=2.5\cdot0.4\), adică formula rămâne valabilă și la capătul zonei.
Zona \(0.4<u\le0.6\) (saltul din \(x_0=1\)). Pentru \(x<1\), \(F(x)<0.4<u\); pentru \(x\ge1\), \(F(x)\ge0.6\ge u\). Deci \(I_u=[1,\infty)\) și \(F^{-1}(u)=1\) pentru toate aceste niveluri: este Corolarul 10(a), cu \(x_0=1\), \(F(1-)=0.4\) și \(F(1)=0.6\). De exemplu, \(F^{-1}(0.5)=1\), deși ecuația \(F(x)=0.5\) nu are nicio soluție.
Zona \(0.6<u<1\) (ramura continuă de pe \([2,3)\)). Avem \(F(x)\le0.6<u\) pentru orice \(x<2\), deci cel mai mic \(x\) cu \(F(x)\ge u\) se află pe ramura \([2,3)\), pe care \(F\) este continuă și strict crescătoare, cu valori în \([0.6,1)\). Acolo \(0.6+0.4(x-2)\ge u\iff x\ge2+(u-0.6)/0.4\), iar punctul \(2+(u-0.6)/0.4\) aparține intervalului \((2,3)\); deci \(I_u=\big[2+(u-0.6)/0.4,\infty\big)\) și \(F^{-1}(u)=2+(u-0.6)/0.4=2+2.5(u-0.6)\). De exemplu, \(F^{-1}(0.8)=2+2.5\cdot0.2=2.5\).
Așadar \[
F^{-1}(u)=\begin{cases}2.5\,u, & 0<u\le0.4,\\ 1, & 0.4<u\le0.6,\\ 2+2.5\,(u-0.6), & 0.6<u<1,\end{cases}
\] o funcție crescătoare și continuă la stânga, cu un palier (imaginea saltului lui \(F\)) și un salt de la \(1\) la \(2\) în \(u=0.6\) (imaginea palierului lui \(F\)), ca în Figura 4.
Cuantile. Mediana este \(F^{-1}(0.5)=1\), cuartilele sunt \(Q_1=F^{-1}(0.25)=0.625\) și \(Q_3=F^{-1}(0.75)=2+2.5\cdot0.15=2.375\). Inegalitățile din Propoziția 9 sunt stricte în punctele „speciale”: \(F(F^{-1}(0.5))=F(1)=0.6>0.5\) (salt) și \(F^{-1}(F(1.5))=F^{-1}(0.6)=1<1.5\) (palier).
Funcția de repartiție mixtă de mai sus are, în același timp, ramuri strict crescătoare, un salt și un palier; este deci un bun teren de verificare pentru fiecare punct al Propoziției 9.
Exemplul 8(Verificarea proprietăților funcției cuantilă pe repartiția mixtă)
Fie \(F\) și \(F^{-1}\) din Exemplul 7. Calculăm, pentru câteva niveluri \(u\), cuantila \(q=F^{-1}(u)\) și valorile \(F(q)\) și \(F(q-)\), iar pentru câteva puncte \(x\), valorile \(F(x)\) și \(F^{-1}(F(x))\): \[
\begin{array}{l|ccccc}
u & 0.2 & 0.4 & 0.5 & 0.6 & 0.8\\\hline
q=F^{-1}(u)\rule{0pt}{2.6ex} & 0.5 & 1 & 1 & 1 & 2.5\\
F(q) & 0.2 & 0.6 & 0.6 & 0.6 & 0.8\\
F(q-) & 0.2 & 0.4 & 0.4 & 0.4 & 0.8
\end{array}
\qquad\qquad
\begin{array}{l|ccccc}
x & 0.5 & 1 & 1.5 & 2 & 2.5\\\hline
F(x)\rule{0pt}{2.6ex} & 0.2 & 0.6 & 0.6 & 0.6 & 0.8\\
F^{-1}(F(x)) & 0.5 & 1 & 1 & 1 & 2.5
\end{array}
\] (De exemplu, pentru \(u=0.4\): \(q=2.5\cdot0.4=1\), \(F(1)=0.6\) și \(F(1-)=\lim_{x\nearrow1}0.4x=0.4\).)
Punctul 1 (monotonia). Pe prima linie a tabelului din stânga nivelurile cresc, iar cuantilele \(0.5,\ 1,\ 1,\ 1,\ 2.5\) nu scad niciodată; ele pot însă rămâne pe loc (pe palierul lui \(F^{-1}\)).
Punctul 2. În fiecare coloană, \(F(q-)\le u\le F(q)\). Pentru \(u=0.2\) și \(u=0.8\), punctul \(q\) se află pe o ramură pe care \(F\) este continuă, iar \(F(q)=u\). Pentru \(u=0.4\) și \(u=0.5\), cuantila este punctul de salt și \(F(q)=0.6>u\); nivelul \(u\) este „prins” între \(F(1-)=0.4\) și \(F(1)=0.6\). Pentru \(u=0.6\) cuantila este tot punctul de salt, dar \(F(q)=0.6=u\): egalitatea poate avea loc și într-un punct în care \(F\) nu este continuă.
Punctul 3. În tabelul din dreapta, \(F^{-1}(F(x))\le x\) în fiecare coloană. Egalitatea are loc pentru \(x=0.5\), \(x=1\) și \(x=2.5\), puncte la stânga cărora \(F\) este strict mai mică. Pentru \(x=1.5\) și \(x=2\) inegalitatea este strictă, \(F^{-1}(F(x))=1<x\): de exemplu \(F(x')=0.6=F(1.5)\) pentru orice \(x'\in[1,1.5)\), deci condiția de egalitate din enunț nu este îndeplinită. Funcția \(F^{-1}\circ F\) „împinge” fiecare punct al palierului în capătul lui din stânga.
Punctul 4 (continuitatea la stânga). În \(u=0.6\): pentru \(u_n=0.6-\frac1n\), \(n\ge5\), avem \(u_n\in[0.4,0.6)\) și \(F^{-1}(u_n)=1\to1=F^{-1}(0.6)\), pe când pentru \(v_n=0.6+\frac1n\), \(n\ge3\), avem \(v_n\in(0.6,1)\) și \(F^{-1}(v_n)=2+\frac{2.5}{n}\to2\ne F^{-1}(0.6)\). Funcția cuantilă este continuă la stânga, dar nu și la dreapta.
Punctul 5 și lema. Pentru \(u=0.5\) avem \(F^{-1}(0.5)=1\), iar echivalențele \(F(x)<0.5\iff x<1\) și \(F(x)\ge0.5\iff x\ge1\) se citesc direct din definiția lui \(F\): pentru \(x<1\), \(F(x)<0.4\), iar pentru \(x\ge1\), \(F(x)\ge0.6\). De exemplu, \(x=0.9\) dă \(F(0.9)=0.36<0.5\) și \(0.9<1\).
Punctul 6. Ipotezele lui nu sunt îndeplinite: \(F\) nu este nici strict crescătoare (palierul), nici continuă (saltul), deci \(F^{-1}\) nu este o inversă propriu-zisă. Totuși, pe fiecare ramură strict crescătoare funcția cuantilă inversează ramura: pentru \(u\in(0,0.4)\), \(F(2.5u)=0.4\cdot2.5u=u\), iar pentru \(u\in(0.6,1)\), \(F\big(2+2.5(u-0.6)\big)=0.6+0.4\cdot2.5\,(u-0.6)=u\).
Proprietatea 2 are și o interpretare probabilistă, care justifică denumirea de „cuantilă”.
Corolarul 11(Interpretarea cuantilei)
Fie \(X\) o v.a. cu funcția de repartiție \(F\), \(p\in(0,1)\) și \(q_p=F^{-1}(p)\). Atunci \[
\PP(X\le q_p)\ge p\qquad\text{și}\qquad\PP(X\ge q_p)\ge1-p ,
\] iar \(q_p\) este cel mai mic număr real \(m\) cu \(\PP(X\le m)\ge p\).
Demonstrație. Prima inegalitate este \(F(F^{-1}(p))\ge p\) (punctul 2). Pentru a doua, \(\PP(X\ge q_p)=1-\PP(X<q_p)=1-F(q_p-)\ge1-p\), deoarece \(F(q_p-)\le p\) (punctul 2) și \(\PP(X<q_p)=F(q_p-)\) (Propoziția 14 din Cursul 1). În fine, dacă \(m\in\R\) verifică \(\PP(X\le m)=F(m)\ge p\), lema (cu \(u=p\) și \(x=m\)) dă \(m\ge F^{-1}(p)=q_p\); cum \(q_p\) însuși verifică \(\PP(X\le q_p)\ge p\) (prima inegalitate), el este cel mai mic număr cu această proprietate.■
Așadar cuantila de ordin \(p\) lasă „cel puțin \(p\)” din masa repartiției la stânga și „cel puțin \(1-p\)” la dreapta. Pot exista mai multe numere cu această proprietate (o „cuantilă în sens larg”); convenția \(F^{-1}\) o alege pe cea mai mică. De exemplu, pentru \(X\sim\Bern(1/2)\), orice \(m\in[0,1]\) verifică \(\PP(X\le m)\ge\frac12\) și \(\PP(X\ge m)\ge\frac12\), iar mediana este \(F^{-1}(\frac12)=0\).
3.1 Cuantilele repartițiilor uzuale
Calculăm funcțiile cuantilă ale câtorva repartiții uzuale; în R, ele sunt implementate de funcțiile q... (qexp, qnorm, qunif, qbinom, qpois etc.), care urmează exact Definiția 7.
Exemplul 9(Cuantilele unor repartiții continue)
Uniforma. Pentru \(X\sim\Unif(a,b)\), \(F(x)=\frac{x-a}{b-a}\) pe \([a,b]\) este continuă și strict crescătoare pe \((a,b)\), cu \(F(a+)=0\) și \(F(b-)=1\); din punctul 6, \(F^{-1}(u)\) este soluția ecuației \(\frac{x-a}{b-a}=u\), adică \(F^{-1}(u)=a+(b-a)u\). Pentru \(\Unif(0,1)\), \(F^{-1}(u)=u\).
Exponențiala. Pentru \(X\sim\Exp(\lambda)\), \(F(x)=\int_0^x\lambda e^{-\lambda t}\dd t=\big[-e^{-\lambda t}\big]_0^x=1-e^{-\lambda x}\) pentru \(x\ge0\) și \(F(x)=0\) pentru \(x<0\). Pe \((0,\infty)\), \(F\) este continuă și strict crescătoare (\(F'(x)=\lambda e^{-\lambda x}>0\)), cu \(F(0+)=0\) și \(F(\infty-)=1\), deci \[
1-e^{-\lambda x}=u\iff e^{-\lambda x}=1-u\iff -\lambda x=\ln(1-u)\iff x=-\frac{\ln(1-u)}{\lambda}=F^{-1}(u).
\] Mediana este \(\frac{\ln2}{\lambda}\approx\frac{0.693}{\lambda}\), mai mică decât media \(\frac1\lambda\) (repartiția este asimetrică la dreapta), iar cuartilele sunt \(Q_1=\frac{\ln(4/3)}\lambda\approx\frac{0.288}\lambda\) și \(Q_3=\frac{\ln4}\lambda\approx\frac{1.386}\lambda\).
Cauchy. Pentru \(X\sim\Cauchy(0,1)\), cu densitatea \(f(x)=\frac{1}{\pi(1+x^2)}\), \(x\in\R\), cum \((\arctan t)'=\frac1{1+t^2}\) și \(\lim_{t\to-\infty}\arctan t=-\frac\pi2\), \[
F(x)=\int_{-\infty}^x\frac{\dd t}{\pi(1+t^2)}=\frac1\pi\Big(\arctan x+\frac\pi2\Big)=\frac12+\frac1\pi\arctan x .
\]\(F\) este continuă și strict crescătoare pe \(\R\) (densitatea este strict pozitivă), cu limitele \(0\) și \(1\) la \(\mp\infty\), deci punctul 6 se aplică cu \((a,b)=\R\): \[
\frac12+\frac1\pi\arctan x=u\iff\arctan x=\pi\Big(u-\frac12\Big)\iff x=\tan\Big(\pi\Big(u-\frac12\Big)\Big)=F^{-1}(u),
\] a doua echivalență fiind adevărată deoarece \(\pi\big(u-\frac12\big)\in\big(-\frac\pi2,\frac\pi2\big)\) pentru \(u\in(0,1)\), interval pe care \(\tan\) este inversa funcției \(\arctan\). Mediana este \(F^{-1}\big(\frac12\big)=\tan0=0\), iar cuartilele sunt \(Q_{1,3}=\tan\big(\mp\frac\pi4\big)=\mp1\).
Normala. Pentru \(X\sim\Norm(\mu,\sigma^2)\), \(F(x)=\PP\big(\frac{X-\mu}{\sigma}\le\frac{x-\mu}{\sigma}\big)=\Phi\big(\frac{x-\mu}\sigma\big)\) este continuă și strict crescătoare pe \(\R\) (densitatea este strict pozitivă), cu limitele \(0\) și \(1\) la \(\mp\infty\); punctul 6 se aplică cu \((a,b)=\R\), atât pentru \(F\), cât și pentru \(\Phi\), deci \[
F(x)=p\iff\Phi\Big(\frac{x-\mu}\sigma\Big)=p\iff\frac{x-\mu}\sigma=z_p\iff x=\mu+\sigma z_p ,
\] unde \(z_p=\Phi^{-1}(p)\) (qnorm(p)); așadar \(F^{-1}(p)=\mu+\sigma z_p\). Densitatea normală standard \(\varphi(t)=\frac{1}{\sqrt{2\pi}}e^{-t^2/2}\) este pară, deci, cu schimbarea de variabilă \(s=-t\) (\(\dd s=-\dd t\); când \(t\) parcurge \((-\infty,-x)\), \(s\) parcurge \((x,\infty)\)), \[
\Phi(-x)=\int_{-\infty}^{-x}\varphi(t)\dd t=\int_{x}^{\infty}\varphi(-s)\dd s=\int_x^\infty\varphi(s)\dd s=1-\Phi(x).
\] Pentru \(x=z_p\) obținem \(\Phi(-z_p)=1-p\), adică \(z_{1-p}=-z_p\). Mediana este \(\mu+\sigma z_{1/2}=\mu\) (din \(\Phi(-0)=1-\Phi(0)\) rezultă \(\Phi(0)=\frac12\), deci \(z_{1/2}=0\)), iar, cu \(z_{0.75}\approx0.6745\) și \(z_{0.25}=-z_{0.75}\), cuartilele sunt \(Q_{1,3}=\mu\mp0.6745\,\sigma\), deci \(Q_3-Q_1=2z_{0.75}\,\sigma\approx1.349\,\sigma\); de aici estimatorul robust \(\mathrm{IQR}/1.349\) al lui \(\sigma\), folosit în statistica descriptivă. Cuantila \(z_{0.975}\approx1.96\) va apărea la toate intervalele de încredere de nivel \(0.95\).
Două aplicații numerice. (i) Timpul de funcționare al unui bec (în ani) are repartiția \(\Exp(\lambda)\) cu \(\lambda=0.2\), deci media \(\frac1\lambda=5\). Din (b), mediana este \(\frac{\ln2}{0.2}\approx3.47\), cuartilele sunt \(Q_1=\frac{\ln(4/3)}{0.2}\approx1.44\) și \(Q_3=\frac{\ln4}{0.2}\approx6.93\), iar cuantila de ordin \(0.95\) este \(-\frac{\ln(1-0.95)}{0.2}=\frac{\ln20}{0.2}\approx14.98\). Citim: jumătate dintre becuri se ard în primii \(3.47\) ani, deși media este de \(5\) ani, iar \(5\%\) dintre ele funcționează aproape \(15\) ani sau mai mult. (ii) Punctajul la un test are repartiția \(\Norm(100,15^2)\). Din (d), cuartilele sunt \(100\mp0.6745\cdot15\), adică \(Q_1\approx89.88\) și \(Q_3\approx110.12\), iar, cu \(z_{0.9}\approx1.2816\), cuantila de ordin \(0.9\) este \(100+15\cdot1.2816\approx119.22\): un punctaj de cel puțin \(119.22\) este obținut de \(10\%\) dintre candidați.
În R: qexp(0.5, 2) întoarce \(\ln2/2\approx0.3466\), qcauchy(0.75) întoarce \(1\), iar qnorm(0.975) întoarce \(1.959964\approx1.96\).
Exemplul 10(Cuantilele repartițiilor discrete)
Fie \(X\sim\begin{pmatrix}x_1&x_2&\cdots\\p_1&p_2&\cdots\end{pmatrix}\) cu \(x_1<x_2<\cdots\) (în număr finit sau numărabil), \(s_0=0\) și \(s_k=p_1+\dots+p_k\). Funcția de repartiție este în scară: \(F(x)=0\) pentru \(x<x_1\) și \[
F(x)=s_k=p_1+\dots+p_k\qquad\text{pentru}\quad x_k\le x<x_{k+1}
\] (dacă \(X\) are \(K\) valori, \(F(x)=1\) pentru \(x\ge x_K\)). Fie \(u\in(0,1)\). Există indici \(k\) cu \(s_k\ge u\): dacă \(X\) are \(K\) valori, \(s_K=1\ge u\), iar dacă are o infinitate de valori, \(s_k\nearrow\sum_{k\ge1}p_k=1>u\). Fie \(k\) cel mai mic astfel de indice; atunci \(s_{k-1}<u\le s_k\) (pentru \(k=1\), \(s_0=0<u\)). Pentru \(x\ge x_k\) avem \(F(x)\ge F(x_k)=s_k\ge u\), iar pentru \(x<x_k\) avem \(F(x)\le s_{k-1}<u\); deci \(I_u=[x_k,\infty)\) și \[
F^{-1}(u)=\begin{cases}
x_1, & 0<u\le p_1,\\
x_2, & p_1<u\le p_1+p_2,\\
\ \vdots\\
x_k, & s_{k-1}<u\le s_k,\\
\ \vdots
\end{cases}
\qquad\text{adică}\qquad F^{-1}(u)=\sum_{k\ge1}x_k\,\Ind_{(s_{k-1},\,s_k]}(u).
\] Intervalul \((0,1]\) este tăiat în bucăți de lungimi \(p_1,p_2,\dots\), iar valoarea \(x_k\) este atribuită bucății a \(k\)-a: este cazul particular (a) al Corolarului 10, fiecare atom devenind un palier al lui \(F^{-1}\).
Bernoulli. Pentru \(X\sim\Bern(p)\): \(x_1=0\), \(x_2=1\), \(s_1=1-p\), deci \(F^{-1}(u)=0\) pentru \(u\le1-p\) și \(F^{-1}(u)=1\) pentru \(u>1-p\). Pentru \(p=\frac12\), mediana este \(0\).
O variabilă cu patru valori. Pentru \(X\sim\begin{pmatrix}0&1&2&5\\0.1&0.4&0.3&0.2\end{pmatrix}\), sumele cumulate sunt \(s_1=0.1\), \(s_2=0.5\), \(s_3=0.8\), \(s_4=1\), deci \(F^{-1}(u)=0\) pentru \(u\le0.1\), \(F^{-1}(u)=1\) pentru \(0.1<u\le0.5\), \(F^{-1}(u)=2\) pentru \(0.5<u\le0.8\) și \(F^{-1}(u)=5\) pentru \(u>0.8\). Mediana este \(F^{-1}(0.5)=1\), iar cuartilele sunt \(Q_1=F^{-1}(0.25)=1\) și \(Q_3=F^{-1}(0.75)=2\).
Poisson. Pentru \(X\sim\Pois(3)\), \(F(2)=e^{-3}\big(1+3+\frac92\big)\approx0.4232<0.5\) și \(F(3)=F(2)+e^{-3}\frac{27}{6}\approx0.6472\ge0.5\), deci mediana este \(F^{-1}(0.5)=3\), iar \(F(\mathrm{Me})\approx0.647>0.5\): inegalitatea din Corolarul 11 este strictă. În R, funcțiile qpois, qbinom, qgeom etc. calculează exact cel mai mic \(x\) cu \(F(x)\ge u\): qpois(0.5, 3) întoarce \(3\).
Cuantile citite dintr-un tabel. Pentru o repartiție discretă a cărei funcție de repartiție nu are o formulă simplă, cuantilele se citesc dintr-un tabel al lui \(F\). Pentru \(\Pois(3)\) îl completăm din aproape în aproape, cu \(p_k=\PP(X=k)\): \(p_0=e^{-3}\approx0.0498\), \(p_k=p_{k-1}\cdot\frac3k\) și \(F(k)=F(k-1)+p_k\): \[
\begin{array}{l|ccccccccc}
k & 0&1&2&3&4&5&6&7&8\\\hline
p_k\rule{0pt}{2.6ex} & 0.0498&0.1494&0.2240&0.2240&0.1680&0.1008&0.0504&0.0216&0.0081\\
F(k) & 0.0498&0.1991&0.4232&0.6472&0.8153&0.9161&0.9665&0.9881&0.9962
\end{array}
\] Regula de citire este cea din formula generală: \(F^{-1}(u)\) este primul\(k\) din tabel pentru care \(F(k)\ge u\). Astfel, \(Q_1=F^{-1}(0.25)=2\), deoarece \(F(1)\approx0.1991<0.25\le F(2)\approx0.4232\); \(Q_3=F^{-1}(0.75)=4\), deoarece \(F(3)\approx0.6472<0.75\le F(4)\approx0.8153\); la fel, \(q_{0.9}=5\), \(q_{0.95}=6\) și \(q_{0.99}=8\) (deoarece \(F(7)\approx0.9881<0.99\le F(8)\approx0.9962\)). Toate nivelurile \(u\in(0.6472,\,0.8153]\) au aceeași cuantilă, \(4\): este palierul lui \(F^{-1}\) care corespunde atomului din \(4\). În R, qpois(c(0.25, 0.5, 0.75, 0.9, 0.95, 0.99), 3) întoarce \(2,\ 3,\ 4,\ 5,\ 6,\ 8\).
Atenție! (Două greșeli frecvente)
Pentru o repartiție discretă nu „rezolvăm ecuația \(F(x)=u\)”, care de regulă nu are soluții, ci căutăm primul punct în care \(F\) atinge sau depășește nivelul \(u\). Când nivelul coincide exact cu o sumă cumulată, \(u=s_k\), cuantila este \(x_k\), nu \(x_{k+1}\): inegalitatea nestrictă stă în dreapta, \(s_{k-1}<u\le s_k\). Pentru variabila cu patru valori de mai sus, \(F(1)=0.5\), deci mediana este \(1\), nu \(2\) și nici media aritmetică \(1.5\) a celor două valori (o altă convenție, folosită uneori în statistica descriptivă).
La un palier al lui \(F\) la nivelul \(u\), toate punctele palierului verifică \(F(x)=u\), dar cuantila este numai capătul din stânga. Dacă am defini cuantila cu inegalitatea strictă \(F(x)>u\), am obține capătul din dreapta, iar lema fundamentală nu ar mai fi adevărată.
4 Universalitatea repartiției uniforme
Suntem acum pregătiți pentru rezultatul central al acestei părți: orice repartiție pe \(\R\) se obține dintr-o singură variabilă uniformă printr-o transformare deterministă, iar o variabilă cu funcție de repartiție continuă devine uniformă prin propria funcție de repartiție (Dalang and Conus 2018, Ex. 4.30). Cele două puncte ale teoremei merg în sensuri opuse. Punctul 1 pleacă de la un număr uniform și „fabrică” o variabilă cu repartiția dorită: îl folosim ori de câte ori vrem să construim sau să simulăm o variabilă aleatoare. Punctul 2 pleacă de la o variabilă cu repartiție continuă și o „uniformizează”: îl vom folosi mai târziu pentru a obține cantități a căror repartiție nu depinde de \(F\).
Teorema 12(Universalitatea repartiției uniforme)
Fie \(X\) o variabilă aleatoare reală cu funcția de repartiție \(F\) și \(U\sim\Unif(0,1)\). Atunci:
variabila aleatoare \(F^{-1}(U)\) are aceeași repartiție ca \(X\): \(\PP\big(F^{-1}(U)\le x\big)=F(x)\) pentru orice \(x\in\R\);
dacă \(F\) este continuă, atunci \(F(X)\sim\Unif(0,1)\).
Demonstrație.Ideea demonstrației. Lema 8 transformă evenimentul \(\{F^{-1}(U)\le x\}\), despre care nu știm nimic direct, în evenimentul \(\{U\le F(x)\}\), a cărui probabilitate este cunoscută. Pentru punctul 2 folosim forma strictă a lemei (punctul 5 al Propoziției 9) și continuitatea lui \(F\).
Pasul 0: buna definire. Funcția cuantilă este definită doar pe \((0,1)\). Cum \(\PP(U=0)=\PP(U=1)=0\), avem \(U\in(0,1)\) aproape sigur, deci \(F^{-1}(U)\) este bine definită a.s.; pe evenimentul neglijabil \(\{U\in\{0,1\}\}\) îi dăm o valoare constantă arbitrară, fără a schimba repartiția. În plus, \(F^{-1}\) este boreliană (punctul 1 al Propoziției 9), deci \(F^{-1}(U)\) este o variabilă aleatoare.
Pasul 1: repartiția lui \(F^{-1}(U)\). Fie \(x\in\R\). Aplicând lema în fiecare punct \(\omega\) cu \(U(\omega)\in(0,1)\), obținem egalitatea de evenimente (până la o mulțime neglijabilă) \[
\{\omega:\ F^{-1}(U(\omega))\le x\}=\{\omega:\ U(\omega)\le F(x)\}.
\] Funcția de repartiție a lui \(U\) este \(\PP(U\le t)=t\) pentru \(t\in[0,1]\), iar \(F(x)\in[0,1]\). Rezultă \[
\PP\big(F^{-1}(U)\le x\big)=\PP\big(U\le F(x)\big)=F(x),\qquad\forall x\in\R ,
\] deci \(F^{-1}(U)\) are funcția de repartiție \(F\), adică aceeași repartiție ca \(X\) (funcția de repartiție determină repartiția).
Pasul 2: repartiția lui \(F(X)\) pentru \(F\) continuă. Variabila \(F(X)\) ia valori în \([0,1]\). Fixăm \(u\in(0,1)\) și notăm \(q=F^{-1}(u)\). Din punctul 5 al Propoziției 9, aplicat în \(x=X(\omega)\), are loc egalitatea de evenimente \(\{F(X)<u\}=\{X<q\}\). Prin urmare \[
\PP\big(F(X)<u\big)=\PP(X<q)=F(q-)=F(q)=F\big(F^{-1}(u)\big)=u ,
\] unde am folosit, pe rând, egalitatea \(\PP(X<q)=F(q-)\) (Propoziția 14 din Cursul 1), continuitatea lui \(F\) în \(q\) și punctul 2 al Propoziției 9. Trecem de la inegalitatea strictă la cea nestrictă: pentru \(n\) suficient de mare (\(u+\frac1n<1\)), evenimentele \(\{F(X)<u+\frac1n\}\) descresc către \(\{F(X)\le u\}\) (un număr este mai mic decât \(u+\frac1n\) pentru orice \(n\) dacă și numai dacă este cel mult \(u\)), iar fiecare are probabilitatea \(u+\frac1n\), din egalitatea precedentă aplicată nivelului \(u+\frac1n\in(0,1)\). Din continuitatea probabilității (Propoziția 3 din Cursul 1), \[
\PP\big(F(X)\le u\big)=\lim_{n\to\infty}\PP\Big(F(X)<u+\frac1n\Big)=\lim_{n\to\infty}\Big(u+\frac1n\Big)=u .
\] În sfârșit, \(\PP(F(X)\le u)=0\) pentru \(u<0\) și \(=1\) pentru \(u\ge1\) (deoarece \(F(X)\in[0,1]\)), iar \(\PP(F(X)\le0)=\lim_{n}\PP(F(X)\le\frac1n)=\lim_n\frac1n=0\). Funcția de repartiție a lui \(F(X)\) coincide deci cu cea a repartiției \(\Unif(0,1)\).■
Atenție!
Ipoteza de continuitate din punctul 2 este esențială. Dacă \(X\sim\Bern(1/2)\), atunci \(F(0)=1/2\) și \(F(1)=1\), deci \(F(X)\in\{1/2,1\}\) nu este uniformă. În demonstrație, pasul care cade este \(F(q-)=F(q)\): pentru \(u=0.3\) avem \(q=F^{-1}(0.3)=0\) și \(\PP(F(X)<0.3)=\PP(X<0)=F(0-)=0\ne0.3\). Mai mult, \(F(X)\) este uniformă dacă și numai dacă \(F\) este continuă: dacă \(F\) are un salt în \(x_0\), atunci \(\PP\big(F(X)=F(x_0)\big)\ge\PP(X=x_0)=F(x_0)-F(x_0-)>0\), pe când repartiția uniformă nu are atomi. În schimb, punctul 1 este valabil pentru orice funcție de repartiție, inclusiv pentru cele discrete sau mixte.
Punctul 1 are o consecință anunțată în Cursul 1: proprietățile (a)–(c) din recapitulare (monotonia, limitele la \(\pm\infty\) și continuitatea la dreapta; Propoziția 14 din Cursul 1) caracterizează funcțiile de repartiție (Billingsley 1995, sec. 14).
Corolarul 13(Orice funcție cu proprietățile (a)–(c) este o funcție de repartiție)
Fie \(F:\R\to[0,1]\) crescătoare, continuă la dreapta, cu \(\lim_{x\to-\infty}F(x)=0\) și \(\lim_{x\to+\infty}F(x)=1\). Atunci există un câmp de probabilitate și o v.a. \(Y\) definită pe el cu \(F_Y=F\); echivalent, există o unică probabilitate \(\mu\) pe \(\big(\R,\B(\R)\big)\) cu \(\mu\big((-\infty,x]\big)=F(x)\) pentru orice \(x\).
Demonstrație.Ideea demonstrației. Repetăm construcția de la punctul 1 al Teoremei 12, pornind de data aceasta de la funcția \(F\) (nu de la o variabilă \(X\)): pe intervalul \((0,1)\), cu lungimea drept probabilitate, variabila \(Y=F^{-1}(U)\) are funcția de repartiție \(F\).
Pasul 1 (funcția cuantilă a lui \(F\)). Definim \(F^{-1}(u)=\inf\{x:F(x)\ge u\}\) pentru \(u\in(0,1)\). Demonstrația Lemei 8 nu folosește faptul că \(F\) provine dintr-o variabilă aleatoare, ci doar cele trei proprietăți: limitele la \(\pm\infty\) (Pașii 1 și 3), monotonia (Pasul 2) și continuitatea la dreapta (Pasul 4). Ea rămâne deci valabilă pentru funcția \(F\) din enunț: \(F^{-1}(u)\in\R\) și \(F^{-1}(u)\le x\iff u\le F(x)\) pentru orice \(u\in(0,1)\), \(x\in\R\).
Pasul 2 (existența). Pe câmpul \(\big((0,1),\B((0,1)),\lambda\big)\), unde \(\lambda\) este lungimea (măsura Lebesgue; existența ei ca probabilitate pe borelienele lui \((0,1)\) este admisă (Durrett 2019, sec. 1.1)), considerăm \(U(\omega)=\omega\) și \(Y(\omega)=F^{-1}(\omega)\). Pentru orice \(x\in\R\), din Pasul 1, \[
\{Y\le x\}=\{\omega\in(0,1):\ F^{-1}(\omega)\le x\}=\{\omega\in(0,1):\ \omega\le F(x)\}=(0,F(x)]\cap(0,1),
\] un interval, deci o mulțime boreliană; din criteriul de măsurabilitate cu semidrepte (Cursul 1, după Definiția 11 din Cursul 1), \(Y\) este o v.a. Lungimea acestui interval este \(F(x)\) (pentru \(F(x)=0\) el este vid, pentru \(F(x)=1\) este \((0,1)\), iar pentru \(0<F(x)<1\) este \((0,F(x)]\)). Așadar \(F_Y(x)=\lambda\big((0,F(x)]\cap(0,1)\big)=F(x)\) pentru orice \(x\), iar repartiția \(\mu=\lambda\circ Y^{-1}\) a lui \(Y\) este o probabilitate pe \(\big(\R,\B(\R)\big)\) cu \(\mu\big((-\infty,x]\big)=\lambda(Y\le x)=F(x)\).
Pasul 3 (unicitatea). Două probabilități pe \(\big(\R,\B(\R)\big)\) care coincid pe toate semidreptele \((-\infty,x]\) coincid pe toate borelienele: funcția de repartiție determină repartiția, fapt admis în Cursul 1.■
Teorema de universalitate se verifică ușor pe exemple. Punctul 1, aplicat funcțiilor cuantilă calculate în secțiunea precedentă, dă un algoritm de construcție a unei variabile aleatoare cu o repartiție dată: (1) generăm \(U\sim\Unif(0,1)\); (2) calculăm \(X=F^{-1}(U)\); atunci \(X\) are funcția de repartiție \(F\).
Exemplul 11(Repartiția exponențială și o repartiție discretă)
Pentru \(X\sim\Exp(\lambda)\), \(F^{-1}(u)=-\frac1\lambda\ln(1-u)\) (Exemplul 9), deci, dacă \(U\sim\Unif(0,1)\), atunci \(-\frac1\lambda\ln(1-U)\sim\Exp(\lambda)\). Cum și \(1-U\sim\Unif(0,1)\) (pentru \(u\in[0,1]\), \(\PP(1-U\le u)=\PP(U\ge1-u)=1-(1-u)=u\)), avem și \(-\frac1\lambda\ln U\sim\Exp(\lambda)\). Verificare directă: pentru \(x\ge0\), \(\PP\big(-\frac1\lambda\ln U\le x\big)=\PP\big(U\ge e^{-\lambda x}\big)=1-e^{-\lambda x}\) (am înmulțit inegalitatea cu \(-\lambda<0\), ceea ce îi schimbă sensul, și am aplicat exponențiala, care este crescătoare). Numeric, pentru \(\lambda=2\): dacă \(U=0.3\), atunci \(X=-\frac12\ln(1-0.3)=-\frac12\ln0.7\approx0.178\); dacă \(U=0.9\), atunci \(X=-\frac12\ln0.1\approx1.151\). Valorile mici ale lui \(U\) dau valori mici ale lui \(X\), iar cele apropiate de \(1\) dau valori mari: \(F^{-1}\) este crescătoare.
Pentru repartiția \(\Cauchy(0,1)\), \(F^{-1}(u)=\tan\big(\pi(u-\frac12)\big)\) (Exemplul 9), deci \(\tan\big(\pi(U-\frac12)\big)\sim\Cauchy(0,1)\).
Pentru o v.a. discretă, Exemplul 10 și Teorema 12 dau \[
\begin{aligned}
F^{-1}(U)&=\sum_{k\ge1}x_k\,\Ind_{\{s_{k-1}<U\le s_k\}},\\
\PP\big(F^{-1}(U)=x_k\big)&=\PP(s_{k-1}<U\le s_k)=s_k-s_{k-1}=p_k ,
\end{aligned}
\] confirmare directă a punctului 1: \(F^{-1}(U)\) ia valoarea \(x_k\) exact când \(U\) cade în bucata a \(k\)-a a intervalului \((0,1]\). Aceste „rețete” stau la baza metodei inverse de simulare din Cursul 4.
Punctul 2 al teoremei se verifică și el direct pentru repartiția exponențială: \(F(X)=1-e^{-\lambda X}\) ia valori în \([0,1)\) și, pentru \(u\in(0,1)\), \(\PP\big(1-e^{-\lambda X}\le u\big)=\PP\big(X\le-\frac1\lambda\ln(1-u)\big)=1-e^{\ln(1-u)}=u\), deci \(F(X)\sim\Unif(0,1)\).
În codul de mai jos aplicăm algoritmul pentru \(\Exp(2)\) și pentru variabila cu patru valori din Exemplul 10(b).
Media empirică a valorilor \(F^{-1}(U_i)\) pentru \(\lambda=2\) este apropiată de \(1/\lambda=0.5\), frecvența relativă a evenimentului \(\{X\le1\}\) este apropiată de \(F(1)=1-e^{-2}\approx0.8647\), iar frecvențele valorilor \(0,1,2,5\) reproduc probabilitățile \(0.1,0.4,0.3,0.2\) cu erori de ordinul \(\sqrt{0.25/10^5}\approx0.0016\).
Figura 5 ilustrează ambele puncte ale teoremei, precum și eșecul punctului 2 pentru o repartiție discretă.
Figura 5: Universalitatea repartiției uniforme (\(10^4\) valori simulate). Stânga: histograma lui \(F^{-1}(U)=-\frac12\ln(1-U)\) și densitatea \(\mathrm{Exp}(2)\) (punctul 1). Mijloc: histograma lui \(\Phi(X)\) pentru \(X\sim\mathcal{N}(0,1)\), practic uniformă (punctul 2). Dreapta: frecvențele valorilor lui \(F(X)\) pentru \(X\sim\mathrm{Pois}(3)\), care nu este uniformă (\(F\) are salturi).
Exemplul următor parcurge construcția „de la \(U\) la \(X\)” pentru trei funcții de repartiție din secțiunea precedentă: scriem \(X=F^{-1}(U)\), verificăm direct, fără a invoca teorema, că funcția ei de repartiție este \(F\), apoi examinăm variabila \(F(X)\).
Exemplul 12(De la U la X: o repartiție discretă, una cu palier și una mixtă)
Fie \(U\sim\Unif(0,1)\); reamintim că \(\PP(a<U\le b)=b-a\) pentru \(0\le a\le b\le1\).
Repartiția discretă \(F_C\) (numărul de steme la două aruncări; Exemplul 6(c)). Funcția cuantilă este constantă pe trei intervale, deci \[
X=F_C^{-1}(U)=\begin{cases}0, & U\le\frac14,\\ 1, & \frac14<U\le\frac34,\\ 2, & U>\frac34 .\end{cases}
\] De exemplu, numerele \(U=0.07,\ 0.25,\ 0.62,\ 0.75,\ 0.91\) produc valorile \(X=0,\ 0,\ 1,\ 1,\ 2\). Verificare.\(\PP(X=0)=\PP\big(U\le\frac14\big)=\frac14\), \(\PP(X=1)=\PP\big(\frac14<U\le\frac34\big)=\frac12\) și \(\PP(X=2)=\PP\big(U>\frac34\big)=\frac14\): sunt probabilitățile numărului de steme, deci \(\PP(X\le x)=F_C(x)\) pentru orice \(x\). Intervalul \((0,1]\) a fost tăiat în trei bucăți de lungimi \(\frac14,\frac12,\frac14\). Variabila \(F_C(X)\) ia valorile \(F_C(0)=\frac14\), \(F_C(1)=\frac34\) și \(F_C(2)=1\), cu probabilitățile \(\frac14,\frac12,\frac14\): nu este uniformă, în acord cu caseta de atenționare de mai sus (\(F_C\) are salturi).
Repartiția continuă cu palier \(F_B\) (uniforma pe \((0,1)\cup(2,3)\); Exemplul 6(b)). Aici \[
X=F_B^{-1}(U)=\begin{cases}2U, & U\le\frac12,\\ 2U+1, & U>\frac12 ,\end{cases}
\] deci \(X\in(0,1]\) când \(U\le\frac12\) și \(X\in(2,3)\) când \(U>\frac12\). Verificare, pe ramurile lui \(F_B\). Pentru \(0\le x<1\): \(\{X\le x\}=\{2U\le x\}=\{U\le\frac x2\}\) (a doua ramură dă \(X>2>x\)), de probabilitate \(\frac x2\). Pentru \(1\le x<2\): \(\{X\le x\}=\{U\le\frac12\}\) (pe prima ramură \(X\le1\le x\), pe a doua \(X>2>x\)), de probabilitate \(\frac12\). Pentru \(2\le x<3\): \(\{X\le x\}=\{U\le\frac12\}\cup\{\frac12<U\le\frac{x-1}{2}\}\), de probabilitate \(\frac{x-1}{2}\). Cum \(0<X<3\), am regăsit toate ramurile lui \(F_B\). Variabila \(F_B(X)\): pentru \(U\le\frac12\), \(F_B(X)=F_B(2U)=U\), iar pentru \(U>\frac12\), \(F_B(X)=F_B(2U+1)=\frac{(2U+1)-1}{2}=U\). Deci \(F_B(X)=U\) este uniformă, așa cum prevede punctul 2 al teoremei: \(F_B\) este continuă, chiar dacă nu este injectivă.
Repartiția mixtă din Exemplul 7. Din formula lui \(F^{-1}\), \[
X=F^{-1}(U)=\begin{cases}2.5\,U, & U\le0.4,\\ 1, & 0.4<U\le0.6,\\ 2+2.5\,(U-0.6), & U>0.6 .\end{cases}
\] De exemplu, \(U=0.3\) dă \(X=0.75\), \(U=0.5\) dă \(X=1\), iar \(U=0.7\) dă \(X=2.25\). Verificare. Pentru \(0\le x<1\): \(\{X\le x\}=\{2.5U\le x\}=\{U\le0.4x\}\) (celelalte două ramuri dau \(X\ge1>x\)), de probabilitate \(0.4x\). Pentru \(1\le x<2\): \(\{X\le x\}=\{U\le0.6\}\) (primele două ramuri dau \(X\le1\), a treia dă \(X>2\)), de probabilitate \(0.6\). Pentru \(2\le x<3\): \(\{X\le x\}=\{U\le0.6\}\cup\{0.6<U\le0.6+0.4(x-2)\}\), deoarece \(2+2.5(U-0.6)\le x\iff U\le0.6+0.4(x-2)\); probabilitatea este \(0.6+0.4(x-2)\). Pentru \(x<0\) și \(x\ge3\) obținem \(0\), respectiv \(1\). Deci \(\PP(X\le x)=F(x)\) pentru orice \(x\). Atomul repartiției, \(\PP(X=1)=F(1)-F(1-)=0.2\), provine din întregul interval \([0.4,0.6]\) de valori ale lui \(U\), de lungime \(0.2\). Variabila \(F(X)\): pentru \(U<0.4\) și pentru \(U>0.6\) avem \(F(X)=U\) (punctul 6 din Exemplul 8), iar pentru \(0.4\le U\le0.6\), \(X=1\) și \(F(X)=F(1)=0.6\). Deci \(F(X)\ge U\) întotdeauna, cu inegalitate strictă exact când \(0.4\le U<0.6\), adică pe nivelurile „sărite” de \(F\) (punctul 2 al Propoziției 9), iar \(\PP\big(F(X)=0.6\big)=0.2>0\): \(F(X)\) nu este uniformă.
Exemplul 13(Uniforma discretă și extragerea unui individ)
Repartiția uniformă pe \(\{1,\dots,N\}\) are valorile \(x_k=k\) cu probabilitățile \(p_k=\frac1N\), deci sumele cumulate sunt \(s_k=\frac kN\), \(k=0,1,\dots,N\). Din Exemplul 10, pentru \(u\in(0,1)\), \(F^{-1}(u)=k\) dacă și numai dacă \(s_{k-1}<u\le s_k\), adică \[
\frac{k-1}{N}<u\le\frac kN\iff k-1<Nu\le k\iff k=\lceil Nu\rceil ,
\] ultima echivalență fiind definiția părții întregi superioare (\(\lceil y\rceil\) este unicul întreg \(k\) cu \(k-1<y\le k\)). Deci \(F^{-1}(u)=\lceil Nu\rceil\). De exemplu, pentru \(N=6\) (aruncarea unui zar): \(u=0.62\) dă \(\lceil3.72\rceil=4\), \(u=0.5\) dă \(\lceil3\rceil=3\), iar \(u=0.999\) dă \(\lceil5.994\rceil=6\); fiecare față corespunde unui interval de niveluri de lungime \(\frac16\). Din punctul 1 al Teoremei 12, dacă \(U\sim\Unif(0,1)\), atunci \(\lceil NU\rceil=F^{-1}(U)\) este uniformă pe \(\{1,\dots,N\}\). Verificare directă: pentru \(k\in\{1,\dots,N\}\), \(\PP(\lceil NU\rceil=k)=\PP\big(\frac{k-1}{N}<U\le\frac kN\big)=\frac kN-\frac{k-1}N=\frac1N\). Aceasta este regula prin care se extrage un individ la întâmplare dintr-o populație finită pornind de la un număr uniform: dacă \(U_1,\dots,U_n\) sunt independente și uniforme pe \((0,1)\), atunci indicii \(J_i=\lceil NU_i\rceil\) sunt i.i.d. uniformi pe \(\{1,\dots,N\}\) (Propoziția 39 din Cursul 1), adică formează o selecție simplă cu revenire de volum \(n\) (Definiția 2).
5 Existența eșantioanelor independente
Pentru a vorbi despre \(\Xbar\asto\mu\) sau despre \(\sqrt n(\Xbar-\mu)/\sigma\dto\Norm(0,1)\) avem nevoie de un șir infinit\(X_1,X_2,\dots\) de v.a. independente, cu repartiții date, definite pe același câmp de probabilitate. Pentru un număr finit de variabile, câmpul produs din Cursul 2 este suficient. Pentru un șir infinit, produsul infinit de probabilități cere o teoremă de extensie netrivială. Vom demonstra existența constructiv, luând drept câmp de probabilitate chiar intervalul \([0,1)\) cu măsura Lebesgue\(\lambda\) (lungimea: \(\lambda([a,b))=b-a\)), care modelează alegerea unui număr „la întâmplare” în \([0,1)\); pe acest câmp, \(U(\omega)=\omega\) este o variabilă \(\Unif(0,1)\), deoarece \(\lambda(U\le x)=\lambda([0,x])=x\) pentru \(x\in[0,1)\). Lucrăm pe \([0,1)\), și nu pe \([0,1]\), doar pentru ca intervalele semideschise \([a,b)\) să formeze partiții; punctul \(1\) are lungimea nulă. Pe lângă faptele admise în Cursul 1 (criteriul de măsurabilitate cu semidrepte și faptul că funcția de repartiție determină repartiția), admitem două rezultate: existența măsurii Lebesgue (o probabilitate pe borelienele lui \([0,1)\) care dă fiecărui interval lungimea lui), rezultat de teoria măsurii (Durrett 2019, sec. 1.1), și asociativitatea independenței (Propoziția 19 de mai jos); tot restul construcției este demonstrat complet.
Teorema 14(Existența șirurilor de variabile aleatoare independente)
Fie \((\mu_n)_{n\ge1}\) un șir de măsuri de probabilitate pe \(\big(\R,\B(\R)\big)\). Atunci există un câmp de probabilitate \((\Omega,\F,\PP)\) și un șir \((X_n)_{n\ge1}\) de variabile aleatoare independente definite pe el, astfel încât repartiția lui \(X_n\) este \(\mu_n\), adică \(\PP\circ X_n^{-1}=\mu_n\), pentru orice \(n\ge1\). Mai mult, putem lua \((\Omega,\F,\PP)=\big([0,1),\B([0,1)),\lambda\big)\).
În particular, luând \(\mu_n=Q\) pentru orice \(n\), obținem existența unui șir i.i.d. din populația \(Q\), deci a eșantioanelor de orice volum, toate definite pe același câmp de probabilitate. Demonstrația are trei pași: \[
\underbrace{\Bern(q_n)}_{\text{Pasul 1}}\ \ \longrightarrow\ \ \underbrace{\Unif(0,1)}_{\text{Pasul 2}}\ \ \longrightarrow\ \ \underbrace{\mu_n\ \text{arbitrare}}_{\text{Pasul 3}}.
\] Pasul 3 folosește universalitatea repartiției uniforme (Teorema 12), iar Pasul 2, asociativitatea independenței; aceeași construcție se găsește în (Billingsley 1995, sec. 20) (vezi și (Jacod and Protter 2004, cap. 10)).
5.1 Pasul 1: șiruri de variabile Bernoulli
Propoziția 15(Pasul 1: șiruri de variabile Bernoulli)
Fie \(p_n\in[0,1]\), \(q_n=1-p_n\), \(n\ge1\). Pe \(\big([0,1),\B([0,1)),\lambda\big)\) există un șir \((X_n)_{n\ge1}\) de v.a. independente cu \(\PP(X_n=0)=p_n\) și \(\PP(X_n=1)=q_n\).
Construim variabilele inductiv, prin subdivizări succesive ale intervalului \([0,1)\): la fiecare nivel, fiecare interval se taie în proporția \(p_n:q_n\), partea stângă primind valoarea \(0\), iar cea dreaptă valoarea \(1\) (Figura 6). La primul nivel, \([0,1)\) se împarte în două intervale, \(I_0\) și \(I_1\), de lungimi \(p_1\) și \(q_1\), și punem \(X_1=0\) pe \(I_0\) și \(X_1=1\) pe \(I_1\); atunci \(\PP(X_1=0)=\lambda(I_0)=p_1\) și \(\PP(X_1=1)=\lambda(I_1)=q_1\). La al doilea nivel, \(I_0\) se împarte în \(I_{00}\) și \(I_{01}\), de lungimi \(p_1p_2\) și \(p_1q_2\), iar \(I_1\) în \(I_{10}\) și \(I_{11}\), de lungimi \(q_1p_2\) și \(q_1q_2\); punem \(X_2=0\) pe \(I_{00}\cup I_{10}\) și \(X_2=1\) pe \(I_{01}\cup I_{11}\). Atunci \(\PP(X_2=0)=p_1p_2+q_1p_2=p_2\) și, de exemplu, \(\PP(X_1=0,X_2=0)=\lambda(I_{00})=p_1p_2=\PP(X_1=0)\,\PP(X_2=0)\). Demonstrația de mai jos face riguros pasul general al acestei construcții.
Arată codul R
p <-c(0.4, 0.6, 0.5) # p_k = P(X_k = 0)I <-data.frame(a =0, b =1, w ="") # intervalul [a, b) și cuvântul wniv <-list()for (k in1:3) { # împărțim intervalele p_k : q_k m <- I$a + p[k] * (I$b - I$a) I <-data.frame(a =c(rbind(I$a, m)), b =c(rbind(m, I$b)),w =c(rbind(paste0(I$w, "0"), paste0(I$w, "1")))) niv[[k]] <-transform(I, k = k, x =substr(w, k, k)) # x = valoarea X_k}d <-do.call(rbind, niv)ggplot(d) +geom_segment(aes(x = a, xend = b, y =-k, yend =-k, colour = x),linewidth =2.5) +geom_segment(aes(x = a, xend = a, y =-k -0.15, yend =-k +0.15)) +annotate("segment", x =1, xend =1, y =-(1:3) -0.15,yend =-(1:3) +0.15) +geom_text(data =subset(d, k <3), aes(x = (a + b) /2, y =-k +0.32,label =paste0('I["', w, '"]')), parse =TRUE, size =3) +geom_text(aes(x = (a + b) /2, y =-k -0.35, label =round(b - a, 3)),size =2.5, colour ="grey30") +scale_colour_manual(values =c("0"= culori[["albastru"]],"1"= culori[["rosu"]]), guide ="none") +scale_y_continuous(breaks =-(1:3), labels =c("X1", "X2", "X3"),limits =c(-3.5, -0.6)) +labs(x =expression(omega), y =NULL)
Figura 6: Construcția de la Pasul 1 pentru \(p_1=0.4\), \(p_2=0.6\), \(p_3=0.5\) (\(p_k=\mathbb{P}(X_k=0)\)): la nivelul \(k\), fiecare interval pe care \((X_1,\dots,X_{k-1})\) este constant se împarte în proporția \(p_k:q_k\); \(X_k=0\) pe părțile albastre și \(X_k=1\) pe cele roșii. Sub fiecare interval este scrisă lungimea lui, produsul factorilor \(p_j\) sau \(q_j\).
Demonstrație.Ideea demonstrației. Probabilitatea unui eveniment de forma \(\{X_1=e_1,\dots,X_n=e_n\}\) este lungimea unui interval, iar lungimile sunt construite ca produse; independența este atunci „încorporată” în construcție.
Pasul 1a (construcția, prin inducție). Pentru \(n=1\) punem \(I_0=[0,p_1)\), \(I_1=[p_1,1)\) și \(X_1=0\) pe \(I_0\), \(X_1=1\) pe \(I_1\); atunci \(\lambda(I_0)=p_1\), \(\lambda(I_1)=q_1\), deci relațiile de mai jos au loc pentru \(n=1\). Presupunem construite (pentru un \(n\ge1\)) intervalele \(I_{e_1\dots e_n}\), \(e_k\in\{0,1\}\), de forma \([a,b)\) cu \(a\le b\) (pentru \(a=b\) intervalul este vid, ceea ce se întâmplă dacă un \(p_k\) este \(0\) sau \(1\)), care formează o partiție a lui \([0,1)\) în \(2^n\) intervale, cu \[
\lambda(I_{e_1\dots e_n})=\prod_{k=1}^np_k^{1-e_k}q_k^{e_k}\qquad(\text{convenția }0^0=1),
\] și variabilele \(X_1,\dots,X_n\) cu proprietatea \[
X_k(\omega)=e_k\ \text{ pentru orice } k\le n\quad\Longleftrightarrow\quad\omega\in I_{e_1\dots e_n}.
\tag{4}\] Împărțim fiecare \(I_{e_1\dots e_n}=[a,b)\) în \(I_{e_1\dots e_n0}=[a,\,a+p_{n+1}(b-a))\) și \(I_{e_1\dots e_n1}=[a+p_{n+1}(b-a),\,b)\) și definim \(X_{n+1}(\omega)=e_{n+1}\) dacă \(\omega\in I_{e_1\dots e_ne_{n+1}}\) pentru un cuvânt \(e_1\dots e_n\). Cele două părți sunt disjuncte și au reuniunea \([a,b)\), deci noile intervale formează o partiție a lui \([0,1)\) în \(2^{n+1}\) intervale, iar \(X_{n+1}\) este bine definită pe \([0,1)\). Lungimile lor sunt \(p_{n+1}(b-a)\), respectiv \((b-a)-p_{n+1}(b-a)=q_{n+1}(b-a)\), adică \[
\lambda(I_{e_1\dots e_n0})=\lambda(I_{e_1\dots e_n})\,p_{n+1},\qquad\lambda(I_{e_1\dots e_n1})=\lambda(I_{e_1\dots e_n})\,q_{n+1},
\] ceea ce, împreună cu ipoteza de inducție, dă formula produsului la rangul \(n+1\): factorul nou este \(p_{n+1}=p_{n+1}^{1-0}q_{n+1}^{0}\) pentru \(e_{n+1}=0\) și \(q_{n+1}=p_{n+1}^{1-1}q_{n+1}^{1}\) pentru \(e_{n+1}=1\). Proprietatea (4) se transmite de la \(n\) la \(n+1\): „\(X_k(\omega)=e_k\) pentru \(k\le n+1\)” înseamnă „\(\omega\in I_{e_1\dots e_n}\)” (ipoteza de inducție) și „\(\omega\) se află în partea \(e_{n+1}\) a acestui interval”, adică \(\omega\in I_{e_1\dots e_{n+1}}\). Prin urmare, pentru orice \(n\) și orice \(e_1,\dots,e_n\in\{0,1\}\), \[
\PP(X_1=e_1,\dots,X_n=e_n)=\lambda(I_{e_1\dots e_n})=\prod_{k=1}^np_k^{1-e_k}q_k^{e_k}.
\tag{5}\]
De exemplu, pentru \(n=2\): \(\{X_1=0,X_2=1\}=I_0\cap(I_{01}\cup I_{11})=I_{01}\), de lungime \(p_1q_2\).
Pasul 1b (repartițiile marginale). Fixăm \(n\) și \(e_n\) și sumăm (5) după \(e_1,\dots,e_{n-1}\in\{0,1\}\) (evenimentele corespunzătoare sunt disjuncte și au reuniunea \(\{X_n=e_n\}\)). Suma unui produs de factori care depind de indici diferiți se factorizează: \[
\PP(X_n=e_n)=\sum_{e_1,\dots,e_{n-1}}\prod_{k=1}^{n}p_k^{1-e_k}q_k^{e_k}=\Big(\prod_{k=1}^{n-1}\underbrace{\sum_{e_k\in\{0,1\}}p_k^{1-e_k}q_k^{e_k}}_{=p_k+q_k=1}\Big)\,p_n^{1-e_n}q_n^{e_n}=p_n^{1-e_n}q_n^{e_n}.
\]
Pasul 1c (independența). Fiecare \(X_n\) este constantă pe fiecare dintre cele \(2^n\) intervale ale partiției de rang \(n\), deci \(\{X_n=1\}\) este o reuniune finită de intervale, adică o mulțime boreliană: \(X_n\) este o variabilă aleatoare. Din Pasul 1b, relația (5) devine \(\PP(X_1=e_1,\dots,X_n=e_n)=\prod_{k=1}^n\PP(X_k=e_k)\): funcția de masă comună se factorizează, deci \(X_1,\dots,X_n\) sunt independente pentru orice \(n\) (Propoziția 38 din Cursul 1). Pentru variabile cu valori în \(\{0,1\}\), forma cu boreliene a independenței se obține direct, sumând factorizarea după valorile \(e_k\in B_k\cap\{0,1\}\): \[
\begin{aligned}
\PP(X_1\in B_1,\dots,X_n\in B_n)&=\sum_{e_1\in B_1}\cdots\sum_{e_n\in B_n}\ \prod_{k=1}^n\PP(X_k=e_k)\\
&=\prod_{k=1}^n\ \sum_{e_k\in B_k}\PP(X_k=e_k)=\prod_{k=1}^n\PP(X_k\in B_k).
\end{aligned}
\] Orice subfamilie finită a șirului este inclusă într-o familie \(\{X_1,\dots,X_n\}\) și este independentă (luăm \(B_k=\R\) pentru indicii care lipsesc), deci șirul \((X_n)_{n\ge1}\) este format din v.a. independente.■
Exemplul 14(Construcția de la Pasul 1 pentru un omega dat)
Fie \(p_k=\frac13\) și \(q_k=\frac23\) pentru orice \(k\) și \(\omega=0.5\). Urmăm construcția de la Pasul 1a: fiecare interval \([a,b)\) se împarte în \([a,\,a+\frac13(b-a))\), pe care noua variabilă ia valoarea \(0\), și \([a+\frac13(b-a),\,b)\), pe care ia valoarea \(1\).
Nivelul 1.\([0,1)\) se împarte în \(I_0=[0,\frac13)\) și \(I_1=[\frac13,1)\). Cum \(0.5\ge\frac13\), \(\omega\in I_1\) și \(X_1(\omega)=1\).
Nivelul 2.\(I_1=[\frac13,1)\) are lungimea \(\frac23\) și se împarte în punctul \(\frac13+\frac13\cdot\frac23=\frac59\approx0.556\): \(I_{10}=[\frac13,\frac59)\) și \(I_{11}=[\frac59,1)\). Cum \(0.5<\frac59\), \(\omega\in I_{10}\) și \(X_2(\omega)=0\).
Nivelul 3.\(I_{10}=[\frac13,\frac59)\) are lungimea \(\frac29\) și se împarte în punctul \(\frac13+\frac13\cdot\frac29=\frac{9+2}{27}=\frac{11}{27}\approx0.407\): \(I_{100}=[\frac13,\frac{11}{27})\) și \(I_{101}=[\frac{11}{27},\frac59)\). Cum \(0.5\ge\frac{11}{27}\), \(\omega\in I_{101}\) și \(X_3(\omega)=1\).
Așadar \(\big(X_1(\omega),X_2(\omega),X_3(\omega)\big)=(1,0,1)\), iar intervalul \(I_{101}=\big[\frac{11}{27},\frac{15}{27}\big)\) are lungimea \(\frac4{27}=q_1p_2q_3\), în acord cu (5).
Lungimea lui \(I_{010}\). Din formula produsului de la Pasul 1a, cu \((e_1,e_2,e_3)=(0,1,0)\), \(\lambda(I_{010})=p_1q_2p_3=\frac13\cdot\frac23\cdot\frac13=\frac2{27}\). Direct: \(I_0=[0,\frac13)\), \(I_{01}=[\frac19,\frac13)\) (partea dreaptă, de lungime \(\frac29\)), \(I_{010}=[\frac19,\frac19+\frac13\cdot\frac29)=[\frac{3}{27},\frac{5}{27})\).
Pentru \(p_k=\frac12\), intervalele \(I_{e_1\dots e_k}\) sunt intervalele diadice\(\big[\frac{j}{2^k},\frac{j+1}{2^k}\big)\), \(j=\sum_{i=1}^ke_i2^{k-i}\), iar \(X_k(\omega)\) este chiar a \(k\)-a cifră binară a lui \(\omega\). Enunțăm separat acest caz, deoarece el face legătura cu Pasul 2.
Lema 16(Cifrele binare ale unui număr uniform)
Pe \(\big([0,1),\B([0,1)),\lambda\big)\) definim, pentru \(k\ge1\), \(D_k(\omega)=\lfloor2^k\omega\rfloor\bmod2\) (a \(k\)-a cifră a dezvoltării binare a lui \(\omega\), cea care nu se termină cu o infinitate de cifre \(1\)). Atunci:
\(D_1,D_2,\dots\) sunt v.a. independente, cu \(\PP(D_k=0)=\PP(D_k=1)=\frac12\);
\(\omega=\sum_{k\ge1}D_k(\omega)\,2^{-k}\) pentru orice \(\omega\in[0,1)\).
Demonstrație.Ideea demonstrației. Pentru \(p_k=\frac12\), intervalele construite la Pasul 1 sunt intervalele diadice, iar variabilele \(X_k\) sunt chiar cifrele binare \(D_k\); partea (a) este atunci un caz particular al Propoziției 15.
Pasul 1 (intervalele diadice). Fie \((X_k)_{k\ge1}\) și \(I_{e_1\dots e_k}\) variabilele și intervalele din demonstrația Propoziției 15 pentru \(p_k=q_k=\frac12\). Arătăm prin inducție după \(k\) că, pentru orice \(e_1,\dots,e_k\in\{0,1\}\), \[
I_{e_1\dots e_k}=\Big[\frac{j}{2^k},\frac{j+1}{2^k}\Big),\qquad\text{unde}\quad j=\sum_{i=1}^ke_i2^{k-i}.
\] Pentru \(k=1\), \(I_0=\big[0,\frac12\big)\) și \(I_1=\big[\frac12,1\big)\). Dacă relația are loc la rangul \(k\), atunci \(I_{e_1\dots e_k}=[a,b)\), cu \(a=\frac{j}{2^k}\) și \(b-a=\frac1{2^k}\), se împarte în două jumătăți, \[
I_{e_1\dots e_k0}=\Big[\frac{2j}{2^{k+1}},\frac{2j+1}{2^{k+1}}\Big),\qquad I_{e_1\dots e_k1}=\Big[\frac{2j+1}{2^{k+1}},\frac{2j+2}{2^{k+1}}\Big),
\] adică \(I_{e_1\dots e_{k+1}}=\big[\frac{j'}{2^{k+1}},\frac{j'+1}{2^{k+1}}\big)\) cu \(j'=2j+e_{k+1}=\sum_{i=1}^{k+1}e_i2^{k+1-i}\): relația are loc la rangul \(k+1\).
Pasul 2 (\(X_k=D_k\)). Fie \(\omega\in[0,1)\), \(k\ge1\) și \(e_i=X_i(\omega)\) pentru \(i\le k\). Din (4) și din Pasul 1, \(\omega\in I_{e_1\dots e_k}=\big[\frac{j}{2^k},\frac{j+1}{2^k}\big)\), adică \(j\le2^k\omega<j+1\), deci \[
\lfloor2^k\omega\rfloor=j=e_k+2\sum_{i=1}^{k-1}e_i2^{k-1-i},
\] un număr de aceeași paritate cu \(e_k\). Prin urmare \(D_k(\omega)=j\bmod2=e_k=X_k(\omega)\). Așadar \(D_k=X_k\) pentru orice \(k\ge1\), iar partea (a) rezultă din Propoziția 15: variabilele \(D_k\) sunt independente și \(\PP(D_k=0)=p_k=\frac12\), \(\PP(D_k=1)=q_k=\frac12\).
Pasul 3 (dezvoltarea). Cu notațiile de la Pasul 2, \(\sum_{i=1}^kD_i(\omega)2^{-i}=2^{-k}\sum_{i=1}^ke_i2^{k-i}=j/2^k\), iar din \(j\le2^k\omega<j+1\) rezultă \[
0\le\omega-\sum_{i=1}^kD_i(\omega)2^{-i}<\frac1{2^k}\xrightarrow[k\to\infty]{}0 ,
\] deci seria converge la \(\omega\): aceasta este partea (b). Inegalitatea strictă arată și că dezvoltarea obținută nu se termină cu o infinitate de cifre \(1\): dacă am avea \(D_i(\omega)=1\) pentru orice \(i>k\) (pentru un \(k\ge0\)), atunci \(\omega-\sum_{i=1}^kD_i(\omega)2^{-i}=\sum_{i>k}2^{-i}=2^{-k}\), în contradicție cu inegalitatea strictă (pentru \(k=0\): \(\omega=1\notin[0,1)\)).■
Lema spune că a alege un număr uniform în \([0,1)\) este totuna cu a arunca de o infinitate de ori o monedă echilibrată: de exemplu, evenimentul „primele patru cifre binare sunt \(0110\)” este intervalul \([6/16,7/16)\), de probabilitate \(1/16\). Pasul 2 folosește reciproca: din aruncări independente ale monedei reconstruim numere uniforme.
Exemplul 15(Cifrele binare ale unui număr dat)
Fie \(\omega=\pi-3=0.14159265\ldots\) Calculăm primele lui cifre binare în două moduri.
Cu formula din lemă.\(D_k(\omega)=\lfloor2^k\omega\rfloor\bmod2\). Notăm \(j_k=\lfloor2^k\omega\rfloor\); atunci \(j_k\le2^k\omega<j_k+1\), adică \(\omega\) se află în intervalul diadic \(\big[\frac{j_k}{2^k},\frac{j_k+1}{2^k}\big)\), iar suma parțială \(\sum_{i\le k}D_i(\omega)2^{-i}\) este capătul lui din stânga, \(j_k/2^k\) (Pasul 3 al demonstrației): \[
\begin{array}{l|cccccccc}
k & 1&2&3&4&5&6&7&8\\\hline
2^k\omega\rule{0pt}{2.6ex} & 0.283&0.566&1.133&2.265&4.531&9.062&18.124&36.248\\
j_k=\lfloor2^k\omega\rfloor & 0&0&1&2&4&9&18&36\\
D_k(\omega)=j_k\bmod2 & 0&0&1&0&0&1&0&0\\
j_k/2^k & 0&0&0.125&0.125&0.125&0.1406&0.1406&0.1406
\end{array}
\] De exemplu, \(j_3=1\) este impar, deci \(D_3(\omega)=1\) și \(\omega\in\big[\frac18,\frac28\big)\); \(j_6=9\) este impar, deci \(D_6(\omega)=1\) și \(\omega\in\big[\frac{9}{64},\frac{10}{64}\big)\approx[0.1406,\,0.1563)\). După opt cifre, \(\omega-\frac{36}{256}\approx0.00097<2^{-8}\approx0.0039\), așa cum cere inegalitatea de la Pasul 3: fiecare cifră nouă înjumătățește intervalul în care este localizat \(\omega\).
Prin dublări succesive. În practică, cifrele se obțin dublând repetat numărul: partea întreagă a rezultatului este cifra următoare, iar partea fracționară se dublează din nou. Pornind de la \(\omega\approx0.1416\), rezultatele succesive (rotunjite la patru zecimale) sunt \(0.2832\) (cifra \(0\)), \(0.5664\) (cifra \(0\)), \(1.1327\) (cifra \(1\); păstrăm \(0.1327\)), \(0.2655\) (cifra \(0\)), \(0.5310\) (cifra \(0\)), \(1.0619\) (cifra \(1\)) și așa mai departe. Primele \(15\) cifre sunt \(\omega=0.001\,001\,000\,011\,111\ldots\) în baza \(2\).
Legătura cu Pasul 1. Pentru \(p_k=\frac12\) avem \(X_k(\omega)=D_k(\omega)\): \(X_1(\omega)=0\), deoarece \(\omega\in I_0=\big[0,\frac12\big)\); \(X_2(\omega)=0\), deoarece \(\omega\in I_{00}=\big[0,\frac14\big)\); \(X_3(\omega)=1\), deoarece \(\omega\in I_{001}=\big[\frac18,\frac14\big)\). Evenimentul „primele trei cifre sunt \(001\)” este intervalul \(I_{001}\), de probabilitate \(\frac18\), cât probabilitatea unui rezultat fixat la trei aruncări ale unei monede echilibrate.
5.2 Pasul 2: șiruri de variabile uniforme independente
Propoziția 17(Pasul 2: șiruri de variabile uniforme independente)
Pe \(\big([0,1),\B([0,1)),\lambda\big)\) există un șir \((U_n)_{n\ge1}\) de v.a. independente, cu \(U_n\sim\Unif(0,1)\) pentru orice \(n\).
Din Pasul 1 cu \(p_m=q_m=\frac12\) (sau direct din Lema 16), există un șir \((X_m)_{m\ge1}\) de v.a. independente cu \(\PP(X_m=0)=\PP(X_m=1)=\frac12\). Ideea este să rearanjăm acest șir într-un tablou cu o infinitate de linii, fiecare linie fiind un șir infinit de „aruncări ale monedei” din care construim o uniformă. Pentru aceasta avem nevoie de o bijecție între \(\N^*\times\N^*\) și \(\N^*\).
Folosim numerotarea pe diagonale a lui Cantor, \[
\phi:\N^*\times\N^*\to\N^*,\qquad\phi(n,k)=\frac{(n+k-1)(n+k-2)}{2}+k ,
\] care este o bijecție: cele \(d-1\) perechi de pe diagonala \(n+k=d\) (\(d\ge2\)) primesc, în ordinea crescătoare a lui \(k\), numerele consecutive de la \(\frac{(d-1)(d-2)}{2}+1\) până la \(\frac{(d-1)(d-2)}{2}+(d-1)=\frac{d(d-1)}{2}\), iar diagonalele succesive se așază una după alta, fără goluri și fără suprapuneri. Valorile lui \(\phi\) pentru \(n,k\le4\) (linia \(n\), coloana \(k\)) sunt \[
\big(\phi(n,k)\big)_{1\le n,k\le4}=\begin{pmatrix}1&3&6&10\\2&5&9&14\\4&8&13&19\\7&12&18&25\end{pmatrix}:
\] numerele \(1;\ 2,3;\ 4,5,6;\ 7,8,9,10;\dots\) se așază pe diagonale succesive, de jos în sus. Notăm \(X_{n,k}:=X_{\phi(n,k)}\) și definim uniformele linie cu linie: \[
\begin{aligned}
U_1&\ \longleftarrow\ X_{1,1},\ X_{1,2},\ X_{1,3},\ \dots\\
U_2&\ \longleftarrow\ X_{2,1},\ X_{2,2},\ X_{2,3},\ \dots\\
&\ \ \vdots\\
U_n&\ \longleftarrow\ X_{n,1},\ X_{n,2},\ X_{n,3},\ \dots
\end{aligned}
\qquad\qquad U_n=\sum_{k=1}^{\infty}\frac{X_{n,k}}{2^k},
\] adică \(U_n\) este numărul cu cifrele binare \(0.X_{n,1}X_{n,2}X_{n,3}\dots\) De exemplu, \(U_1=\frac{X_1}{2}+\frac{X_3}{4}+\frac{X_6}{8}+\dots\) și \(U_2=\frac{X_2}{2}+\frac{X_5}{4}+\frac{X_9}{8}+\dots\): fiecare \(U_n\) „folosește” propria linie a tabloului, iar liniile diferite nu au cifre comune.
Exemplul 16(Primele cifre ale primelor uniforme, pentru un omega dat)
Continuăm Exemplul 15: \(\omega=\pi-3\) și \(X_m=D_m(\omega)\), cu \(X_1,\dots,X_{15}\) egale cu \(0,0,1,\ 0,0,1,\ 0,0,0,\ 0,1,1,\ 1,1,1\). Numerotarea pe diagonale trimite cifra de rang \(m=\phi(n,k)\) pe linia \(n\) a tabloului, în poziția \(k\): \[
\begin{array}{l|ccccccccccccccc}
\text{rangul } m & 1&2&3&4&5&6&7&8&9&10&11&12&13&14&15\\\hline
\text{linia } n\rule{0pt}{2.6ex} & 1&2&1&3&2&1&4&3&2&1&5&4&3&2&1\\
\text{poziția } k & 1&1&2&1&2&3&1&2&3&4&1&2&3&4&5\\
X_m & 0&0&1&0&0&1&0&0&0&0&1&1&1&1&1
\end{array}
\] Diagonala \(n+k=d\) ocupă rangurile de la \(\frac{(d-1)(d-2)}2+1\) la \(\frac{d(d-1)}2\), adică \(m=1\); \(m=2,3\); \(m=4,5,6\); \(m=7,\dots,10\); \(m=11,\dots,15\); pe fiecare diagonală, poziția \(k\) crește de la \(1\) la \(d-1\), iar linia \(n=d-k\) scade. De exemplu, \(\phi(3,2)=\frac{4\cdot3}{2}+2=8\). Citim acum tabelul pe linii, grupând coloanele cu același \(n\): \[
\begin{array}{l|l|l|l}
& \text{cifrele folosite} & \text{valorile lor} & \text{suma parțială}\\\hline
U_1\rule{0pt}{2.8ex} & X_1,X_3,X_6,X_{10},X_{15} & 0,1,1,0,1 & S_{1,5}=\frac14+\frac18+\frac1{32}=\frac{13}{32}=0.40625\\[2pt]
U_2 & X_2,X_5,X_9,X_{14} & 0,0,0,1 & S_{2,4}=\frac1{16}=0.0625\\[2pt]
U_3 & X_4,X_8,X_{13} & 0,0,1 & S_{3,3}=\frac18=0.125\\[2pt]
U_4 & X_7,X_{12} & 0,1 & S_{4,2}=\frac14=0.25\\[2pt]
U_5 & X_{11} & 1 & S_{5,1}=\frac12=0.5
\end{array}
\] După \(15\) cifre ale lui \(\omega\) cunoaștem cinci cifre ale lui \(U_1\), patru ale lui \(U_2\), …, una a lui \(U_5\) și niciuna a lui \(U_6\). Fiecare diagonală nouă aduce câte o cifră fiecărei linii deja începute și deschide o linie nouă; nicio linie nu este neglijată, deci fiecare \(U_n\) își primește, până la urmă, toate cifrele. Cum restul seriei este cuprins între \(0\) și \(\sum_{i>k}2^{-i}=2^{-k}\), avem \(S_{n,k}\le U_n\le S_{n,k}+2^{-k}\): de exemplu, \(U_1(\omega)\in[0.40625,\,0.4375]\) și \(U_2(\omega)\in[0.0625,\,0.125]\). (Folosind câte \(40\) de cifre pe linie se obțin \(U_1(\omega)\approx0.4220\), \(U_2(\omega)\approx0.0632\) și \(U_3(\omega)\approx0.2025\).) Numerele \(U_1(\omega),U_2(\omega),\dots\) sunt complet determinate de \(\omega\); Propoziția 17 afirmă că, atunci când \(\omega\) este ales uniform în \([0,1)\), ele sunt variabile aleatoare independente și uniforme.
Rămâne să arătăm că variabilele \(U_n\) sunt independente și uniforme pe \([0,1]\). Independența rezultă din construcție (linii diferite ale tabloului nu au variabile comune) și dintr-un rezultat general de teoria probabilităților, pe care îl formulăm în limbajul \(\sigma\)-algebrelor.
Definiția 18(Independența σ-algebrelor)
Fie \((\Omega,\F,\PP)\) un câmp de probabilitate și \(\{\F_t:\ t\in T\}\) o familie de sub-\(\sigma\)-algebre ale lui \(\F\). Familia este independentă dacă pentru orice \(k\ge2\), orice indici distincți \(t_1,\dots,t_k\in T\) și orice evenimente \(A_j\in\F_{t_j}\), \[
\PP(A_1\cap\dots\cap A_k)=\PP(A_1)\cdots\PP(A_k).
\] Pentru o v.a. \(X\), \(\sigma(X)=\{X^{-1}(B):\ B\in\B(\R)\}\) este \(\sigma\)-algebra generată de \(X\); pentru o familie de v.a. \(\{X_s:s\in S\}\), \(\sigma(X_s:\ s\in S)\) este cea mai mică \(\sigma\)-algebră în raport cu care toate \(X_s\) sunt măsurabile.
Cu această definiție, v.a. \(\{X_t\}\) sunt independente dacă și numai dacă \(\sigma\)-algebrele \(\{\sigma(X_t)\}\) sunt independente: este exact forma cu boreliene din Definiția 37 din Cursul 1, deoarece evenimentele din \(\sigma(X_t)\) sunt \(\{X_t\in B\}\). În plus, orice sub-\(\sigma\)-algebre ale unor \(\sigma\)-algebre independente sunt independente (factorizarea are loc, în particular, pentru evenimentele din sub-\(\sigma\)-algebre).
Propoziția 19(Asociativitatea independenței)
Fie \(\{\F_t:\ t\in T\}\) o familie de \(\sigma\)-algebre independente și \(\{T_s:\ s\in\mathcal{S}\}\) o familie de submulțimi ale lui \(T\), disjuncte două câte două (de exemplu, o partiție a lui \(T\)). Dacă \(\F_{T_s}=\sigma\big(\bigcup_{t\in T_s}\F_t\big)\), atunci \(\{\F_{T_s}:\ s\in\mathcal{S}\}\) este o familie de \(\sigma\)-algebre independente.
Admitem acest rezultat: demonstrația lui folosește un instrument de teoria măsurii (teorema \(\pi\)–\(\lambda\) a lui Dynkin) și se găsește în (Durrett 2019, sec. 2.1), (Billingsley 1995, sec. 4) sau (Resnick 1999, cap. 4). El spune că variabile aleatoare construite din blocuri disjuncte de v.a. independente sunt independente: dacă \(X_1,\dots,X_5\) sunt independente, atunci \(X_1+X_2^2\), \(\max(X_3,X_4)\) și \(e^{X_5}\) sunt independente (blocurile \(T_1=\{1,2\}\), \(T_2=\{3,4\}\), \(T_3=\{5\}\); fiecare dintre cele trei variabile este măsurabilă în raport cu \(\sigma\)-algebra blocului ei). Să justificăm măsurabilitatea pentru primul bloc, cu \(\F_{T_1}=\sigma(X_1,X_2)\) și \(Y=g(X_1,X_2)\), \(g:\R^2\to\R\) boreliană. Familia \(\mathcal{H}=\{C\in\B(\R^2):\ \{(X_1,X_2)\in C\}\in\F_{T_1}\}\) este o \(\sigma\)-algebră (preimaginea comută cu complementara și cu reuniunile numărabile) și conține dreptunghiurile \(B_1\times B_2\), pentru care \(\{(X_1,X_2)\in B_1\times B_2\}=\{X_1\in B_1\}\cap\{X_2\in B_2\}\in\F_{T_1}\); cum dreptunghiurile generează \(\B(\R^2)\), \(\mathcal{H}=\B(\R^2)\). Atunci, pentru orice \(B\in\B(\R)\), \(\{Y\in B\}=\{(X_1,X_2)\in g^{-1}(B)\}\in\F_{T_1}\), adică \(\sigma(Y)\subseteq\F_{T_1}\). Propoziția 19 dă independența \(\sigma\)-algebrelor \(\F_{T_1},\F_{T_2},\F_{T_3}\), deci și a sub-\(\sigma\)-algebrelor generate de cele trei variabile. Blocurile pot fi și infinite: mai jos, fiecare uniformă \(U_n\) este o funcție de un bloc infinit de variabile Bernoulli, linia \(n\) a tabloului.
Demonstrație.Demonstrația Propoziției 17. Ideea. Liniile tabloului folosesc blocuri disjuncte de variabile independente, deci (asociativitatea) produc v.a. independente; pe fiecare linie, sumele parțiale sunt uniforme pe o grilă din ce în ce mai fină.
Pasul 2a (buna definire; legătura cu sumele parțiale). Seria care definește \(U_n\) are termenii nenegativi, majorați de \(2^{-k}\), iar \(\sum_{k\ge1}2^{-k}=1\); din criteriul comparației, ea converge în fiecare \(\omega\), iar \(U_n(\omega)\in[0,1]\). Fie \(S_{n,k}=\sum_{i=1}^kX_{n,i}2^{-i}\) sumele parțiale. Termenii fiind nenegativi, șirul \(\big(S_{n,k}(\omega)\big)_k\) este crescător, cu limita \(U_n(\omega)\). De aici, pentru orice \(x\in\R\), evenimentele \(\{S_{n,k}\le x\}\) descresc cu \(k\) și \[
\{U_n\le x\}=\bigcap_{k\ge1}\{S_{n,k}\le x\}
\tag{6}\] (dacă \(U_n\le x\), atunci fiecare \(S_{n,k}\le U_n\le x\); reciproc, dacă toate sumele parțiale sunt cel mult \(x\), atunci și limita lor este cel mult \(x\)).
Pasul 2b (măsurabilitatea și independența). Fie \(T_n=\phi\big(\{n\}\times\N^*\big)\) mulțimea indicilor variabilelor de pe linia \(n\) și \(\F_{T_n}=\sigma\big(X_m:\ m\in T_n\big)=\sigma\big(\bigcup_{m\in T_n}\sigma(X_m)\big)\).
Mulțimile \(T_n\), \(n\ge1\), sunt disjuncte două câte două: dacă \(m\in T_n\cap T_{n'}\), atunci \(m=\phi(n,k)=\phi(n',k')\) și, \(\phi\) fiind injectivă, \((n,k)=(n',k')\), deci \(n=n'\).
\(U_n\) este \(\F_{T_n}\)-măsurabilă. Suma \(S_{n,k}\) este determinată de valorile \(x_1,\dots,x_k\in\{0,1\}\) ale variabilelor \(X_{n,1},\dots,X_{n,k}\), deci \[
\{S_{n,k}\le x\}=\bigcup_{\substack{(x_1,\dots,x_k)\in\{0,1\}^k\\ \sum_ix_i2^{-i}\le x}}\ \bigcap_{i=1}^k\{X_{n,i}=x_i\}
\] este o reuniune finită de intersecții finite de evenimente din \(\sigma(X_{n,i})\subseteq\F_{T_n}\), deci aparține lui \(\F_{T_n}\). Din (6), \(\{U_n\le x\}\) este o intersecție numărabilă de evenimente din \(\F_{T_n}\), deci \(\{U_n\le x\}\in\F_{T_n}\) pentru orice \(x\in\R\). Criteriul de măsurabilitate cu semidrepte (Cursul 1, după Definiția 11 din Cursul 1), aplicat cu \(\sigma\)-algebra \(\F_{T_n}\) în locul lui \(\F\), arată că \(\{U_n\in B\}\in\F_{T_n}\) pentru orice \(B\in\B(\R)\): \(U_n\) este o variabilă aleatoare și \(\sigma(U_n)\subseteq\F_{T_n}\).
Independența. Variabilele \((X_m)_{m\ge1}\) fiind independente, familia \(\{\sigma(X_m):m\ge1\}\) este independentă (Definiția 18 și comentariul care o urmează). Aplicăm Propoziția 19 acestei familii și mulțimilor disjuncte \(\{T_n:n\ge1\}\): \(\sigma\)-algebrele \(\F_{T_n}\), \(n\ge1\), sunt independente, deci și sub-\(\sigma\)-algebrele lor \(\sigma(U_n)\) sunt independente, adică \((U_n)_{n\ge1}\) sunt v.a. independente.
Pasul 2c (reducerea la sume finite). Rămâne să arătăm că \(\PP(U_n\le x)=x\) pentru \(0\le x<1\) (pentru \(x<0\) și \(x\ge1\) probabilitatea este \(0\), respectiv \(1\), deoarece \(U_n\in[0,1]\)). Evenimentele \(\{S_{n,k}\le x\}\) descresc către \(\{U_n\le x\}\), conform (6), deci, din continuitatea probabilității pe șiruri descrescătoare (Propoziția 3 din Cursul 1), \(\PP(U_n\le x)=\lim_{k\to\infty}\PP(S_{n,k}\le x)\).
Pasul 2d (repartiția sumelor finite).\(S_{n,k}=\big(2^{k-1}X_{n,1}+2^{k-2}X_{n,2}+\dots+X_{n,k}\big)/2^k\) ia valorile \(j/2^k\), \(j=0,1,\dots,2^k-1\), unde \(j\) are scrierea binară \(x_1x_2\dots x_k\), cu \(x_i\) valoarea lui \(X_{n,i}\). Scrierea binară fiind unică, din independența variabilelor \(X_{n,1},\dots,X_{n,k}\) (indici distincți), \[
\PP\Big(S_{n,k}=\frac{j}{2^k}\Big)=\PP(X_{n,1}=x_1,\dots,X_{n,k}=x_k)=\prod_{i=1}^k\PP(X_{n,i}=x_i)=\frac1{2^k}:
\]\(S_{n,k}\) este uniform repartizată pe grila \(\{0,1/2^k,\dots,(2^k-1)/2^k\}\). Numărul valorilor \(j\in\{0,\dots,2^k-1\}\) cu \(j/2^k\le x\), adică \(0\le j\le x2^k\), este \(\lfloor x2^k\rfloor+1\) (pentru \(0\le x<1\)), deci \[
\PP(S_{n,k}\le x)=\frac{\lfloor x2^k\rfloor+1}{2^k}.
\] De exemplu, pentru \(x=0.3\) și \(k=3\): valorile grilei cel mult egale cu \(0.3\) sunt \(0,\frac18,\frac28\), deci \(\PP(S_{n,3}\le0.3)=\frac38=\frac{\lfloor2.4\rfloor+1}{8}\).
Pasul 2e (limita). Din \(x2^k-1<\lfloor x2^k\rfloor\le x2^k\) rezultă \[
x<\frac{\lfloor x2^k\rfloor+1}{2^k}\le x+\frac1{2^k}\xrightarrow[k\to\infty]{}x .
\] Așadar \(\PP(U_n\le x)=x\) pentru \(x\in[0,1)\), adică \(U_n\sim\Unif(0,1)\).■
Ultimul pas este exact punctul 1 al Teoremei 12, aplicat fiecărei uniforme.
Demonstrație.Demonstrația Teoremei 14. Ideea. Fiecare repartiție \(\mu_n\) este descrisă de funcția ei de repartiție \(F_n\); transformăm uniforma \(U_n\) de la Pasul 2 prin funcția cuantilă \(F_n^{-1}\). Repartiția cerută rezultă din universalitatea repartiției uniforme, iar independența se păstrează, deoarece fiecare \(X_n\) este o funcție doar de \(U_n\).
Fie \((\mu_n)_{n\ge1}\) oarecare și \(F_n(x)=\mu_n\big((-\infty,x]\big)\). \(F_n\) este funcția de repartiție a identității \(x\mapsto x\) pe câmpul \(\big(\R,\B(\R),\mu_n\big)\), deci are proprietățile din Propoziția 14 din Cursul 1, iar funcția cuantilă \(F_n^{-1}\) (Definiția 7) are proprietățile din Lema 8 și din Propoziția 9. Pe \(\big([0,1),\B([0,1)),\lambda\big)\) considerăm șirul \((U_n)_{n\ge1}\) din Propoziția 17 și definim \[
X_n=h_n(U_n),\qquad h_n(u)=\begin{cases}F_n^{-1}(u), & u\in(0,1),\\ 0, & u\in\{0,1\},\end{cases}\qquad n\ge1,
\] adică \(X_n=F_n^{-1}(U_n)\), cu o valoare constantă arbitrară (aici \(0\)) pe mulțimea de probabilitate nulă \(\{U_n\in\{0,1\}\}\).
Pasul 3a (măsurabilitatea). Pentru orice \(x\in\R\), \(\{u\in[0,1]:\ h_n(u)\le x\}\) este reuniunea dintre \(\{u\in(0,1):\ F_n^{-1}(u)\le x\}=(0,F_n(x)]\cap(0,1)\) (Lema 8) și o submulțime a lui \(\{0,1\}\), deci este o mulțime boreliană: \(h_n\) este boreliană, iar \(X_n=h_n\circ U_n\) este o variabilă aleatoare, deoarece \(\{X_n\in B\}=\{U_n\in h_n^{-1}(B)\}\) și \(h_n^{-1}(B)\) este boreliană pentru orice \(B\in\B(\R)\).
Pasul 3b (repartiția). Fie \(x\in\R\). Cum \(\PP(U_n\in\{0,1\})=0\) și, pe \(\{U_n\in(0,1)\}\), \(X_n\le x\iff F_n^{-1}(U_n)\le x\iff U_n\le F_n(x)\) (Lema 8), obținem, exact ca la Pasul 1 al demonstrației Teoremei 12, \[
\PP(X_n\le x)=\PP\big(U_n\le F_n(x),\ U_n\in(0,1)\big)=\PP\big(U_n\le F_n(x)\big)=F_n(x),
\] ultima egalitate deoarece \(U_n\sim\Unif(0,1)\) și \(F_n(x)\in[0,1]\). Așadar repartiția \(\PP\circ X_n^{-1}\) a lui \(X_n\) și probabilitatea \(\mu_n\) coincid pe toate semidreptele \((-\infty,x]\); cum funcția de repartiție determină repartiția (fapt admis în Cursul 1), \(\PP\circ X_n^{-1}=\mu_n\).
Pasul 3c (independența).\(X_n\) este o funcție boreliană doar de \(U_n\). Fie \(m\ge2\) și \(B_1,\dots,B_m\in\B(\R)\); notăm \(C_i=h_i^{-1}(B_i)\), mulțimi boreliene (Pasul 3a), pentru care \(\{X_i\in B_i\}=\{U_i\in C_i\}\). Atunci \[
\PP(X_1\in B_1,\dots,X_m\in B_m)=\PP(U_1\in C_1,\dots,U_m\in C_m)=\prod_{i=1}^m\PP(U_i\in C_i)=\prod_{i=1}^m\PP(X_i\in B_i),
\] unde a doua egalitate este independența variabilelor \(U_i\) (Pasul 2). Același calcul, scris pentru indici distincți oarecare \(n_1,\dots,n_m\) în locul lui \(1,\dots,m\), arată că orice subfamilie finită a șirului \((X_n)_{n\ge1}\) este independentă, deci variabilele \(X_n\) sunt independente. Am construit astfel, pe \(\big([0,1),\B([0,1)),\lambda\big)\), un șir de v.a. independente cu repartițiile \(\mu_n\), ceea ce încheie demonstrația.■
Observație
Discuție. (1) Un singur număr\(\omega\) ales uniform în \([0,1)\) conține suficient „aleatorism” pentru a genera un șir infinit de variabile independente cu orice repartiții dorite. (2) Independența de la Pasul 2 provine din disjuncția liniilor tabloului (asociativitatea), uniformitatea din faptul că fiecare linie este un șir de aruncări echilibrate independente, iar Pasul 3 folosește doar proprietățile (a)–(c) ale fiecărei \(F_n\). (3) Pe un calculator, generatoarele de numere pseudo-aleatoare (Cursul 4) imită direct un șir i.i.d. \(\Unif(0,1)\), iar Pasul 3 devine metoda inversă de simulare. (4) Teorema de extensie a lui Kolmogorov asigură, mai general, existența unui șir de v.a. cu orice familie compatibilă de repartiții finit-dimensionale, nu neapărat independente; demonstrația ei folosește teoreme de extensie a măsurilor și depășește cadrul cursului (Durrett 2019, sec. 2.1).
Exemplul 17(Pasul 3 pentru același omega)
Continuăm Exemplul 16 și alegem trei repartiții: \(\mu_1=\Exp(1)\), \(\mu_2=\Pois(3)\) și \(\mu_3\), repartiția variabilei cu patru valori din Exemplul 10(b). Atunci \(X_n(\omega)=F_n^{-1}\big(U_n(\omega)\big)\) și, funcțiile cuantilă fiind crescătoare (punctul 1 al Propoziției 9), încadrările lui \(U_n(\omega)\) dau încadrări ale lui \(X_n(\omega)\).
\(X_1=-\ln(1-U_1)\) (Exemplul 9(b)): din \(U_1(\omega)\in[0.40625,\,0.4375]\) rezultă \(X_1(\omega)\in[-\ln0.59375,\,-\ln0.5625]\approx[0.521,\,0.575]\); cu valoarea mai precisă \(U_1(\omega)\approx0.4220\) obținem \(X_1(\omega)\approx0.548\).
\(X_2=F_2^{-1}(U_2)\), cu \(F_2\) funcția de repartiție \(\Pois(3)\): din tabelul din Exemplul 10, \(F_2(0)\approx0.0498<0.0625\le U_2(\omega)\le0.125\le F_2(1)\approx0.1991\), deci \(X_2(\omega)=1\). Patru cifre binare au fost de ajuns pentru a determina exact valoarea.
\(X_3=F_3^{-1}(U_3)\): sumele cumulate sunt \(s_1=0.1\) și \(s_2=0.5\), iar \(s_1<0.125\le U_3(\omega)\le0.25\le s_2\), deci \(X_3(\omega)=1\).
Din singurul număr \(\omega=\pi-3\) am obținut valorile \(X_1(\omega)\approx0.548\), \(X_2(\omega)=1\), \(X_3(\omega)=1,\ \dots\) Pentru un alt \(\omega\) am fi obținut alte valori; repartițiile \(\Exp(1)\), \(\Pois(3)\), \(\mu_3,\ \dots\) și independența descriu felul în care aceste valori variază atunci când \(\omega\) parcurge intervalul \([0,1)\).
Ilustrăm Pașii 2 și 3 în R: din cifrele binare ale unui singur număr \(\omega\) construim două variabile uniforme (din cifrele de rang impar, respectiv par: un tablou cu două linii, pentru care nu avem nevoie de bijecția lui Cantor) și le transformăm prin funcțiile cuantilă ale repartițiilor \(\Exp(1)\) și \(\Pois(3)\).
# primele K cifre binare ale lui omegacifre <-function(omega, K =30) floor(omega *2^(1:K)) %%2set.seed(9)omega <-runif(5000)D <-t(sapply(omega, cifre)) # matrice 5000 x 30U1 <-as.vector(D[, seq(1, 29, by =2)] %*%2^-(1:15)) # cifrele de rang imparU2 <-as.vector(D[, seq(2, 30, by =2)] %*%2^-(1:15)) # cifrele de rang parc(medie_U1 =mean(U1), var_U1 =var(U1), teoretic =1/12,corelatie =cor(U1, U2))
Folosim doar primele \(30\) de cifre binare: generatorul din R produce numere cu o rezoluție de aproximativ \(2^{-32}\); cu \(15\) cifre pe linie, \(U_1\) și \(U_2\) sunt uniforme pe o grilă de pas \(2^{-15}\). Media și varianța empirice ale lui \(U_1\) sunt apropiate de \(1/2\) și \(1/12\approx0.0833\), corelația empirică dintre \(U_1\) și \(U_2\) este de ordinul fluctuațiilor de eșantionare \(1/\sqrt{5\,000}\approx0.014\), iar mediile lui \(X_1=F^{-1}_{\Exp(1)}(U_1)\) și \(X_2=F^{-1}_{\Pois(3)}(U_2)\) sunt apropiate de \(1\) și \(3\).
Încheiem secțiunea cu o construcție directă, în care ideea Pasului 1 apare sub o altă formă: după ce am „folosit” intervalul care îl conține pe \(\omega\), poziția relativă a lui \(\omega\) în acel interval rămâne uniformă și independentă de alegerea intervalului.
Exemplul 18(Două variabile independente dintr-un singur număr uniform)
Pe \(\big([0,1),\B([0,1)),\lambda\big)\) fie \(X=\Ind_{[0,0.3)}\) și \[
V(\omega)=\begin{cases}\omega/0.3, & \omega<0.3,\\ (\omega-0.3)/0.7, & \omega\ge0.3\end{cases}
\] (poziția relativă a lui \(\omega\) în intervalul care îl conține). Arătăm că \(X\sim\Bern(0.3)\), \(V\sim\Unif(0,1)\) și că \(X\) și \(V\) sunt independente.
Repartiția lui \(X\).\(\PP(X=1)=\lambda\big([0,0.3)\big)=0.3\) și \(\PP(X=0)=0.7\), deci \(X\sim\Bern(0.3)\).
Repartiția comună.\(V\) ia valori în \([0,1)\). Fie \(v\in[0,1]\). Pe \(\{X=1\}=[0,0.3)\) avem \(V\le v\iff\omega\le0.3v\), iar pe \(\{X=0\}=[0.3,1)\) avem \(V\le v\iff\omega\le0.3+0.7v\); deci \[
\begin{aligned}
\PP(X=1,V\le v)&=\lambda\big([0,0.3v]\cap[0,0.3)\big)=0.3\,v,\\
\PP(X=0,V\le v)&=\lambda\big([0.3,0.3+0.7v]\cap[0.3,1)\big)=0.7\,v .
\end{aligned}
\] Adunând, \(\PP(V\le v)=0.3v+0.7v=v\) pentru \(v\in[0,1]\); cum \(V\in[0,1)\), \(\PP(V\le v)=0\) pentru \(v<0\) și \(1\) pentru \(v>1\). Deci \(V\sim\Unif(0,1)\) și, pentru orice \(v\in\R\) și \(i\in\{0,1\}\), \[
\PP(X=i,\ V\le v)=\PP(X=i)\,\PP(V\le v)
\] (pentru \(v\in[0,1]\) este calculul de mai sus, cu \(\PP(X=1)=0.3\) și \(\PP(X=0)=0.7\); pentru \(v<0\) ambii membri sunt \(0\), iar pentru \(v>1\) ambii sunt egali cu \(\PP(X=i)\)).
Independența. Fixăm \(i\in\{0,1\}\). Funcția \(B\mapsto\nu_i(B)=\PP(V\in B\mid X=i)=\PP(X=i,\ V\in B)/\PP(X=i)\) este o probabilitate pe \(\big(\R,\B(\R)\big)\), anume repartiția lui \(V\) în raport cu probabilitatea condiționată \(\PP(\,\cdot\mid X=i)\) (care este o probabilitate, deoarece \(\PP(X=i)>0\); Propoziția 5 din Cursul 1), iar relația precedentă spune că funcția ei de repartiție, \(v\mapsto\nu_i\big((-\infty,v]\big)\), coincide cu funcția de repartiție a lui \(V\). Cum funcția de repartiție determină repartiția (fapt admis în Cursul 1), \(\nu_i(B)=\PP(V\in B)\) pentru orice \(B\in\B(\R)\), adică \(\PP(X=i,\ V\in B)=\PP(X=i)\,\PP(V\in B)\). Pentru \(A\in\B(\R)\) oarecare, sumând după valorile \(i\in A\cap\{0,1\}\), obținem \(\PP(X\in A,\ V\in B)=\PP(X\in A)\,\PP(V\in B)\): variabilele \(X\) și \(V\) sunt independente.
O pereche independentă cu repartiții date. Fie \(Y=-\ln(1-V)\); pe evenimentul \(\{V\in(0,1)\}\), de probabilitate \(1\), \(Y\) este funcția cuantilă a repartiției \(\Exp(1)\) aplicată lui \(V\) (Exemplul 11), deci, din punctul 1 al Teoremei 12, \(Y\sim\Exp(1)\). Cum \(Y\) este o funcție boreliană de \(V\), iar \(X\) și \(V\) sunt independente, Propoziția 39 din Cursul 1 arată că \(X\) și \(Y\) sunt independente: dintr-un singur număr \(\omega\) am construit o variabilă Bernoulli și o variabilă exponențială independente.
6 Exerciții rezolvate
Exercițiile următoare aplică rezultatele din ambele părți ale cursului: primele două, formulele pentru selecția fără revenire (cu verificare în R), al treilea, funcția cuantilă și universalitatea repartiției uniforme, iar ultimul leagă cele două părți, construind o selecție fără revenire din numere uniforme.
Exercițiul 1(Estimarea mediei și a totalului unui lot)
Un lot conține \(N=40\) de cutii. Din lot se extrag, prin selecție simplă fără revenire, \(n=8\) cutii, în care se numără piesele defecte: \(12,\ 15,\ 9,\ 14,\ 11,\ 16,\ 13,\ 10\). (a) Estimați numărul mediu de piese defecte pe cutie și eroarea standard a estimatorului. (b) Estimați numărul total de piese defecte din lot și eroarea standard corespunzătoare. (c) Cât ar fi fost eroarea standard estimată dacă am fi ignorat faptul că selecția este fără revenire?
Soluție
Modelul. Cele \(N=40\) de cutii formează o populație finită: valoarea \(u_j\) a cutiei \(j\) este numărul ei de piese defecte, iar media \(\mu\) și totalul \(\tau=N\mu\) sunt necunoscute. Cele opt numere observate sunt valorile \(x_1,\dots,x_8\) ale variabilelor \(X_1,\dots,X_8\) dintr-o selecție simplă fără revenire. Suntem în cadrul Teoremei 5, cu \(N=40\), \(n=8\) și fracția de selecție \(f=8/40=0.2\) (mare, deci corecția contează). Cum \(\sigma^2\) este necunoscută, varianța lui \(\Xbar\) nu poate fi calculată, ci doar estimată, cu ajutorul Corolarului 6.
Ce se cere: o estimare a lui \(\mu\) și eroarea ei standard, adică o estimare a abaterii standard \(\sqrt{\Var(\Xbar)}\) a estimatorului.
Pasul 1 (media).\(\sum_ix_i=12+15+9+14+11+16+13+10=100\), deci \(\bar x=100/8=12.5\); estimatorul \(\Xbar\) este nedeplasat pentru \(\mu\) (Teorema 5(c)).
Pasul 2 (varianța eșantionului). Abaterile \(x_i-\bar x\) sunt \(-0.5,\ 2.5,\ -3.5,\ 1.5,\ -1.5,\ 3.5,\ 0.5,\ -2.5\) (suma lor este \(0\), verificare), cu pătratele \(0.25,\ 6.25,\ 12.25,\ 2.25,\ 2.25,\ 12.25,\ 0.25,\ 6.25\) și suma \(42\). Deci \(s^2=\frac{42}{8-1}=6\). Aceeași sumă se obține din Lema 3 cu \(c=0\): \(\sum_ix_i^2=144+225+81+196+121+256+169+100=1292\) și \(1292-8\cdot12.5^2=1292-1250=42\).
Pasul 3 (eroarea standard). Din Corolarul 6, \[
\widehat{\Var}(\Xbar)=(1-f)\frac{s^2}{n}=0.8\cdot\frac68=0.6,\qquad \widehat{\mathrm{es}}(\Xbar)=\sqrt{0.6}\approx0.775 .
\]Numărul mediu de piese defecte pe cutie este deci estimat la \(12.5\), cu o eroare tipică de aproximativ \(0.8\). Marja de eroare \(1.96\cdot0.775\approx1.5\) este aici doar orientativă: pentru \(n=8\) aproximarea normală a repartiției lui \(\Xbar\) este grosieră.
Ce se cere: o estimare a totalului \(\tau=N\mu\) și eroarea ei standard. Folosim a doua parte a Corolarului 6: \(N\Xbar\) este nedeplasat pentru \(\tau\) și \(\Var(N\Xbar)=N^2\Var(\Xbar)\), deci varianța se estimează prin \(N^2\,\widehat{\Var}(\Xbar)\). Obținem \(\hat\tau=N\bar x=40\cdot12.5=500\) de piese defecte, cu varianța estimată \(40^2\cdot0.6=960\) și eroarea standard estimată \(\sqrt{960}=40\cdot0.7746\approx30.98\). Trecerea de la medie la total înmulțește cu \(N\) atât estimarea, cât și eroarea standard; precizia relativă este aceeași, \(0.775/12.5=30.98/500\approx6.2\%\).
Ce se cere: eroarea standard pe care am fi raportat-o tratând observațiile ca pe un eșantion i.i.d., adică \(S_n/\sqrt n\). Ignorând corecția (\(f=0\)), eroarea standard estimată ar fi \(\sqrt{s^2/n}=\sqrt{0.75}\approx0.866\), cu aproximativ \(11.8\%\) mai mare: raportul este \(1/\sqrt{1-f}=1/\sqrt{0.8}\approx1.118\). Precizia reală este deci mai bună decât ar indica formula i.i.d.; pentru un lot mare (\(N\to\infty\) la \(n\) fixat), diferența dispare.
Verificare în R. Codul calculează, în ordine: media, varianța eșantionului (funcția var folosește numitorul \(n-1\)), eroarea standard cu corecție, estimarea totalului, eroarea ei standard și eroarea standard fără corecție.
x <-c(12, 15, 9, 14, 11, 16, 13, 10); N <-40; n <-length(x); f <- n / Nc(medie =mean(x), s2 =var(x), es =sqrt((1- f) *var(x) / n),total = N *mean(x), es_total = N *sqrt((1- f) *var(x) / n),es_fara_corectie =sqrt(var(x) / n))
#>            medie               s2               es            total
#>          12.5000           6.0000           0.7746         500.0000
#>         es_total es_fara_corectie
#>          30.9839           0.8660
Valorile afișate, \(12.5\), \(6\), \(0.775\), \(500\), \(30.98\) și \(0.866\), sunt cele obținute de mână la punctele (a), (b) și (c).
Exercițiul 2(Un sondaj într-o populație mică)
Într-o facultate sunt \(N=1\,200\) de studenți, dintre care o proporție \(p=0.3\) lucrează. Se aleg fără revenire \(n=150\) de studenți și se calculează proporția \(\hat p\) a celor care lucrează. (a) Calculați abaterea standard a lui \(\hat p\) și comparați-o cu cea de la selecția cu revenire. (b) Aproximați \(\PP(|\hat p-p|\le0.05)\) cu ajutorul unei aproximări normale și comparați cu valoarea exactă (hipergeometrică). (c) Ce volum de eșantion (fără revenire) garantează, în cel mai defavorabil caz \(p=1/2\), o marjă de eroare \(0.05\) cu probabilitatea aproximativă \(0.95\)?
Soluție
Modelul. Populația este formată din cei \(N=1\,200\) de studenți, cu \(u_j=1\) dacă studentul \(j\) lucrează și \(u_j=0\) altfel; proporția \(\hat p\) din eșantion este media eșantionului, \(\hat p=\Xbar\).
Ce se cere și ce folosim. Abaterea standard a lui \(\hat p=\Xbar\) în cele două planuri: Propoziția 4 pentru selecția cu revenire și relația (2) pentru cea fără revenire. Din Exemplul 4, pentru o populație de valori \(0\) și \(1\), \(\mu=p=0.3\) și \(\sigma^2=p(1-p)=0.3\cdot0.7=0.21\). Cu revenire, \(\Var(\hat p)=\sigma^2/n=0.21/150=0.0014\), deci abaterea standard este \(\sqrt{0.0014}\approx0.03742\). Fără revenire, factorul de corecție este \(\frac{N-n}{N-1}=\frac{1050}{1199}\approx0.8757\), deci \[
\Var(\hat p)=0.0014\cdot0.8757\approx0.001226,\qquad \sqrt{\Var(\hat p)}\approx0.03501 .
\]Deci abaterea standard a lui \(\hat p\) este \(\approx0.0350\) fără revenire, față de \(\approx0.0374\) cu revenire. Fracția de selecție este \(f=150/1200=12.5\%\), iar abaterea standard scade cu aproximativ \(6.4\%\) (\(\sqrt{0.8757}\approx0.936\)).
Ce se cere: probabilitatea ca proporția din eșantion să se abată de la cea reală cu cel mult \(5\) puncte procentuale. Traducerea evenimentului. Fie \(Y=150\,\hat p\) numărul studenților din eșantion care lucrează, cu \(\E[Y]=150\cdot0.3=45\). Atunci \[
|\hat p-0.3|\le0.05\iff|Y-45|\le7.5\iff37.5\le Y\le52.5\iff38\le Y\le52
\] (am înmulțit inegalitatea cu \(150\); ultima echivalență are loc deoarece \(Y\) ia valori întregi).
Aproximarea normală.\(Y=150\hat p\) este o sumă de \(150\) de v.a. dependente, deci Teorema 64 din Cursul 1 nu se aplică direct. Admitem aici, fără demonstrație, o variantă a TLC pentru selecția fără revenire, datorată lui Hájek, a cărei demonstrație depășește cadrul cursului: pentru \(N\) și \(n\) mari și \(f\) nu prea aproape de \(1\), \((\hat p-p)/\sqrt{\Var(\hat p)}\) este aproximativ \(\Norm(0,1)\)(Rice 2007, sec. 7.3); mai jos comparăm aproximarea cu valoarea exactă. Împărțim inegalitatea \(|\hat p-0.3|\le0.05\) la abaterea standard de la (a) și folosim, pentru \(Z\sim\Norm(0,1)\), \(\PP(|Z|\le z)=\Phi(z)-\Phi(-z)=2\Phi(z)-1\) (din \(\Phi(-z)=1-\Phi(z)\), Exemplul 9(d)): \[
\PP(|\hat p-0.3|\le0.05)=\PP\Big(\frac{|\hat p-0.3|}{0.03501}\le\frac{0.05}{0.03501}\Big)\approx2\Phi(1.428)-1\approx2\cdot0.92335-1=0.8467 .
\]Valoarea exactă.\(Y\sim\HGeom(1200,360,150)\) (sunt \(K=0.3\cdot1200=360\) de studenți care lucrează), iar evenimentul este \(\{38\le Y\le52\}\). Calculul în R dă \(\PP(38\le Y\le52)\approx0.8472\), foarte aproape de aproximarea \(0.8467\). (Capetele evenimentului \(\{|Y-45|\le7.5\}\) sunt deja la jumătatea distanței dintre două valori întregi, deci aproximarea normală include automat corecția de continuitate.) Dacă am fi folosit formula i.i.d. (binomială), am fi obținut \(2\Phi(0.05/0.03742)-1\approx0.8186\) (exact binomial: \(\approx0.8189\)), subestimând probabilitatea.
Ce se cere: cel mai mic \(n\) pentru care marja de eroare este cel mult \(0.05\), oricare ar fi \(p\). Marja de eroare (la probabilitatea aproximativă \(0.95\)) este \(z_{0.975}\sqrt{\Var(\hat p)}\), cu \(\Var(\hat p)=\frac{p(1-p)}{n}\cdot\frac{N-n}{N-1}\). Proporția \(p\) fiind necunoscută înaintea sondajului, ne asigurăm în cazul cel mai defavorabil: \(p(1-p)=\frac14-\big(p-\frac12\big)^2\le\frac14\), cu egalitate pentru \(p=\frac12\). Cerem deci \[
z_{0.975}\sqrt{\frac{1}{4n}\cdot\frac{N-n}{N-1}}\le0.05 .
\] Notând \(n_0=z_{0.975}^2\cdot\frac14/0.05^2=\frac{1.959964^2}{4\cdot0.0025}\approx384.15\) (volumul necesar pentru o populație infinită), condiția devine \[
\begin{aligned}
\frac{N-n}{n(N-1)}\le\frac{1}{n_0}&\iff\frac Nn-1\le\frac{N-1}{n_0}\iff\frac Nn\le1+\frac{N-1}{n_0}\\
&\iff n\ge\frac{N\,n_0}{n_0+N-1}=\frac{1200\cdot384.15}{384.15+1199}\approx291.2 .
\end{aligned}
\] Deci \(n=292\) (verificare: marja pentru \(n=292\) este \(\approx0.04991\le0.05\), iar pentru \(n=291\) este \(\approx0.05002>0.05\)). Corecția pentru populație finită reduce volumul necesar de la \(385\) la \(292\), o economie de aproape un sfert.
Verificare în R. Primul rezultat conține abaterile standard de la (a) și, pentru fiecare plan, probabilitatea de la (b) calculată prin aproximarea normală și exact (phyper pentru repartiția hipergeometrică, pbinom pentru cea binomială; \(\PP(38\le Y\le52)=F(52)-F(37)\)). Al doilea rezultat conține \(n_0\), pragul pentru \(n\) și marjele de eroare pentru \(n=291\) și \(n=292\).
N <-1200; n <-150; p <-0.3v_cu <- p * (1- p) / n; v_fara <- v_cu * (N - n) / (N -1)c(es_cu =sqrt(v_cu), es_fara =sqrt(v_fara),aprox_fara =2*pnorm(0.05/sqrt(v_fara)) -1,exact_fara =phyper(52, 360, 840, n) -phyper(37, 360, 840, n),aprox_cu =2*pnorm(0.05/sqrt(v_cu)) -1,exact_cu =pbinom(52, n, p) -pbinom(37, n, p))
Citim: abaterile standard \(0.0374\) și \(0.0350\); fără revenire, aproximarea normală \(0.8467\) față de valoarea exactă \(0.8472\); cu revenire, \(0.8186\) față de \(0.8189\). Pe a doua linie, \(n_0\approx384.1\), pragul \(291.2\) și marjele \(0.05002\) (pentru \(n=291\), prea mare) și \(0.04991\) (pentru \(n=292\)).
Exercițiul 3(Timpi de funcționare cenzurați)
Timpul de funcționare \(Y\) al unei componente are repartiția \(\Exp(1)\), dar observăm doar \(X=\min(Y,2)\). Determinați funcția de repartiție și funcția cuantilă ale lui \(X\), mediana și cuantila de ordin \(0.9\), și arătați că \(F_X(X)\) nu este uniformă.
Soluție
Ce se cere și ce folosim. Variabila \(X\) este de tip mixt: continuă pe \([0,2)\), cu un atom în \(2\) (toate componentele care funcționează mai mult de \(2\) unități de timp sunt înregistrate cu valoarea \(2\)). Calculăm \(F_X\) direct din definiție, apoi \(F_X^{-1}\) cu metoda din Exemplele 6 și 7: pe zone de niveluri, determinând mulțimea \(\{x:\ F_X(x)\ge u\}\).
Funcția de repartiție.\(X=\min(Y,2)\) ia valori în \([0,2]\). Pentru \(x<0\), \(F_X(x)=0\). Pentru \(0\le x<2\), cum \(2>x\), avem \(\min(Y,2)\le x\iff Y\le x\), deci \(F_X(x)=\PP(Y\le x)=1-e^{-x}\). Pentru \(x\ge2\), \(\min(Y,2)\le2\le x\) întotdeauna, deci \(F_X(x)=1\). Funcția \(F_X\) are un salt în \(x_0=2\): \(F_X(2-)=1-e^{-2}\approx0.8647\) și \(F_X(2)=1\), adică \(\PP(X=2)=\PP(Y\ge2)=e^{-2}\approx0.1353\) (Propoziția 14 din Cursul 1).
Funcția cuantilă. Fie \(u\in(0,1)\); pragul care desparte zonele este \(F_X(2-)=1-e^{-2}\approx0.8647\).
Dacă \(u<1-e^{-2}\): pe \((0,2)\), \(F_X\) este continuă și strict crescătoare, cu valori în \((0,1-e^{-2})\), iar ecuația \(1-e^{-x}=u\) are soluția \(x_u=-\ln(1-u)\in(0,2)\). Pentru \(x<x_u\) avem \(F_X(x)<u\), iar pentru \(x\ge x_u\) avem \(F_X(x)\ge u\); deci \(\{x:\ F_X(x)\ge u\}=[x_u,\infty)\) și \(F_X^{-1}(u)=-\ln(1-u)\).
Dacă \(u=1-e^{-2}\): \(F_X(x)<u\) pentru orice \(x<2\) și \(F_X(2)=1\ge u\), deci \(F_X^{-1}(u)=2=-\ln(e^{-2})\).
Dacă \(u\in(1-e^{-2},1)\): din nou \(F_X(x)\le1-e^{-2}<u\) pentru \(x<2\) și \(F_X(2)=1\ge u\), deci \(F_X^{-1}(u)=2\); este Corolarul 10(a), cu \(x_0=2\). În acest caz \(-\ln(1-u)>2\).
În toate cazurile, \[
F_X^{-1}(u)=\min\big(-\ln(1-u),\,2\big),\qquad u\in(0,1):
\] funcția cuantilă a lui \(\min(Y,2)\) este funcția cuantilă a lui \(Y\), trunchiată la \(2\).
Cuantile. Cum \(0.5<1-e^{-2}\), mediana este \(\mathrm{Me}=-\ln(1-0.5)=\ln2\approx0.693\) (aceeași ca pentru \(Y\)); cum \(0.9>1-e^{-2}\approx0.8647\), \(q_{0.9}=2\) (pentru \(Y\) ar fi fost \(-\ln0.1\approx2.303\)). Cuantila \(q_{0.9}\) este punctul de salt, deci inegalitățile din Corolarul 11 sunt stricte: \(\PP(X\le2)=1>0.9\) și \(\PP(X\ge2)=e^{-2}\approx0.135>0.1\). Cenzurarea nu schimbă cuantilele de ordin mai mic decât \(0.8647\), dar le „turtește” pe toate celelalte în valoarea \(2\).
\(F_X(X)\) nu este uniformă.\(F_X(X)=1\) dacă și numai dacă \(X\ge2\), adică \(X=2\); deci \(\PP\big(F_X(X)=1\big)=e^{-2}>0\), pe când o variabilă uniformă ia orice valoare fixată cu probabilitatea \(0\). Este fenomenul din caseta de atenționare de după Teorema 12: \(F_X\) are un salt. În schimb, punctul 1 al teoremei rămâne valabil: dacă \(U\sim\Unif(0,1)\), atunci \(\min\big(-\ln(1-U),2\big)\) are aceeași repartiție ca \(X\). Pe scurt: \(F_X(x)=1-e^{-x}\) pentru \(0\le x<2\) și \(F_X(x)=1\) pentru \(x\ge2\); \(F_X^{-1}(u)=\min\big(-\ln(1-u),2\big)\); \(\mathrm{Me}=\ln2\approx0.693\), \(q_{0.9}=2\); \(F_X(X)\) nu este uniformă, deoarece \(\PP\big(F_X(X)=1\big)=e^{-2}>0\).
Verificarea directă a ultimei afirmații. Fie \(X'=\min\big(-\ln(1-U),2\big)\). Pentru \(0\le x<2\), \(X'\le x\iff-\ln(1-U)\le x\iff U\le1-e^{-x}\), eveniment de probabilitate \(1-e^{-x}=F_X(x)\); pentru \(x\ge2\), \(X'\le2\le x\) întotdeauna, iar pentru \(x<0\) evenimentul \(\{X'\le x\}\) este imposibil. Deci \(F_{X'}=F_X\). Atomul din \(2\) provine din toate nivelurile \(U\ge1-e^{-2}\), un interval de lungime \(e^{-2}\): \(\PP(X'=2)=\PP\big(-\ln(1-U)\ge2\big)=e^{-2}\).
Exercițiul 4(O selecție fără revenire construită din numere uniforme)
Fie \(N\ge2\) și \(U_1,U_2\) variabile aleatoare independente, uniforme pe \((0,1)\). Definim \(J_1=\lceil NU_1\rceil\), \(K=\lceil(N-1)U_2\rceil\) și \[
J_2=\begin{cases}K, & K<J_1,\\ K+1, & K\ge J_1,\end{cases}
\] adică \(J_2\) este al \(K\)-lea dintre cei \(N-1\) indivizi rămași după eliminarea lui \(J_1\). (a) Arătați că \((J_1,J_2)\) este uniform repartizat pe mulțimea celor \(N(N-1)\) perechi ordonate de indici distincți, adică formează o selecție simplă fără revenire de volum \(2\). (b) Pentru populația din Exemplul 3 (valorile \(2,4,5,7,9,15\), în această ordine), determinați eșantionul produs de \(U_1=0.62\), \(U_2=0.35\) și pe cel produs de \(U_1=0.2\), \(U_2=0.9\).
Soluție
Ce se cere și ce folosim. Trebuie să arătăm că \(\PP(J_1=k,\ J_2=l)=\frac{1}{N(N-1)}\) pentru orice indici \(k\ne l\). Folosim repartiția variabilei \(\lceil MU\rceil\) (Exemplul 13) și independența variabilelor \(U_1\) și \(U_2\).
Pasul 1 (repartiția perechii \((J_1,K)\)). Din Exemplul 13, pentru \(U\sim\Unif(0,1)\) și un întreg \(M\ge1\), variabila \(\lceil MU\rceil\) este uniformă pe \(\{1,\dots,M\}\). Deci \(J_1\) este uniformă pe \(\{1,\dots,N\}\), iar \(K\) este uniformă pe \(\{1,\dots,N-1\}\). Fiind funcții de \(U_1\), respectiv de \(U_2\), ele sunt independente (Propoziția 39 din Cursul 1), deci \[
\PP(J_1=k,\ K=m)=\frac1N\cdot\frac1{N-1},\qquad k\in\{1,\dots,N\},\ m\in\{1,\dots,N-1\}.
\]
Pasul 2 (\(J_2\) este un indice diferit de \(J_1\)). Dacă \(K<J_1\), atunci \(J_2=K<J_1\); dacă \(K\ge J_1\), atunci \(J_2=K+1>J_1\). În ambele cazuri \(J_2\ne J_1\) și \(1\le J_2\le N\) (deoarece \(K+1\le N\)).
Pasul 3 (probabilitatea unei perechi). Fixăm \(k\ne l\) în \(\{1,\dots,N\}\) și determinăm ce valoare a lui \(K\) produce \(J_2=l\) atunci când \(J_1=k\).
Dacă \(l<k\): valorile \(K\ge k\) dau \(J_2=K+1>k>l\), deci nu convin; valorile \(K<k\) dau \(J_2=K\), deci \(J_2=l\) dacă și numai dacă \(K=l\). Așadar \(\{J_1=k,\ J_2=l\}=\{J_1=k,\ K=l\}\).
Dacă \(l>k\): valorile \(K<k\) dau \(J_2=K<k<l\), deci nu convin; valorile \(K\ge k\) dau \(J_2=K+1\), deci \(J_2=l\) dacă și numai dacă \(K=l-1\) (o valoare admisibilă: \(k\le l-1\le N-1\)). Așadar \(\{J_1=k,\ J_2=l\}=\{J_1=k,\ K=l-1\}\).
În ambele cazuri, din Pasul 1, \(\PP(J_1=k,\ J_2=l)=\frac{1}{N(N-1)}\). Toate cele \(N(N-1)\) perechi ordonate de indici distincți sunt deci egal probabile: este exact repartiția din Definiția 2(ii) pentru \(n=2\). În particular, sumând după \(k\ne l\), \(\PP(J_2=l)=(N-1)\cdot\frac{1}{N(N-1)}=\frac1N\), în acord cu Teorema 5(a). Aceeași idee, repetată, produce o selecție fără revenire de orice volum \(n\): la pasul \(i\) se alege, cu un număr uniform nou, unul dintre cei \(N-i+1\) indivizi încă neextrași.
Aici \(N=6\). Pentru \(U_1=0.62\) și \(U_2=0.35\): \(J_1=\lceil6\cdot0.62\rceil=\lceil3.72\rceil=4\) și \(K=\lceil5\cdot0.35\rceil=\lceil1.75\rceil=2\); cum \(K<J_1\), \(J_2=2\). Eșantionul este format din indivizii \(4\) și \(2\), cu valorile \(u_4=7\) și \(u_2=4\) și media \(5.5\). Pentru \(U_1=0.2\) și \(U_2=0.9\): \(J_1=\lceil1.2\rceil=2\) și \(K=\lceil4.5\rceil=5\); cum \(K\ge J_1\), \(J_2=6\) (indivizii rămași sunt \(1,3,4,5,6\), iar al cincilea dintre ei este individul \(6\)). Eșantionul are valorile \(u_2=4\) și \(u_6=15\) și media \(9.5\). Ambele medii, \(5.5\) și \(9.5\), se regăsesc în tabelul eșantioanelor din Exemplul 3.
De reținut
Formulele și ideile esențiale ale cursului sunt următoarele.
Populație finită: \(\mu=\frac1N\sum_ju_j\), \(\sigma^2=\frac1N\sum_j(u_j-\mu)^2\); valorile sunt fixe, aleatorismul provine din planul de selecție.
Selecție simplă cu revenire: \(X_i\) i.i.d., \(\Var(\Xbar)=\sigma^2/n\), \(\E[S_n^2]=\sigma^2\). Fără revenire: \(\Cov(X_i,X_j)=-\frac{\sigma^2}{N-1}\), \(\Var(\Xbar)=\frac{\sigma^2}{n}\cdot\frac{N-n}{N-1}\), \(\E[S_n^2]=\frac{N}{N-1}\sigma^2\), \(\widehat{\Var}(\Xbar)=(1-f)\frac{S_n^2}{n}\), \(f=\frac nN\); pentru proporții, repartiția hipergeometrică.
Alte planuri de selecție (doar ca idee): selecția stratificată, cu estimatorul \(\sum_hW_h\bar X_h\) și cu alocarea proporțională sau alocarea Neyman; selecția sistematică; selecția pe grupuri.
Funcția cuantilă \(F^{-1}(u)=\inf\{x:F(x)\ge u\}\); lema fundamentală \(F^{-1}(u)\le x\iff u\le F(x)\); \(F^{-1}\) crescătoare și continuă la stânga; \(F(F^{-1}(u))\ge u\) (egalitate pentru \(F\) continuă), \(F^{-1}(F(x))\le x\); salturile lui \(F\) devin paliere ale lui \(F^{-1}\) și invers.
Exemple: \(F^{-1}(u)=-\frac1\lambda\ln(1-u)\) pentru \(\Exp(\lambda)\); \(F^{-1}(u)=\tan\big(\pi(u-\frac12)\big)\) pentru \(\Cauchy(0,1)\); \(F^{-1}(u)=x_k\) pentru \(s_{k-1}<u\le s_k\) în cazul discret.
Universalitatea uniformei: \(F^{-1}(U)\sim F\) pentru orice \(F\); \(F(X)\sim\Unif(0,1)\) dacă și numai dacă \(F\) este continuă.
Existență: pe \(\big([0,1),\B([0,1)),\lambda\big)\) există șiruri de v.a. independente cu orice repartiții \(\mu_n\): Bernoulli (subdiviziuni; cifrele binare pentru \(p=\frac12\)) \(\to\)\(U_n=\sum_kX_{n,k}2^{-k}\sim\Unif(0,1)\) (tabloul cu o infinitate de linii și asociativitatea independenței) \(\to\)\(X_n=F_n^{-1}(U_n)\).
R: sample(x, n, replace = ...), combn, phyper, findInterval, q+nume pentru funcțiile cuantilă.
Legătura cu cursurile următoare. Pasul 3 al teoremei de existență devine, în Cursul 4, metoda inversă de simulare: pornind de la numere pseudo-aleatoare care imită un șir i.i.d. \(\Unif(0,1)\), obținem eșantioane din orice repartiție a cărei funcție cuantilă o putem calcula; când \(F^{-1}\) nu este explicită, vom folosi metoda respingerii. În Cursul 6, proprietățile funcției cuantilă și universalitatea uniformei vor reduce studiul statisticilor de ordine ale unui eșantion oarecare la cazul uniform, iar cuantilele empirice vor fi valorile funcției cuantilă a funcției de repartiție empirice. Faptul că \(F(X)\sim\Unif(0,1)\) pentru \(F\) continuă stă la baza construcției intervalelor de încredere prin metoda pivotului (Cursul 12) și a uniformității \(p\)-valorii (Cursul 14). Formulele pentru selecția cu și fără revenire sunt aplicate și simulate în Seminarul 3, iar funcția cuantilă și metoda inversă, în Seminarul 4.
Bibliografie
Billingsley, Patrick. 1995. Probability and Measure. 3rd ed. Wiley.
Dalang, Robert C., and Daniel Conus. 2018. Introduction à La Théorie Des Probabilités. 2nd ed. Presses polytechniques et universitaires romandes.
Delmas, Jean-François. 2010. Introduction Au Calcul Des Probabilités Et à La Statistique. Exercices, Problèmes Et Corrections. Les Presses de l’ENSTA.
Durrett, Rick. 2019. Probability: Theory and Examples. 5th ed. Cambridge University Press.
Jacod, Jean, and Philip Protter. 2004. Probability Essentials. 2nd ed. Springer.