x <- c(-1, 0, 1, 2)                  # valorile lui X
p <- (1:4) / 10                      # probabilitățile lor: 0.1, ..., 0.4
x^2; x * p; seq(0, 1, by = 0.25); rep(c(0, 1), times = 3)
#> [1] 1 0 1 4
#> [1] -0.1  0.0  0.3  0.8
#> [1] 0.00 0.25 0.50 0.75 1.00
#> [1] 0 1 0 1 0 1
c(suma = sum(p), medie = sum(x * p), E_X2 = sum(x^2 * p))
#>  suma medie  E_X2
#>     1     1     2
cumsum(p)                            # F_X în punctele -1, 0, 1, 2
#> [1] 0.1 0.3 0.6 1.0Seminarul 1. Probabilități, variabile aleatoare și primii pași în R
Statistică · Seminarul 1 (seminar și laborator) · Fișă de lucru (fără rezolvări)
Alexandru Amărioarei
Universitatea din București · Facultatea de Matematică și Informatică · 2026–2027
Planul seminarului și laboratorului
Reluăm, prin exerciții rezolvate complet, noțiunile din Cursul 1 despre câmpul de probabilitate, condiționare și variabilele aleatoare singure (repartiție, medie, varianță, transformări) și facem cunoștință cu limbajul R.
Obiective. La sfârșitul ședinței studentul trebuie să poată:
- modela un experiment printr-un câmp de probabilitate și calcula probabilități cu formula probabilității totale, formula lui Bayes și independența;
- calcula funcția de repartiție, probabilități, medii, varianțe și cuantile pentru variabile discrete, continue sau mixte;
- determina repartiția unei transformări \(Y=g(X)\): \(g\) strict monotonă, metoda funcției de repartiție, formula cu ramuri pentru \(g\) neinjectivă, transformări cu atom;
- scrie în R cod vectorizat și funcții simple, folosi funcțiile
d/p/q/r,integrateșiuniroot, simula un experiment aleator (sample,replicate) și verifica prin simulare o formulă teoretică.
Structura. Breviar · primii pași în R · câmp de probabilitate, condiționare, independență · variabile discrete, continue și mixte · transformări · exerciții suplimentare · temă. Fiecare exercițiu: Seminar rezolvarea matematică, apoi Laborator rezolvarea în R.
Planul ședinței
De rezolvat la seminar (în această ordine):
- Exercițiul 2 — filtrul anti-spam: probabilitate totală, Bayes, independență condiționată;
- Exercițiul 5 — o densitate polinomială: funcția de repartiție, momente, cuantile;
- Exercițiul 7 (a), (b), (d), (e) — repartiția log-normală: o transformare monotonă;
- Exercițiul 8 (a)–(c), (e) — abaterea absolută: o transformare cu două ramuri.
Dacă timpul permite: Exercițiul 4 (suprarezervarea), Exercițiul 6 (timpul cenzurat), Exercițiul 9 (limita de detecție).
Pentru acasă: Exercițiile 1 și 3; exercițiile suplimentare 10, 11, 12; tema.
Rezolvările complete vor fi publicate ulterior. Scheletele de cod R: în fișa de lucru.
Breviar: probabilitate, condiționare, independență
Rezultate din curs folosite azi
- Probabilitate (Definiția 2 din Cursul 1, Propoziția 3 din Cursul 1): \(\PP(A^c)=1-\PP(A)\); dacă \(A\subseteq B\), atunci \(\PP(B\setminus A)=\PP(B)-\PP(A)\); \(\PP(A\cup B)=\PP(A)+\PP(B)-\PP(A\cap B)\); \(\sigma\)-aditivitatea. În modelul clasic (\(\Omega\) finit, rezultate egal probabile), \(\PP(A)=|A|/|\Omega|\) (Exemplul 1(a) din Cursul 1).
- Condiționare (Definiția 4 din Cursul 1): \(\PP(A\mid B)=\PP(A\cap B)/\PP(B)\), iar \(A\mapsto\PP(A\mid B)\) este o probabilitate (Propoziția 5 din Cursul 1). Pentru un sistem complet de evenimente \((B_i)_i\) cu \(\PP(B_i)>0\) (formula probabilității totale, Teorema 7 din Cursul 1, și formula lui Bayes, Teorema 8 din Cursul 1): \[ \PP(A)=\sum_i\PP(B_i)\,\PP(A\mid B_i),\qquad \PP(B_j\mid A)=\frac{\PP(B_j)\,\PP(A\mid B_j)}{\sum_i\PP(B_i)\,\PP(A\mid B_i)} . \]
- Independență (Definiția 9 din Cursul 1): \(A_1,\dots,A_n\) sunt independente dacă relația de produs \(\PP(A_{i_1}\cap\dots\cap A_{i_k})=\PP(A_{i_1})\cdots\PP(A_{i_k})\) are loc pentru orice subfamilie; independența a două evenimente se păstrează la trecerea la evenimentele contrare (Propoziția 10 din Cursul 1).
Breviar: funcția de repartiție, medie și varianță
Rezultate din curs folosite azi (continuare)
- Funcția de repartiție \(F_X(x)=\PP(X\le x)\) (Definiția 13 din Cursul 1) este crescătoare, continuă la dreapta, cu limitele \(0\) și \(1\), și (Propoziția 14 din Cursul 1) \(\PP(a<X\le b)=F_X(b)-F_X(a)\), \(\PP(X<b)=F_X(b-)\), \(\PP(X=b)=F_X(b)-F_X(b-)\). \(X\) este discretă (tabel de repartiție) sau continuă (densitate \(f_X\), cu \(F_X(x)=\int_{-\infty}^xf_X(t)\dd t\)), Definiția 15 din Cursul 1; repartițiile uzuale sunt în Secțiunea 4.3 din Cursul 1.
- Cuantila de ordin \(p\in(0,1)\) este cel mai mic \(x\) cu \(F_X(x)\ge p\); dacă \(F_X\) este continuă și strict crescătoare acolo unde ia valori în \((0,1)\), ea este unica soluție a ecuației \(F_X(x)=p\). Mediana este cuantila de ordin \(\frac12\).
- Medie și varianță (Definițiile 21 din Cursul 1 și 24 din Cursul 1): \(\E[X]=\sum_ix_ip_i\), respectiv \(\int_{\R}xf_X(x)\dd x\); formula de transport (Teorema 22 din Cursul 1): \(\E[g(X)]=\sum_ig(x_i)p_i\), respectiv \(\int_{\R}g(x)f_X(x)\dd x\), dacă seria sau integrala converge absolut; \(\E[\Ind_A]=\PP(A)\) (Propoziția 23 din Cursul 1); \(\Var(X)=\E[X^2]-(\E X)^2\) și \(\Var(aX+b)=a^2\Var(X)\) (Propoziția 25 din Cursul 1); valorile pentru repartițiile uzuale: Exemplul 16 din Cursul 1.
- Inegalitatea lui Cebîșev (Propoziția 26(b) din Cursul 1): \(\PP(|X-\E X|\ge\varepsilon)\le\Var(X)/\varepsilon^2\).
Breviar: transformări \(Y=g(X)\)
Rezultate din curs folosite azi (continuare)
- \(X\) discretă: \(\PP(Y=y)=\sum_{i:\,g(x_i)=y}\PP(X=x_i)\) (Secțiunea 4.4 din Cursul 1).
- Metoda funcției de repartiție, pentru orice \(g\): \(F_Y(y)=\PP(X\in A_y)\), cu \(A_y=\{x:\ g(x)\le y\}\); dacă \(F_Y\) este continuă și are derivata continuă în afara unui număr finit de puncte, atunci \(Y\) are densitatea \(F_Y'\) (Lema 16 din Cursul 1).
- Transformări strict monotone (Teorema 17 din Cursul 1): dacă \(f_X\) este nulă în afara intervalului deschis \(I\), iar \(g\) este strict monotonă și derivabilă pe \(I\), cu \(g'\ne0\), atunci \(f_Y(y)=f_X\big(g^{-1}(y)\big)\,\big|(g^{-1})'(y)\big|\) pe \(g(I)\). Dacă \(X\sim\Norm(\mu,\sigma^2)\), atunci \(\frac{X-\mu}\sigma\sim\Norm(0,1)\) și \(F_X(x)=\Phi\big(\frac{x-\mu}{\sigma}\big)\) (Propoziția 18 din Cursul 1).
- Transformări neinjective (Teorema 19 din Cursul 1): dacă \(g\) este strict monotonă și derivabilă, cu \(g'\ne0\), pe fiecare dintre intervalele deschise disjuncte \(I_1,I_2,\dots\) (ramurile), cu \(\PP(X\in\bigcup_kI_k)=1\), atunci, cu \(J_k=g(I_k)\) și \(h_k:J_k\to I_k\) inversa lui \(g\) pe \(I_k\), \(f_Y(y)=\sum_kf_X\big(h_k(y)\big)\,\big|h_k'(y)\big|\,\Ind_{J_k}(y)\). Imaginile \(J_k\) pot fi diferite, deci numărul termenilor depinde de \(y\) (Exemplul 11 din Cursul 1).
- Dacă \(g\) este constantă pe o mulțime de probabilitate pozitivă pentru \(X\), atunci \(g(X)\) are un atom și nu are densitate (Exemplul 13 din Cursul 1).
Breviar: instrumentele R ale ședinței
Instrumente R folosite azi
c(),a:b,seq(),rep()— vectori; operațiile se aplică element cu element;sum,prod,cumsum,mean,var;pmin,pmax— minimul și maximul element cu element.x[cond]— indexare logică;mean(cond)— o frecvență relativă;mean(A[B])estimează \(\PP(A\mid B)\).function(x) ...;ifelse(cond, a, b)— funcții pe ramuri;sapply(v, f)— aplicăffiecărui element al luiv;tapply(p, g, sum)— sume pe grupe.set.seed(k)— rezultate reproductibile;sample(x, size, replace, prob)— extrageri dinx;replicate(m, expr)— repetă o expresie aleatoare;table,any,rbind,matrix.- prefixele
d,p,q,r+ numele repartiției (binom,pois,geom,unif,exp,norm,lnorm): funcția de masă sau densitatea, funcția de repartiție, cuantila, generarea de valori. integrate(f, a, b)$value— integrală numerică;uniroot(h, c(a, b))$root— o rădăcină a ecuației \(h(x)=0\) în \([a,b]\), când \(h(a)\) și \(h(b)\) au semne contrare.curve(expr, a, b);hist(y, freq = FALSE)— histograma normalizată (aria \(1\));ecdf(y)— funcția de repartiție empirică \(F_n(t)=\frac1n\#\{i:\ y_i\le t\}\);quantile(y, p).
Primii pași în R
Vectori și operații vectorizate
În RStudio: #> marchează rezultatele, # un comentariu, <- atribuirea, ?mean deschide documentația. Vectorul este structura de bază (c(), :, seq(), rep()); operațiile se aplică element cu element. Exemplu: \(X\) cu valorile \(-1,0,1,2\) și probabilitățile \(0.1,0.2,0.3,0.4\).
\(\E[X]=\sum_ix_ip_i=1\), \(\E[X^2]=2\), deci \(\Var(X)=2-1^2=1\); cumsum(p): valorile lui \(F_X\) în punctele de salt.
Indexarea logică
O comparație aplicată unui vector întoarce un vector logic (TRUE/FALSE), cu care putem selecta elemente. În calcule, TRUE și FALSE devin \(1\) și \(0\): suma unui vector logic este numărul valorilor TRUE, iar media lui este proporția acestora.
which întoarce pozițiile în care condiția este adevărată; prima dă mediana, \(1\) (\(F_X\) „sare” de la \(0.3\) la \(0.6\) în punctul \(1\)). Ultima linie: \(\PP(X^2=y)=\sum_{i:\,x_i^2=y}p_i\), deci \(X^2\) ia valorile \(0,1,4\) cu probabilitățile \(0.2,0.4,0.4\).
Funcții
function(argumente) corp întoarce valoarea ultimei expresii; argumentele pot avea valori implicite.
momente <- function(x, p = rep(1 / length(x), length(x))) {
  m <- sum(x * p)                    # media
  c(medie = m, varianta = sum((x - m)^2 * p))
}
momente(x, p)                        # variabila X de mai sus
#>    medie varianta
#>        1        1
momente(1:6)                         # implicit: uniformă pe valori (un zar)
#>    medie varianta
#>    3.500    2.917
F_X <- function(t) sapply(t, function(u) sum(p[x <= u]))   # P(X <= t)
F_X(c(-2, 0.5, 0.999, 1, 3))
#> [1] 0.0 0.3 0.3 0.6 1.0
Zarul: media \(3.5\), varianța \(35/12\approx2.917\). sapply aplică funcția fiecărui element al lui t; \(F_X(0.999)=0.3\) și \(F_X(1)=0.6\) arată saltul din \(x=1\), de mărime \(\PP(X=1)=0.3\).
Simularea unui experiment
Numerele generate sunt pseudo-aleatoare (algoritmii: Cursul 4); set.seed fixează starea generatorului: rezultate reproductibile. sample(x, size, replace, prob) extrage size elemente din x, fără sau cu întoarcere, cu probabilitățile prob (implicit egale).
set.seed(2026)
sample(1:6, size = 10, replace = TRUE)          # 10 aruncări ale unui zar
#>  [1] 5 1 1 6 5 3 4 4 5 4
val <- sample(x, size = 1e4, replace = TRUE, prob = p)   # 10^4 valori
table(val) / length(val)                        # frecvențele relative
#> val
#>     -1      0      1      2
#> 0.1031 0.1939 0.3009 0.4021
c(medie = mean(val), varianta = var(val), P_X_ge_1 = mean(val >= 1))
#>    medie varianta P_X_ge_1
#>    1.002    1.008    0.703
Frecvențele relative sunt apropiate de \(0.1,0.2,0.3,0.4\), media și varianța de \(\E[X]=1\) și \(\Var(X)=1\), iar mean(val >= 1) de \(\PP(X\ge1)=0.7\): interpretarea frecvențială a probabilității (Teorema 61 din Cursul 1).
Estimarea unei probabilități prin simulare
Schema generală: o expresie care simulează o realizare a experimentului și întoarce TRUE sau FALSE, repetată de \(m\) ori cu replicate; apoi media. Cavalerul de Méré: cel puțin un \(6\) în \(4\) aruncări ale unui zar (\(A\)) sau cel puțin o dublă de \(6\) în \(24\) de aruncări a două zaruri (\(B\))? \(\PP(A)=1-(\frac56)^4\approx0.5177\), \(\PP(B)=1-(\frac{35}{36})^{24}\approx0.4914\).
set.seed(1654)
m <- 1e5
A <- replicate(m, any(sample(6, 4, replace = TRUE) == 6))
B <- replicate(m, any(sample(6, 24, replace = TRUE) == 6 &
                      sample(6, 24, replace = TRUE) == 6))
rbind(simulare = c(A = mean(A), B = mean(B)),
      exact = c(1 - (5/6)^4, 1 - (35/36)^24))
#>               A      B
#> simulare 0.5178 0.4943
#> exact    0.5177 0.4914
Probabilitățile diferă cu doar \(0.026\), dar \(10^5\) repetări le disting: eroarea tipică a unei frecvențe relative calculate din \(m\) repetări independente este \(\sqrt{p(1-p)/m}\approx0.0016\) (Seminarul 2).
Bucle și condiții
for (k in v) {...} repetă un bloc pentru fiecare element al lui v; while (conditie) {...}, cât timp condiția este adevărată; if (conditie) {...} else {...} cere un singur TRUE sau FALSE. Buclele sunt lente: le folosim numai când pașii depind unul de altul. Exemplu: aruncăm un zar până la primul \(6\); \(X\sim\Geom(1/6)\), \(\E[X]=6\), \(\PP(X\le3)=1-(5/6)^3\approx0.4213\).
pana_la_6 <- function() {            # numărul de aruncări până la primul 6
  k <- 0; zar <- 0
  while (zar != 6) {
    zar <- sample(6, 1)              # o aruncare a zarului
    k <- k + 1
  }
  k
}
set.seed(3); nr <- replicate(1e4, pana_la_6())   # 10^4 repetări
c(medie = mean(nr), P_cel_mult_3 = mean(nr <= 3), exact = 1 - (5/6)^3)
#>        medie P_cel_mult_3        exact
#> 6.0354 0.4218 0.4213Repartițiile uzuale: funcțiile d, p, q, r
Prefixele d (funcția de masă sau densitatea), p (funcția de repartiție), q (cuantila), r (generarea de valori) + numele repartiției (Secțiunea 4.3 din Cursul 1). Exemplu: note \(\Norm(6.5,1.5^2)\); prin standardizare (Propoziția 18(b) din Cursul 1), \(\PP(X>8)=1-\Phi(1)\), \(\PP(5<X<9)=\Phi(5/3)-\Phi(-1)\); nota minimă a celor mai buni \(10\%\): \(6.5+1.5\,z_{0.9}\).
c(peste_8 = 1 - pnorm(8, mean = 6.5, sd = 1.5),
  intre_5_9 = pnorm(9, 6.5, 1.5) - pnorm(5, 6.5, 1.5),
  top_10 = qnorm(0.9, 6.5, 1.5), formula = 6.5 + 1.5 * qnorm(0.9))
#>   peste_8 intre_5_9    top_10   formula
#>    0.1587    0.7936    8.4223    8.4223
c(dbinom(2, 5, 0.1587), 1 - pbinom(1, 5, 0.1587))   # N ~ Bin(5, 0.1587)
#> [1] 0.150 0.181
c(E_Z2 = integrate(function(t) t^2 * dnorm(t), -Inf, Inf)$value,
  z_0.975 = uniroot(function(t) pnorm(t) - 0.975, c(0, 5))$root)
#>    E_Z2 z_0.975
#>    1.00    1.96
Dintre \(5\) studenți, \(N\sim\Bin(5,0.1587)\) au peste \(8\): \(\PP(N=2)\approx0.150\), \(\PP(N\ge2)\approx0.181\). Funcțiile pot fi argumente: integrate dă \(\E[Z^2]=1\), iar uniroot rezolvă \(\Phi(t)=0.975\): \(z_{0.975}\approx1.96\).
Trei capcane. Un grafic
Atenție! (Trei capcane)
- Repartiția normală se parametrizează în R prin abaterea standard (
sd), nu prin varianță, iar cea exponențială prin rată:pexp(x, rate = lambda). - Pentru o variabilă continuă, funcțiile
dîntorc valoarea densității, care nu este o probabilitate; probabilitățile se calculează cu funcțiilep. dgeomșirgeomnumără eșecurile dinaintea primului succes: pentru \(X\sim\Geom(p)\) (numărul încercării la care apare primul succes), \(\PP(X=k)\) estedgeom(k - 1, p).
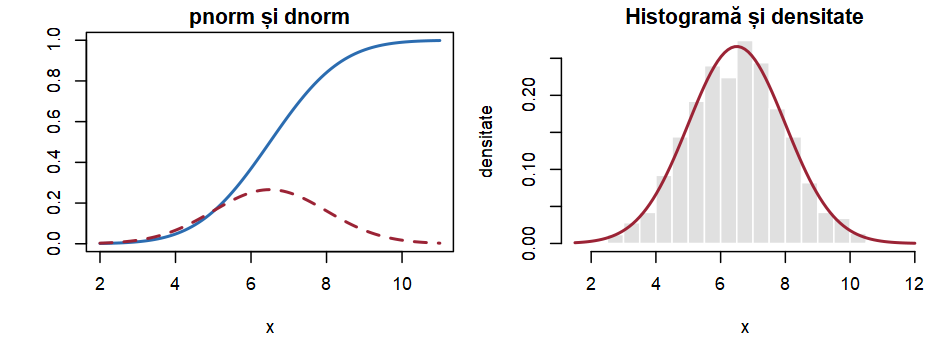
Un grafic. curve(pnorm(x, 6.5, 1.5), 2, 11) desenează o expresie în x; hist(note, freq = FALSE) este histograma normalizată (aria \(1\)), peste care suprapunem densitatea: curve(dnorm(x, 6.5, 1.5), add = TRUE).
Câmp de probabilitate, condiționare și independență
Problema zilelor de naștere
Exercițiul 1 (Problema zilelor de naștere)
Pentru acasă Într-o grupă sunt \(n\) studenți. Presupunem că anul are \(365\) de zile (ignorăm \(29\) februarie), că fiecare student este născut în oricare dintre zile cu aceeași probabilitate și că zilele de naștere ale studenților sunt independente.
- Calculați probabilitatea \(p_n\) ca cel puțin doi studenți să fie născuți în aceeași zi. Care este cel mai mic \(n\) pentru care \(p_n>1/2\)?
- Arătați că \(p_n\ge1-\exp\big(-\frac{n(n-1)}{730}\big)\) și explicați, cu ajutorul acestei margini, ordinul de mărime al răspunsului de la (a).
- Care este probabilitatea ca cel puțin unul dintre ceilalți \(n-1\) studenți să fie născut în aceeași zi cu un student fixat (de exemplu, cu dumneavoastră)? Câți colegi sunt necesari pentru ca această probabilitate să depășească \(1/2\)? Explicați diferența față de (a).
- În R: calculați \(p_n\) pentru \(n=1,\dots,70\), comparați cu marginea de la (b) și estimați \(p_{23}\) prin simulare.
Un filtru anti-spam
Exercițiul 2 (Un filtru anti-spam)
La seminar Dintre mesajele primite de un server, \(40\%\) sunt spam. Cuvântul „gratuit” apare în \(25\%\) dintre mesajele spam și în \(2\%\) dintre mesajele legitime, iar cuvântul „câștig” apare în \(20\%\) dintre mesajele spam și în \(1\%\) dintre cele legitime.
- Ce proporție dintre mesaje conțin cuvântul „gratuit”? Care este probabilitatea ca un mesaj care conține acest cuvânt să fie spam?
- Presupunem că aparițiile celor două cuvinte sunt independente condiționat de tipul mesajului (independente printre mesajele spam și independente printre cele legitime). Care este probabilitatea ca un mesaj care conține ambele cuvinte să fie spam? Dar a unui mesaj care conține „gratuit”, dar nu conține „câștig”?
- Sunt evenimentele „mesajul conține «gratuit»” și „mesajul conține «câștig»” independente (necondiționat)?
- În R: calculați probabilitățile de la (a) și (b) cu o funcție și verificați-le, împreună cu (c), simulând \(2\cdot10^5\) mesaje.
Independența și evenimentele contrare; sisteme în serie și în paralel
Extinderea Propoziției 10 din Cursul 1 la \(m\) evenimente: dacă \(A_1,\dots,A_m\) sunt independente și înlocuim oricâte dintre ele cu evenimentele contrare, obținem tot evenimente independente.
Justificare. Este suficient să înlocuim un singur eveniment, de exemplu \(A_1\) (ordinea nu contează în Definiția 9 din Cursul 1, iar înlocuirile se fac una câte una). Pentru subfamiliile care nu îl conțin pe \(A_1^c\), relația de produs este cea din ipoteză. Pentru o subfamilie care îl conține, fie \(J\subseteq\{2,\dots,m\}\) mulțimea (nevidă) a celorlalți indici și \(D=\bigcap_{i\in J}A_i\). Din \(D=(A_1\cap D)\cup(A_1^c\cap D)\), reuniune disjunctă, și din relațiile de produs pentru subfamiliile \(J\) și \(\{1\}\cup J\), \[ \PP(A_1^c\cap D)=\PP(D)-\PP(A_1\cap D)=\prod_{i\in J}\PP(A_i)-\PP(A_1)\prod_{i\in J}\PP(A_i)=\PP(A_1^c)\prod_{i\in J}\PP(A_i) . \]
Două consecințe, pentru componente independente care funcționează cu probabilitățile \(p_1,\dots,p_m\):
- un sistem în serie (funcționează dacă toate componentele funcționează) are probabilitatea de funcționare \(p_1\cdots p_m\);
- un sistem în paralel (funcționează dacă cel puțin o componentă funcționează) cedează numai dacă toate componentele cedează, deci funcționează cu probabilitatea \(1-(1-p_1)\cdots(1-p_m)\).
Sistemul în punte
Exercițiul 3 (Sistemul în punte)
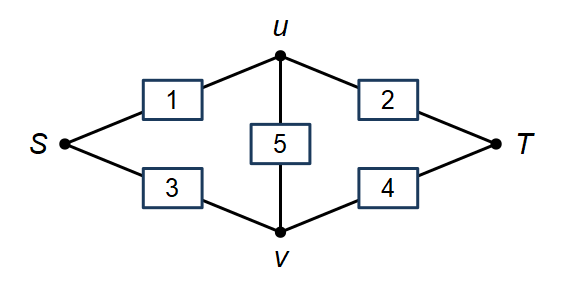
Pentru acasă Un sistem este format din \(5\) componente, dispuse „în punte”: componentele \(1\) și \(2\) leagă, în această ordine, nodul \(S\) de nodul \(T\) prin nodul interior \(u\), componentele \(3\) și \(4\) leagă, tot în această ordine, \(S\) de \(T\) prin nodul interior \(v\), iar componenta \(5\) (puntea) leagă nodurile \(u\) și \(v\). Fiecare componentă funcționează cu probabilitatea \(p\in(0,1)\), independent de celelalte. Sistemul funcționează dacă există un drum de la \(S\) la \(T\) format numai din componente funcționale.
Calculați probabilitatea de funcționare \(R(p)\) a sistemului și evaluați-o pentru \(p=0.9\).
Știind că sistemul funcționează, care este probabilitatea ca puntea să funcționeze?
În R: verificați (a) și (b) simulând \(10^5\) sisteme cu \(p=0.9\).
Variabile aleatoare discrete, continue și mixte
Suprarezervarea locurilor într-un avion
Exercițiul 4 (Suprarezervarea locurilor într-un avion)
Dacă timpul permite O companie aeriană vinde \(52\) de bilete pentru un avion cu \(50\) de locuri. Fiecare pasager se prezintă la îmbarcare cu probabilitatea \(0.95\), independent de ceilalți.
- Care este repartiția numărului \(X\) de pasageri care se prezintă la îmbarcare? Calculați \(\E[X]\) și \(\Var(X)\).
- Care este probabilitatea ca cel puțin un pasager prezent să nu aibă loc în avion? Comparați cu aproximarea Poisson a numărului de pasageri absenți.
- Calculați numărul mediu de pasageri care rămân fără loc.
- Care este cel mai mare număr \(m\) de bilete care pot fi vândute astfel încât probabilitatea ca un pasager prezent să rămână fără loc să nu depășească \(0.1\)?
- În R: verificați (a)–(d) cu funcțiile
dbinom,pbinomșippoisși simulați \(10^5\) zboruri curbinom.
O variabilă aleatoare este descrisă complet de funcția ei de repartiție; din tabelul de repartiție sau din densitate obținem probabilități, medii (cu formula de transport), varianțe și cuantile. Cele trei exerciții ale temei: o variabilă discretă (binomială), una continuă, dată prin densitate, și una mixtă.
O densitate polinomială
Pentru o variabilă continuă, probabilitățile sunt arii sub graficul densității, iar mediile sunt integrale. Când ecuația \(F_X(x)=p\) nu se poate rezolva ușor, cuantilele se calculează numeric.
Exercițiul 5 (O densitate polinomială)
La seminar Fie \(X\) o variabilă aleatoare cu densitatea \(f(x)=c\,x(2-x)\) pentru \(0\le x\le2\) și \(f(x)=0\) în rest.
- Determinați \(c\) și funcția de repartiție \(F_X\).
- Arătați că repartiția lui \(X\) este simetrică față de \(1\) și calculați \(\E[X]\) și \(\Var(X)\).
- Determinați mediana și arătați că prima cuartilă \(q_{1/4}\) (cuantila de ordin \(\frac14\)) este soluția din \((0,2)\) a ecuației \(x^3-3x^2+1=0\), iar \(q_{3/4}=2-q_{1/4}\).
- Comparați \(\PP(|X-\E X|\ge0.8)\) cu marginea dată de inegalitatea lui Cebîșev.
- În R: verificați (a) și (b) prin integrare numerică, calculați cuartilele cu
uniroot, verificați (d) și reprezentați grafic \(f\) și \(F_X\).
Media unei variabile nenegative
Multe variabile întâlnite în aplicații nu sunt nici discrete, nici continue: de exemplu, un timp de funcționare observat doar până la un moment fixat (Exemplul 13 din Cursul 1). Pentru media unei astfel de variabile nenegative este utilă o formulă care folosește numai funcția de repartiție.
Lema 1 (Media unei variabile nenegative)
Fie \(X\ge0\) o variabilă aleatoare. Atunci \[ \E[X]=\int_0^\infty\PP(X>x)\dd x=\int_0^\infty\big(1-F_X(x)\big)\dd x, \qquad \E[X^2]=\int_0^\infty2x\,\PP(X>x)\dd x ,\tag{1} \] egalitățile având loc în \([0,\infty]\) (ambii membri pot fi infiniți).
Geometric, (1) spune că media unei variabile nenegative este aria dintre graficul lui \(F_X\) și dreapta \(y=1\).
Exemplu: pentru \(X\sim\Exp(\lambda)\), \(\PP(X>x)=e^{-\lambda x}\) pentru \(x\ge0\), deci \(\E[X]=\int_0^\infty e^{-\lambda x}\dd x=\frac1\lambda\).
Media unei variabile nenegative — demonstrație
Demonstrație. Pasul 1. Pentru orice \(\omega\in\Omega\), \(X(\omega)\ge0\) este lungimea intervalului \([0,X(\omega))\), iar \(X(\omega)^2=\int_0^{X(\omega)}2x\dd x\); deci \[ X(\omega)=\int_0^\infty\Ind_{\{x<X(\omega)\}}\dd x ,\qquad X(\omega)^2=\int_0^\infty2x\,\Ind_{\{x<X(\omega)\}}\dd x . \] Pasul 2 (măsurabilitatea). \((\omega,x)\mapsto\Ind_{\{x<X(\omega)\}}\) este nenegativă și măsurabilă pe \(\Omega\times[0,\infty)\): \(\{(\omega,x):\ x<X(\omega)\}\) este reuniunea numărabilă a dreptunghiurilor măsurabile \(\{X>r\}\times[0,r)\), cu \(r>0\) rațional.
Pasul 3 (schimbarea ordinii de integrare). Din teorema lui Fubini pentru funcții nenegative, fără nicio condiție de integrabilitate (Billingsley 1995, sec. 18), și din \(\E[\Ind_A]=\PP(A)\) (Propoziția 23(a) din Cursul 1), \[ \E[X]=\int_\Omega\Big(\int_0^\infty\Ind_{\{x<X(\omega)\}}\dd x\Big)\dd\PP(\omega) =\int_0^\infty\E\big[\Ind_{\{X>x\}}\big]\dd x=\int_0^\infty\PP(X>x)\dd x . \] La fel, pentru funcția \(2x\,\Ind_{\{x<X(\omega)\}}\), \(\E[X^2]=\int_0^\infty2x\,\PP(X>x)\dd x\).■
Timpul de funcționare cenzurat
Exercițiul 6 (Timpul de funcționare cenzurat)
Dacă timpul permite Timpul de funcționare (în ani) al unui aparat este \(T\sim\Exp(\lambda)\). Aparatul este înlocuit fie la defectare, fie, preventiv, după \(c\) ani, dacă nu s-a defectat până atunci. Fie \(X=\min(T,c)\) timpul de utilizare a aparatului.
Determinați funcția de repartiție a lui \(X\). Este \(X\) discretă? Este \(X\) continuă?
Calculați \(\E[X]\), \(\E[X^2]\) și \(\Var(X)\) cu Lema 1; verificați media cu formula de transport aplicată lui \(T\).
Aplicație numerică: \(\lambda=0.5\) (timp mediu de funcționare de \(2\) ani) și \(c=2\).
În R: simulați \(10^5\) valori ale lui \(X\) și comparați media, momentul de ordin doi, varianța, proporția valorilor egale cu \(c\) și funcția de repartiție empirică cu rezultatele de la (a)–(c).
Transformări ale unei variabile aleatoare
Repartiția log-normală
Exercițiul 7 (Repartiția log-normală)
La seminar Fie \(Y\sim\Norm(\mu,\sigma^2)\) și \(X=e^Y\) (repartiția log-normală, \(X\sim\mathcal{LN}(\mu,\sigma^2)\)), folosită pentru mărimi pozitive și asimetrice: venituri, prețuri, concentrații, factori de creștere.
- Determinați densitatea lui \(X\).
- Calculați momentele \(\E[X^k]\), \(k\in\N\), apoi media și varianța lui \(X\).
- Determinați mediana și modul (punctul de maxim al densității) lui \(X\) și comparați-le cu media.
- Aplicație: factorul anual de creștere al unei investiții este \(X=e^Y\), cu \(Y\sim\Norm(0,1)\). Calculați \(\PP(X>2)\), mediana și media lui \(X\).
- În R: simulați \(10^5\) valori ale lui \(X\), verificați (d) și comparați histograma valorilor simulate cu densitatea de la (a).
Fiecare formulă obținută este verificată prin simulare: dacă \(x_1,\dots,x_n\) sunt valori simulate ale lui \(X\), atunci \(g(x_1),\dots,g(x_n)\) sunt valori simulate ale lui \(Y=g(X)\); histograma lor trebuie să urmeze densitatea calculată, iar funcția de repartiție empirică, funcția de repartiție calculată.
Abaterea absolută de la medie a unei variabile exponențiale
Exercițiul 8 (Abaterea absolută de la medie a unei variabile exponențiale)
La seminar Timpul de funcționare (în ani) al unei componente este \(X\sim\Exp(1)\), deci \(\E[X]=1\); o revizie este programată la momentul \(1\). Fie \(D=|X-1|\) decalajul dintre momentul defectării și cel al reviziei, adică abaterea absolută a lui \(X\) de la medie.
- Determinați densitatea lui \(D\) cu Teorema 19 din Cursul 1, precizând ramurile, inversele și imaginile lor. Verificați că integrala densității este \(1\).
- Regăsiți rezultatul prin metoda funcției de repartiție.
- Calculați \(\E[D]\) (abaterea medie absolută) și comparați-o cu abaterea standard a lui \(X\). Calculați \(\PP(D\le1)\) și mediana lui \(D\).
- Deduceți densitatea abaterii pătratice \(Q=(X-1)^2\) și calculați \(\E[Q]\) și \(\Var(D)\).
- În R: simulați \(10^5\) valori ale lui \(D\) și verificați (a)–(d), comparând histograma cu densitatea și funcția de repartiție empirică cu cea teoretică. Ce integrală are formula obținută dacă se „uită” o ramură?
Limita de detecție: o transformare cu atom
Exercițiul 9 (Limita de detecție: o transformare cu atom)
Dacă timpul permite Abaterea (în microni) a diametrului unei piese față de cota nominală este \(X\sim\Norm(0,\sigma^2)\). Aparatul de control nu distinge abaterile mai mici, în valoare absolută, decât limita de detecție \(a>0\): pentru acestea înregistrează valoarea \(a\), iar pentru celelalte înregistrează \(|X|\). Valoarea înregistrată este deci \(Y=\max(|X|,a)\).
- Descrieți transformarea \(g(x)=\max(|x|,a)\), explicați de ce Teorema 19 din Cursul 1 nu se aplică și determinați funcția de repartiție a lui \(Y\).
- Arătați că \(Y\) nu este nici discretă, nici continuă și descrieți cele două componente ale repartiției ei.
- Calculați \(\E[Y]\) cu formula de transport aplicată lui \(X\). Ce se obține dacă se „uită” atomul? Comparați cu \(\E|X|\).
- Determinați cuantila de ordin \(p\in(0,1)\) a lui \(Y\). Aplicație numerică: \(\sigma=2\), \(a=1\); calculați \(\PP(Y=a)\), \(\E[Y]\), mediana și cuantila de ordin \(0.9\).
- În R: verificați (d) prin simulare, regăsiți \(\E[Y]\) cu Lema 1 și comparați funcția de repartiție empirică cu cea de la (a).
Exerciții suplimentare
Jocul pe rând și paritatea: transformări discrete neinjective
Exercițiul 10 (Jocul pe rând și paritatea: transformări discrete neinjective)
Pentru acasă (a) Trei jucători, \(J_1\), \(J_2\), \(J_3\), aruncă pe rând un zar echilibrat, în această ordine (\(J_1,J_2,J_3,J_1,J_2,\dots\)), până când apare prima dată fața \(6\); câștigă jucătorul care o obține. Fie \(X\) numărul aruncării la care apare primul \(6\) și \(Y\in\{1,2,3\}\) indicele câștigătorului. Scrieți \(Y\) ca funcție de \(X\) și determinați repartiția lui \(Y\). Generalizați la \(m\ge2\) jucători și la o probabilitate de succes \(p\in(0,1)\) la fiecare încercare.
Numărul \(N\) de particule înregistrate de un detector într-o secundă are repartiția \(\Pois(\lambda)\). Determinați repartiția variabilei \(S=(-1)^N\), care reține numai paritatea lui \(N\), și calculați \(\E[S]\) în două moduri. Este mai probabil un număr par sau un număr impar de particule?
În R: verificați (a) și (b) prin simulare (cu
rgeom,rpoisși operatorul%%, restul împărțirii) și regăsiți repartiția lui \(Y\) adunând probabilitățile preimaginilor cutapply.
O transformare discretă în care fiecare valoare are o infinitate de preimagini.
Timpul de parcurgere cu o viteză aleatoare
Exercițiul 11 (Timpul de parcurgere cu o viteză aleatoare)
Pentru acasă O particulă se deplasează de-a lungul unei axe cu viteza constantă \(V\sim\Norm(0,\sigma^2)\) (semnul lui \(V\) indică sensul deplasării). Fie \(d>0\) și \(T=d/|V|\) timpul în care particula parcurge distanța \(d\).
- Pentru \(t>0\), descrieți mulțimea \(A_t=\{v\ne0:\ d/|v|\le t\}\) și determinați funcția de repartiție a lui \(T\) prin metoda funcției de repartiție.
- Deduceți densitatea lui \(T\) și regăsiți-o cu Teorema 19 din Cursul 1.
- Determinați cuantila de ordin \(p\in(0,1)\) a lui \(T\); în particular, mediana și cuartilele. Arătați că \(\E[T]=\infty\).
- Aplicație numerică: \(d=1\), \(\sigma=1\). Calculați \(\PP(T\le1)\), \(\PP(T>10)\) și mediana.
- În R: verificați (a)–(d) prin simulare și comparați mediile și medianele a cinci eșantioane de câte \(10^5\) valori.
Mulțimea \(A_t\) este reuniunea a două semidrepte, iar rezultatul este o repartiție fără medie: media valorilor simulate nu se mai stabilizează, oricât de multe valori am genera.
Un semnal periodic citit la un moment aleator
Exercițiul 12 (Un semnal periodic citit la un moment aleator)
Pentru acasă Un semnal \(s(t)=\cos t\) este citit la un moment aleator \(T\sim\Exp(\lambda)\), \(\lambda>0\). Fie \(Y=\cos T\) valoarea citită.
- Pentru \(y\in(-1,1)\), determinați toate soluțiile \(t>0\) ale ecuației \(\cos t=y\), ramurile de monotonie ale funcției \(g(t)=\cos t\) pe \((0,\infty)\) și inversele lor.
- Determinați densitatea lui \(Y\) cu Teorema 19 din Cursul 1.
- Determinați funcția de repartiție a lui \(Y\) prin metoda funcției de repartiție și verificați că derivata ei este densitatea de la (b).
- Calculați \(\PP(Y>0)\) și \(\E[Y]\), cu valorile numerice pentru \(\lambda=1\). Ce devine densitatea lui \(Y\) când \(\lambda\to0\)?
- În R: verificați (b)–(d) prin simulare, pentru \(\lambda=1\).
O transformare periodică are o infinitate de ramuri, ale căror contribuții formează serii geometrice; se folosesc \(\cosh x=\frac{e^x+e^{-x}}2\) și \(\sinh x=\frac{e^x-e^{-x}}2\).
Temă
- (R) O monedă echilibrată este aruncată de \(n\ge2\) ori; \(A\) = „apar cel puțin un cap și cel puțin o pajură”, \(B\) = „apare cel mult o pajură”. Pentru ce \(n\) sunt \(A\) și \(B\) independente? Verificați în R (
expand.grid). - Trei mașini produc \(50\%\), \(30\%\), \(20\%\) din piese, cu \(2\%\), \(3\%\), \(5\%\) piese defecte: proporția pieselor defecte; probabilitatea ca o piesă defectă să provină de la fiecare mașină.
- (R) Masa pachetelor: \(X\sim\Norm(\mu,\sigma^2)\); \(10\%\) au sub \(490\) g și \(5\%\) au peste \(520\) g: \(\mu\) și \(\sigma\) (
qnorm,pnorm). - \(f(x)=2/x^3\), \(x\ge1\): densitate, \(F\), mediana; \(\E[X]<\infty\), dar \(\E[X^2]=\infty\); repartiția lui \(\ln X\).
- Inegalitatea lui Cebîșev nu poate fi îmbunătățită: pentru orice \(k>1\) există \(X\) cu \(\PP(|X-\E X|\ge k\sigma_X)=1/k^2\); pentru \(X\sim\Exp(1)\), marginile \(\PP(X\ge3)\le p!/3^p\), \(p=1,\dots,5\) (Markov pentru \(X^p\)): care este cea mai bună?
- \(f(x)=\frac29(x+1)\), \(-1<x<2\), și \(Y=X^2\): densitatea lui \(Y\) cu Teorema 19 din Cursul 1 și prin metoda funcției de repartiție.
- (R) Limitatorul \(Y=\max\big(-1,\min(X,1)\big)\), \(X\sim\Norm(0,1)\): \(F_Y\), atomii și masele lor; \(\E[Y]\), \(\Var(Y)\); simulare.
- (R)
serie_maxima(n, p): cea mai lungă serie consecutivă de steme în \(n\) aruncări (rle); cureplicate, media lungimii ei pentru \(n=100\), \(p=0.5\) și probabilitatea ca ea să fie cel puțin \(6\).
Enunțurile complete și răspunsurile: în fișa de lucru.
Bibliografie
Pentru limbajul R recomandăm (Davies 2016, cap. 1–10) și (Verzani 2014, cap. 1–4), iar pentru alte exerciții de probabilități, culegerile de mai jos.
Billingsley, Patrick. 1995. Probability and Measure. 3rd ed. Wiley.
Casella, George, and Roger L. Berger. 2002. Statistical Inference. 2nd ed. Duxbury.
Davies, Tilman. 2016. The Book of r. A First Course in Programming and Statistics. 1st ed. No Starch Press, Inc.
Dixit, Ulhas Jayram. 2016. Examples in Parametric Inference with r. Springer.
Kupper, Lawrence L., Brian H. Neelon, and Sean M. O’Brien. 2013. Exercises and Solutions in Statistical Theory. Chapman & Hall/CRC.
Verzani, John. 2014. Using R for Introductory Statistics. 2nd ed. CRC Press.
Statistică · Seminarul 1 — Probabilități și primii pași în R