#> [1] 14
#> [1] 1024
#> [1] 3
#> [1] 2
#> [1] 3.844Seminarul 1. Evenimente, probabilități și numărare. Primii pași în R
Probabilități și Statistică · Seminarul 1 (seminar și laborator) · Fișă de lucru (fără rezolvări)
Alexandru Amărioarei
Universitatea din București · Facultatea de Matematică și Informatică · 2026–2027
Planul seminarului și laboratorului
Fiecare problemă se lucrează întâi „cu creionul”, apoi pe calculator (Laborator), prin enumerarea spațiului stărilor sau prin simulare.
| Tema | Conținut |
|---|---|
| Breviar | rezultatele din Cursul 1 folosite azi |
| Primii pași în R | vectori, vectori logici, expand.grid, sample, replicate, funcții proprii, grafice |
| Evenimente și operații cu evenimente | trei servere; două zaruri pe un spațiu enumerat |
| Reguli de calcul și formula lui Poincaré | Python și Java; numere divizibile cu 2, 3 sau 5; margini pentru probabilități |
| Modelul clasic și numărare | extrageri cu și fără revenire; parole și anagrame; cărți de joc; zile de naștere |
| Problema potrivirilor prin simulare | cel puțin o potrivire, exact \(k\) potriviri, numărul mediu de potriviri |
| Studiu individual și temă | exerciții suplimentare, cu răspunsuri în fișa de lucru; temă |
Obiectivele ședinței
La sfârșitul ședinței studentul trebuie să poată:
- exprima evenimente compuse („exact unul”, „cel puțin două”, „niciunul”) prin reuniuni, intersecții și complementare și aplica relațiile lui De Morgan;
- folosi regulile de calcul: evenimentul contrar, reuniunea a două evenimente, formula lui Poincaré pentru trei evenimente, marginile lui Boole și Bonferroni;
- calcula probabilități în modelul clasic prin numărare (regula produsului, extrageri cu și fără revenire, combinări, anagrame);
- lucra în R cu vectori, vectori logici și funcții, enumera un spațiu al stărilor cu
expand.gridși calcula probabilități cumean(conditie); - simula un experiment aleator cu
sampleșireplicateși compara frecvența relativă cu probabilitatea teoretică; - rezolva, exact și prin simulare, problema zilelor de naștere și problema potrivirilor.
Planul ședinței
De rezolvat la seminar (în această ordine):
- Primii pași în R — vectori, vectori logici,
expand.grid,sample,replicate, funcții proprii; - Exercițiul 1 — evenimente compuse și relațiile lui De Morgan;
expand.grid; - Exercițiul 4 (a)–(c), (e) — formula lui Poincaré; vectori logici cu
%%; - Exercițiul 6 (a)–(c), (e) — extrageri cu și fără revenire;
p_cu,p_fara; - Exercițiul 9 (a)–(c) — zilele de naștere, exact (
p_zile) și prin simulare; - Exercițiul 10 (a), (b), (d) — problema potrivirilor;
potriviri,exact_k.
Dacă timpul permite: Exercițiul 3 (reuniunea și margini), Exercițiul 5 (Boole și Bonferroni), Exercițiul 7 (parole, coduri PIN, anagrame).
Pentru acasă: Exercițiile 2 și 8; exercițiile suplimentare 11, 12, 13, 14; tema.
Rezolvările complete vor fi publicate ulterior. Scheletele de cod R și răspunsurile: în fișa de lucru.
Breviar: evenimente și reguli de calcul
Evenimente și reguli de calcul
Din Cursul 1 folosim astăzi următoarele rezultate.
Evenimente. Un eveniment este o submulțime \(A\subseteq\Omega\) a spațiului stărilor (Definiția 3 din Cursul 1). Dicționar: \(A^c\) = „nu se realizează \(A\)”; \(A\cup B\) = „\(A\) sau \(B\)” (cel puțin unul); \(A\cap B\) = „\(A\) și \(B\)”; \(A\setminus B=A\cap B^c\) = „\(A\), dar nu \(B\)”; \(A\,\triangle\,B\) = „exact unul dintre \(A\) și \(B\)”. \(A\) și \(B\) sunt incompatibile dacă \(A\cap B=\emptyset\) (Definiția 5 din Cursul 1).
Relațiile lui De Morgan (Propoziția 4 din Cursul 1): \((A\cup B)^c=A^c\cap B^c\) și \((A\cap B)^c=A^c\cup B^c\); la fel pentru oricâte evenimente.
Reguli de calcul (Propoziția 14 din Cursul 1): \(\PP(A^c)=1-\PP(A)\); dacă \(A\cap B=\emptyset\), atunci \(\PP(A\cup B)=\PP(A)+\PP(B)\); dacă \(A\subseteq B\), atunci \(\PP(A)\le\PP(B)\); \[ \PP(A\setminus B)=\PP(A)-\PP(A\cap B),\qquad \PP(A\cup B)=\PP(A)+\PP(B)-\PP(A\cap B). \]
Breviar: Poincaré, margini, modelul clasic
Formula lui Poincaré, margini, modelul clasic
Formula lui Poincaré (Teorema 15 din Cursul 1), pentru trei evenimente: \[ \begin{aligned} \PP(A\cup B\cup C)&=\PP(A)+\PP(B)+\PP(C)\\ &\quad-\PP(A\cap B)-\PP(A\cap C)-\PP(B\cap C)+\PP(A\cap B\cap C). \end{aligned} \] Margini (Propozițiile 16 din Cursul 1 și 17 din Cursul 1): \[ \PP\Big(\bigcup_{i=1}^nA_i\Big)\le\sum_{i=1}^n\PP(A_i),\qquad \PP\Big(\bigcap_{i=1}^nA_i\Big)\ge\sum_{i=1}^n\PP(A_i)-(n-1). \] Modelul clasic (Definiția 19 din Cursul 1): dacă \(\Omega\) este finit și rezultatele sunt egal probabile, atunci \(\PP(A)=|A|/|\Omega|\) (cazuri favorabile supra cazuri posibile).
Interpretarea frecvenționistă (Secțiunea 4 din Cursul 1): dacă în \(N\) repetări ale experimentului \(A\) se realizează de \(N(A)\) ori, atunci \(N(A)/N\approx\PP(A)\) pentru \(N\) mare. Pe această idee se bazează orice simulare.
Breviar: numărare și instrumentele R
Numărare, două probleme clasice, instrumente R
Numărare. Regula produsului (Propoziția 21 din Cursul 1); extrageri de \(k\) elemente din \(n\):
- cu revenire și cu ordine: \(n^k\) (Propoziția 22 din Cursul 1);
- fără revenire și cu ordine: \(A_n^k=n(n-1)\cdots(n-k+1)\), în particular \(n!\) permutări (Propoziția 23 din Cursul 1);
- fără revenire și fără ordine: \(\binom nk=\frac{n!}{k!\,(n-k)!}\) (Propoziția 24 din Cursul 1);
- șiruri cu \(n_1,\dots,n_k\) elemente identice: \(\frac{n!}{n_1!\cdots n_k!}\) (Propoziția 25 din Cursul 1).
Zile de naștere (Exemplul 16 din Cursul 1): \(\PP(\text{cel puțin o coincidență})=1-\frac{365\cdot364\cdots(365-n+1)}{365^n}\). Potriviri (Exemplul 22 din Cursul 1): \(p_n=\sum_{k=1}^n\frac{(-1)^{k+1}}{k!}\to1-\frac1e\approx0.632\).
Instrumente R: vectori logici și mean(conditie); expand.grid (enumerare); sample, replicate (simulare); funcții proprii; plot, barplot.
Primii pași în R
R și RStudio: consola și scriptul
R este un limbaj de programare și un mediu de lucru gratuit, dedicat calculului statistic și graficii. Îl folosim în fiecare săptămână ca să calculăm exact (formule, enumerarea tuturor rezultatelor) și ca să simulăm (repetăm experimentul de multe ori și numărăm).
- Lucrăm în RStudio: editorul de scripturi (stânga sus), consola (stânga jos), lista obiectelor (Environment, dreapta sus), fișiere, grafice și ajutor (dreapta jos).
- În consolă scriem o comandă după
>și apăsămEnter: potrivită pentru încercări rapide. - Într-un script (fișier
.R; File → New File → R Script) păstrăm comenzile; linia curentă sau selecția se trimite în consolă cuCtrl + Enter(Cmd + Enterpe macOS). Lucrați întotdeauna într-un script. - Tot ce urmează după
#este un comentariu; pagina de ajutor a unei funcții:?nume, de exemplu?sample. - Rezultatele afișate de R sunt precedate, pe slide-uri și în note, de
#>.
R ca un calculator. Obiecte
[1]din fața unui rezultat arată poziția primei valori afișate pe linie.- Un rezultat se păstrează într-un obiect cu operatorul
<-(în RStudio:Alt + -). O atribuire nu afișează nimic; pentru a vedea valoarea unui obiect îi scriem numele.nșiNsunt obiecte diferite.
Vectori
Obiectul de bază din R este vectorul: un șir de valori de același tip (numere, șiruri de caractere sau valori logice). Chiar și un număr este un vector de lungime \(1\).
#> [1] 1 2 3 4 5 6
#> [1] 0.00 0.25 0.50 0.75 1.00
#> [1] "H" "T" "H" "T" "H" "T"
#> [1] "R" "R" "A" "A" "A"
Cu rep vom construi urne („\(6\) bile roșii și \(4\) albastre”), iar cu 1:n spații ale stărilor.
Vectori: operații și indexare
Operațiile se aplică element cu element (sunt vectorizate); indicii încep de la 1, nu de la 0.
#> [1]  5  9 16 17 24 43
#> [1] 0.03704 0.07407 0.13889 0.14815 0.21296 0.38889
#> [1] 8
#> [1]  4 15
#> [1]  8 15 16 23 42
#> [1] 16 23 42
#> [1] 6Vectori logici: numărare și proporții
O comparație (==, !=, <, <=, >, >=) produce un vector de valori TRUE/FALSE. În calcule TRUE valorează \(1\) și FALSE valorează \(0\): suma numără valorile TRUE, iar media este proporția lor.
#> [1] FALSE  TRUE FALSE  TRUE FALSE FALSE  TRUE FALSE
#> [1] 3
#> [1] 0.375| Eveniment | \(A\cap B\) („și”) | \(A\cup B\) („sau”) | \(A^c\) („nu”) | \(A\setminus B\) | \(A\,\triangle\,B\) („exact unul”) |
|---|---|---|---|---|---|
| În R | A & B |
A | B |
!A |
A & !B |
xor(A, B) |
Evenimente ca vectori logici
Idiomul de bază al laboratorului
Dacă ev este vectorul logic al unui eveniment (câte o componentă pentru fiecare rezultat), atunci sum(ev) este numărul cazurilor favorabile, iar mean(ev) este proporția lor: probabilitatea, când componentele corespund tuturor rezultatelor egal probabile (enumerare), respectiv frecvența relativă, când corespund unor repetări simulate.
Funcții utile pentru numărare
Stânga: formulele de numărare din Cursul 1. Dreapta: table numără aparițiile fiecărei valori (util la simulări); which dă pozițiile valorilor TRUE; any / all: există un TRUE? / sunt toate TRUE?
Mulțimi
Un eveniment poate fi reprezentat și ca mulțimea rezultatelor favorabile; R are funcții pentru operațiile cu mulțimi.
#> [1] 2 4 6 5
#> [1] 4 6
#> [1] 2
#> [1] 1 3 5
#> [1] FALSE  TRUE
Enumerarea spațiului stărilor: expand.grid
Pentru experimente cu mai multe etape (două zaruri, trei monede), expand.grid construiește un tabel (data frame) în care fiecare linie este un rezultat posibil; o coloană se extrage cu $.
#> [1] 36
#>   z1 z2
#> 1  1  1
#> 2  2  1
#> 3  3  1
#> [1] 0.1667
Cel mai mare dintre două zaruri
Exemplul 1 (Cel mai mare dintre două zaruri)
Aruncăm două zaruri echilibrate; \(M\) = cel mai mare dintre cele două numere. \(\{M\le4\}\) înseamnă că ambele zaruri arată cel mult \(4\): \(4\cdot4=16\) cazuri favorabile, deci \(\PP(M\le4)=\frac{16}{36}\approx0.4444\). Apoi \(\{M=4\}=\{M\le4\}\setminus\{M\le3\}\), deci \(\PP(M=4)=\frac{16}{36}-\frac{9}{36}=\frac7{36}\approx0.1944\). În R numărăm pe tabelul celor \(36\) de rezultate.
#> cel_mult_4  egal_cu_4
#>     0.4444     0.1944
#> M
#>  1  2  3  4  5  6
#>  1  3  5  7  9 11
Valorile coincid cu cele calculate de mână; \(M=m\) are \(m^2-(m-1)^2=2m-1\) cazuri favorabile: \(1,3,5,7,9,11\).
Experimente aleatoare: sample și set.seed
set.seed(2026)                     # fixează „sămânța” generatorului
sample(1:6, 1)                     # o aruncare a unui zar
sample(1:6, 10, replace = TRUE)    # 10 aruncări (extrageri cu revenire)
sample(1:10, 3)                    # 3 bile din 10, fără revenire
sample(5)                          # o permutare aleatoare a lui 1, ..., 5
sample(c("H", "T"), 8, replace = TRUE, prob = c(0.8, 0.2))
#> [1] 5
#> [1] 1 1 6 5 3 4 4 5 4 2
#> [1] 2 8 3
#> [1] 5 2 1 4 3
#> [1] "H" "H" "H" "H" "H" "H" "H" "T"sample(x, size)este „urna” noastră: implicit fără revenire; cureplace = TRUE, cu revenire.sample(n)este o permutare aleatoare a lui1:n;probdă probabilitățile elementelor.- Numerele sunt pseudo-aleatoare:
set.seed(numar)fixează generatorul (rezultate reproductibile).
Un zar aruncat de zece mii de ori
Exemplul 2 (Un zar aruncat de zece mii de ori)
Simulăm \(10^4\) aruncări ale unui zar echilibrat și calculăm frecvențele relative ale celor șase fețe și ale evenimentului „număr par”.
#> aruncari
#>     1     2     3     4     5     6
#> 0.161 0.174 0.159 0.170 0.170 0.166
#> [1] 0.5108
Frecvențele sunt apropiate de \(1/6\approx0.167\), respectiv de \(1/2\): este interpretarea frecvenționistă a probabilității.
Repetarea unui experiment: for și replicate
Un experiment mai complicat se repetă cu o buclă for sau, mai scurt, cu replicate. Estimăm probabilitatea ca suma a două zaruri să fie \(7\) (valoarea exactă: \(6/36\approx0.1667\)).
#> [1] 0.1654
#> [1] 0.1656
replicate(B, expresie) evaluează expresia de B ori și adună rezultatele într-un vector.
Funcții proprii
suma_zaruri <- function(k = 2) {     # k = numărul de zaruri (implicit 2)
  z <- sample(1:6, k, replace = TRUE)
  sum(z)                             # ultima expresie este valoarea întoarsă
}
suma_zaruri()                        # suma a două zaruri
suma_zaruri(5)                       # suma a cinci zaruri
mean(replicate(B, suma_zaruri(3)) >= 12)
sapply(1:3, function(k) mean(replicate(B, suma_zaruri(k)) >= 4 * k))
#> [1] 8
#> [1] 22
#> [1] 0.3797
#> [1] 0.4976 0.4230 0.3777Un experiment folosit de mai multe ori se împachetează într-o funcție. A treia linie de rezultate estimează \(\PP(\text{suma a trei zaruri}\ge12)=81/216=0.375\). sapply(valori, f) aplică funcția f fiecărui element: ultima linie estimează \(\PP(\text{suma a }k\text{ zaruri}\ge4k)\), \(k=1,2,3\) (exact: \(0.5\), \(15/36\approx0.4167\), \(0.375\); erori sub \(0.01\)).
Schema unei simulări
Schema unei simulări
- Scriem o funcție (sau o expresie) care efectuează o dată experimentul și întoarce mărimea care ne interesează (un număr sau
TRUE/FALSE). - Repetăm experimentul de
Bori:rezultate <- replicate(B, experiment()). - Estimăm probabilitatea prin frecvența relativă:
mean(conditie).
Estimarea nu este exactă: pentru B = 1e4 eroarea este, de regulă, mai mică decât \(0.01\), iar pentru B = 1e5 mai mică decât \(0.003\) (vom vedea de ce în Cursul 7). De aceea comparăm doar primele două zecimale ale unei simulări cu valoarea teoretică.
Grafice simple
plot(x, y) reprezintă punctele (x[i], y[i]), barplot desenează bare; peste un grafic adăugăm lines, points, abline. Culorile notelor sunt păstrate într-un vector cu nume (un element se extrage cu [[ ]]).
culori <- c(albastru = "#2B6CB0", rosu = "#9B2335", verde = "#2F7D4A",
            portocaliu = "#C0661A", mov = "#7A3E8E", teal = "#1F7A7A",
            gri = "#6B7785", bleumarin = "#1B3A5C")
barplot(frecv, col = culori[["albastru"]],
        xlab = "fața zarului", ylab = "frecvența relativă")
abline(h = 1/6, lty = 2, col = culori[["rosu"]])   # dreapta y = 1/6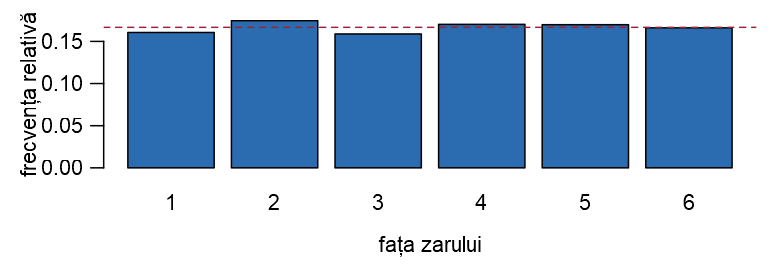
Stabilizarea frecvenței relative
Exemplul 3 (Stabilizarea frecvenței relative)
Aruncăm o monedă echilibrată de \(N=5000\) de ori și urmărim frecvența relativă a capului după primele \(1,2,\dots,N\) aruncări. Dacă moneda este vectorul rezultatelor (\(1\) = cap, \(0\) = pajură), cumsum(moneda) este numărul de capete obținute până la fiecare aruncare, iar împărțirea la 1:N dă frecvențele relative.
#> [1] 0.700 0.510 0.494 0.504La început frecvența relativă oscilează mult, apoi se apropie de \(0.5\).
Stabilizarea frecvenței relative — graficul
plot(1:N, f, type = "l", log = "x", ylim = c(0, 1),
     col = culori[["albastru"]],
     xlab = "numărul de aruncări (scară logaritmică)",
     ylab = "frecvența relativă a capului")
moneda2 <- sample(c(1, 0), N, replace = TRUE)   # o a doua serie
lines(1:N, cumsum(moneda2) / (1:N), col = culori[["verde"]])
abline(h = 0.5, lty = 2, col = culori[["rosu"]])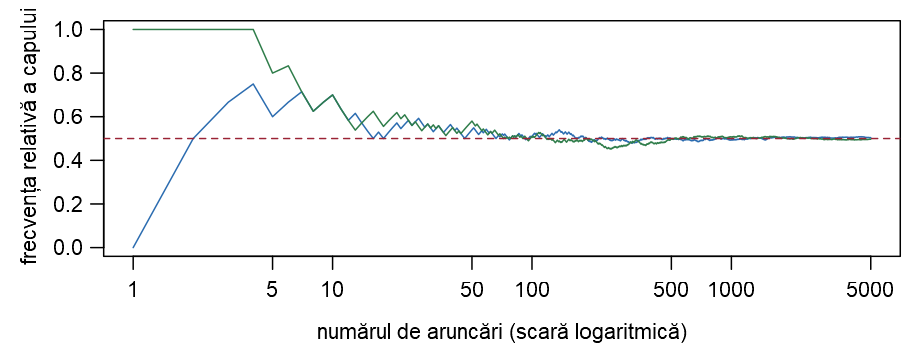
Ambele serii se stabilizează în jurul valorii \(0.5\), ca în figura corespunzătoare din Secțiunea 4 din Cursul 1.
Evenimente și operații cu evenimente
Trei servere
Exercițiul 1 (Trei servere)
La seminar Un serviciu web rulează pe trei servere; la un moment dat, fiecare server fie funcționează, fie este căzut. Notăm cu \(A_i\) evenimentul „serverul \(i\) funcționează”, \(i=1,2,3\).
- Exprimați cu ajutorul evenimentelor \(A_1,A_2,A_3\): \(E_1\) = „toate cele trei servere funcționează”; \(E_2\) = „cel puțin un server funcționează”; \(E_3\) = „niciun server nu funcționează”; \(E_4\) = „funcționează exact un server”; \(E_5\) = „funcționează cel puțin două servere”; \(E_6\) = „funcționează cel mult un server”.
- Care dintre evenimentele de la (a) sunt contrare unul altuia? Justificați cu relațiile lui De Morgan.
- Serviciul este disponibil dacă funcționează serverul \(1\) (de aplicație) și cel puțin unul dintre serverele \(2\) și \(3\) (de date). Scrieți evenimentul \(S\) = „serviciul este disponibil” și contrarul \(S^c\).
- Descriem starea sistemului prin \((x_1,x_2,x_3)\), cu \(x_i=1\) dacă serverul \(i\) funcționează și \(x_i=0\) dacă este căzut. Presupunând că stările sunt egal probabile, calculați probabilitățile evenimentelor \(E_1,\dots,E_6\) și \(S\).
- Construiți în R spațiul stărilor și evenimentele; verificați răspunsurile de la (b), (c) și (d).
Două zaruri pe un spațiu enumerat
Exercițiul 2 (Două zaruri pe un spațiu enumerat)
Pentru acasă Aruncăm două zaruri echilibrate, unul roșu și unul albastru. Considerăm evenimentele \(A\) = „suma celor două numere este pară” și \(B\) = „cel puțin un zar arată \(6\)”.
- Descrieți spațiul stărilor și determinați numărul de elemente ale evenimentelor \(A\), \(B\) și \(A\cap B\).
- Calculați \(\PP(A)\), \(\PP(B)\), \(\PP(A\cap B)\) și \(\PP(A\cup B)\).
- Descrieți în cuvinte evenimentele \(A^c\cap B^c\), \(A\setminus B\) și \(A\,\triangle\,B\) și calculați-le probabilitățile.
- Sunt \(A\) și \(B\) incompatibile? Arătați că evenimentul \(C\) = „suma este cel mult \(6\)” este incompatibil cu \(B\) și calculați \(\PP(B\cup C)\).
- Verificați rezultatele în R, prin enumerare și printr-o simulare cu \(10^5\) aruncări.
Reguli de calcul și formula lui Poincaré
Python și Java
Exercițiul 3 (Python și Java)
Dacă timpul permite Alegem la întâmplare un student al unei facultăți. Probabilitatea ca studentul să știe Python este \(0.70\), probabilitatea să știe Java este \(0.45\), iar probabilitatea să știe ambele limbaje este \(0.30\).
- Care este probabilitatea ca studentul să știe cel puțin unul dintre cele două limbaje?
- Care este probabilitatea să nu știe niciunul?
- Care este probabilitatea să știe Python, dar nu și Java?
- Care este probabilitatea să știe exact unul dintre cele două limbaje?
- Să presupunem că nu am cunoaște probabilitatea de a ști ambele limbaje. Între ce valori s-ar putea afla ea, dacă știm doar că \(70\%\) dintre studenți știu Python și \(45\%\) știu Java?
- În R: construiți o facultate cu \(200\) de studenți care respectă datele din enunț și verificați, prin numărare și prin simulare, răspunsurile de la (a)–(d).
Numere divizibile cu 2, 3 sau 5
Exercițiul 4 (Numere divizibile cu 2, 3 sau 5)
La seminar Alegem la întâmplare un număr din mulțimea \(\{1,2,\dots,1000\}\), toate numerele fiind egal probabile. Notăm cu \(D_k\) evenimentul „numărul ales este divizibil cu \(k\)”.
- Calculați \(\PP(D_2)\), \(\PP(D_3)\), \(\PP(D_5)\) și probabilitățile intersecțiilor \(D_2\cap D_3\), \(D_2\cap D_5\), \(D_3\cap D_5\) și \(D_2\cap D_3\cap D_5\).
- Care este probabilitatea ca numărul ales să fie divizibil cu cel puțin unul dintre numerele \(2\), \(3\) și \(5\)?
- Care este probabilitatea ca numărul să nu fie divizibil cu niciunul dintre ele?
- Care este probabilitatea ca numărul să fie divizibil cu exact unul dintre numerele \(2\), \(3\) și \(5\)?
- Verificați în R, folosind operatorul
%%pe vectorul1:1000. Cum se schimbă răspunsul de la (b) dacă alegem numărul din \(\{1,\dots,N\}\), pentru \(N=10\), \(100\), \(1000\) și \(10^6\)?
Teste automate: margini pentru probabilități
Exercițiul 5 (Teste automate: margini pentru probabilități)
Dacă timpul permite O aplicație este livrată numai dacă trece toate cele \(n=5\) teste automate. Din istoricul proiectului se știe că fiecare test, luat separat, este trecut cu probabilitatea \(0.98\); nu se știe însă nimic despre legătura dintre teste. Fie \(T_i\) evenimentul „testul \(i\) este trecut”, \(i=1,\dots,5\).
- Scrieți evenimentul \(L\) = „aplicația este livrată” și contrarul său cu ajutorul evenimentelor \(T_i\).
- Arătați că \(0.90\le\PP(L)\le0.98\).
- Cel mult câte teste de acest fel poate avea aplicația, astfel încât să putem garanta că este livrată cu probabilitate cel puțin \(1/2\)?
- Construiți în R, pe spațiul \(\Omega=\{1,2,\dots,100\}\) cu rezultate egal probabile, două situații în care marginile de la (b) sunt atinse. Estimați apoi \(\PP(L)\) prin simulare în cazul în care testele „nu se influențează” unul pe altul.
Modelul clasic și numărare
Extrageri cu și fără revenire
Exercițiul 6 (Extrageri cu și fără revenire)
La seminar O urnă conține \(10\) bile: \(6\) roșii și \(4\) albastre. Extragem la întâmplare \(3\) bile.
- Extragerea se face cu revenire. Calculați probabilitatea de a obține exact două bile roșii și probabilitatea de a obține cel puțin o bilă albastră.
- Aceleași întrebări dacă extragerea se face fără revenire. Numărați în două moduri: ținând cont de ordinea extragerii și fără a ține cont de ea.
- În care dintre cele două scheme este mai probabil ca toate cele trei bile să aibă aceeași culoare?
- Dintr-un grup de \(6\) fete și \(4\) băieți se alege la întâmplare o comisie de \(3\) persoane. Care este probabilitatea ca din comisie să facă parte exact două fete?
- Verificați rezultatele în R prin simulare și prin enumerare completă.
Parole, coduri PIN și anagrame
Exercițiul 7 (Parole, coduri PIN și anagrame)
Dacă timpul permite (a) O parolă este formată din \(4\) litere mici ale alfabetului englez (\(26\) de litere). Câte parole există? Câte dintre ele au toate literele diferite? (b) Un cod PIN este format din \(4\) cifre alese la întâmplare (toate codurile de la \(0000\) la \(9999\) sunt egal probabile). Care este probabilitatea ca cifrele codului să fie toate diferite? Dar ca măcar o cifră să se repete? (c) Câte anagrame (cuvinte diferite, nu neapărat cu sens) are cuvântul ANANAS? (d) Cele șase litere ale cuvântului ANANAS sunt scrise pe șase cartonașe, care se amestecă și se așază în linie la întâmplare. Care este probabilitatea ca cele trei litere A să fie alăturate? Dar ca șirul obținut să înceapă cu A și să se termine cu S? (e) Verificați în R punctul (b) prin enumerare și punctele (c) și (d) prin simulare.
O mână de cinci cărți
Exercițiul 8 (O mână de cinci cărți)
Pentru acasă Dintr-un pachet bine amestecat de \(52\) de cărți (\(13\) figuri, fiecare în \(4\) culori) se extrag \(5\) cărți. Calculați probabilitatea ca mâna obținută:
- să conțină exact doi ași;
- să conțină cel puțin un as;
- să conțină cinci cărți de figuri diferite (nicio figură nu se repetă).
- Construiți pachetul în R cu
expand.gridși verificați rezultatele prin simulare.
Zile de naștere
Exercițiul 9 (Zile de naștere)
La seminar Într-o grupă de laborator sunt \(n\) studenți. Ca în Exemplul 16 din Cursul 1, presupunem că anul are \(365\) de zile, la fel de probabile ca zi de naștere; \(q_n\) este probabilitatea ca cel puțin doi studenți să aibă aceeași zi de naștere.
- Scrieți formula lui \(q_n\) ca produs și calculați de mână \(q_4\).
- Scrieți în R o funcție
p_zile(n, zile = 365)care calculează \(q_n\) cu ajutorul luiprod. Calculați \(q_{25}\) și cel mai mic \(n\) pentru care \(q_n\ge1/2\), respectiv \(q_n\ge0.99\). - Estimați prin simulare \(q_{10}\), \(q_{25}\) și \(q_{40}\) și reprezentați grafic \(q_n\) pentru \(n=1,\dots,60\), împreună cu valorile simulate.
- Alt număr de „zile”. Care este probabilitatea ca, dintre \(5\) studenți, cel puțin doi să fie născuți în aceeași lună (\(12\) luni egal probabile)? Ce legătură are problema cu codul PIN din Exercițiul 7?
- Trei studenți. Estimați prin simulare probabilitatea ca cel puțin trei studenți să aibă aceeași zi de naștere, pentru \(n\in\{25,50,88,120\}\).
Problema potrivirilor prin simulare
Problema potrivirilor prin simulare
Exercițiul 10 (Problema potrivirilor prin simulare)
La seminar La intrarea într-un examen, cei \(n\) studenți își lasă telefoanele într-o cutie; la ieșire, telefoanele sunt împărțite la întâmplare, câte unul fiecărui student (cele \(n!\) împărțiri sunt egal probabile). Avem o potrivire când un student își primește propriul telefon; \(N\) = numărul de potriviri. Din Exemplul 22 din Cursul 1, \(\PP(N\ge1)=p_n=\sum_{k=1}^n\frac{(-1)^{k+1}}{k!}\).
- Pentru \(n=3\), enumerați toate împărțirile și numărul de potriviri al fiecăreia. Deduceți \(\PP(N\ge1)\) și \(\PP(N=k)\), \(k=0,1,2,3\), și comparați cu formula lui \(p_3\).
- Scrieți în R o funcție
potriviri(n)care simulează o împărțire și întoarce numărul de potriviri. Estimați \(\PP(N\ge1)\) pentru \(n=10\) și comparați cu \(p_{10}\) și cu limita \(1-1/e\). - Reprezentați grafic, pentru \(n=1,\dots,12\), valoarea exactă \(p_n\) și estimarea ei prin simulare.
- Pentru \(n=10\), determinați prin simulare frecvențele relative ale evenimentelor „exact \(k\) potriviri”, \(k=0,\dots,6\); comparați cu formula din Exercițiul 8 din Cursul 1 și cu valorile limită \(e^{-1}/k!\).
- Estimați numărul mediu de potriviri pentru \(n=5\), \(n=10\) și \(n=100\). Ce observați? Explicați.
Studiu individual și temă
Pentru studiul individual
Exercițiile suplimentare reiau, în ordine, temele ședinței; răspunsurile: în fișa de lucru; rezolvările complete vor fi publicate ulterior.
Exercițiul 11 (Șiruri de biți)
Pentru acasă Un generator produce un șir de \(n\) biți, toate cele \(2^n\) șiruri fiind egal probabile; \(A_j\) = „bitul de pe poziția \(j\) este \(1\)”. Pentru \(n=4\), scrieți cu ajutorul lui \(A_j\) și calculați probabilitățile evenimentelor \(U\) = „cel puțin un bit este \(1\)” și \(V\) = „există doi biți consecutivi egali cu \(1\)”. Pentru \(n\) oarecare: probabilitatea ca exact \(k\) biți să fie \(1\). În R, pentru \(n=10\): \(\PP(V)\) prin enumerare.
Exercițiul 12 (Două zaruri contra unui zar cu 12 fețe)
Pentru acasă Ana aruncă două zaruri obișnuite și adună punctele; Barbu aruncă un zar cu \(12\) fețe. Câștigă cel cu punctajul mai mare; la egalitate este remiză. Calculați probabilitățile celor trei rezultate. Este jocul echitabil? Dar dacă Ana aruncă trei zaruri, iar Barbu un zar cu \(20\) de fețe (în R, prin enumerare)?
Pentru studiul individual: pasageri și vagoane
Exercițiul 13 (Pasageri și vagoane)
Pentru acasă Nouă pasageri urcă într-un tren cu trei vagoane; fiecare alege la întâmplare unul dintre vagoane (toate cele \(3^9\) moduri de alegere sunt egal probabile). Calculați probabilitatea ca:
- în primul vagon să urce exact trei pasageri;
- în fiecare vagon să urce câte trei pasageri;
- într-un vagon să urce doi pasageri, în altul trei și în cel rămas patru;
- niciun vagon să nu rămână gol.
- Verificați în R prin enumerarea tuturor celor \(3^9\) rezultate.
Răspunsurile: în fișa de lucru; rezolvarea completă va fi publicată ulterior.
Pentru studiul individual: punctele fixe ale permutărilor
Exercițiul 14 (Punctele fixe ale permutărilor prin enumerare)
Pentru acasă În problema potrivirilor (Exercițiul 10) numărul de potriviri este numărul de puncte fixe ale unei permutări alese la întâmplare.
- Pentru \(n=4\), determinați prin numărare câte dintre cele \(24\) de permutări au exact \(0\), \(1\), \(2\), \(3\) și \(4\) puncte fixe.
- Scrieți în R o funcție
permutari(n)care întoarce toate permutările lui \(\{1,\dots,n\}\) (pentru \(n\le6\)) și verificați punctul (a). - Pentru \(n=6\), comparați probabilitățile exacte obținute prin enumerare cu formula
exact_kși calculați numărul mediu de puncte fixe.
Răspunsurile: în fișa de lucru; rezolvarea completă va fi publicată ulterior.
Temă (răspunsuri: în fișa de lucru)
- Fie \(A\), \(B\), \(C\) trei evenimente. Exprimați cu ajutorul operațiilor cu evenimente: „se realizează exact două dintre ele”, „se realizează cel mult două dintre ele” și „se realizează \(A\) sau \(B\), dar nu \(C\)”.
- Fie \(A\) și \(B\) două evenimente cu \(\PP(A)=0.6\) și \(\PP(B)=0.7\). Arătați că \(0.3\le\PP(A\cap B)\le0.6\). Dacă \(\PP(A\cap B)=0.4\), calculați probabilitatea să se realizeze cel puțin unul, exact unul, respectiv niciunul dintre cele două evenimente.
- Câte numere din mulțimea \(\{1,\dots,500\}\) sunt divizibile cu \(3\) sau cu \(7\)? Care este probabilitatea ca un număr ales la întâmplare din această mulțime să nu fie divizibil nici cu \(3\), nici cu \(7\)? Verificați în R cu operatorul
%%. - Dintr-un grup format din \(8\) programatori și \(5\) testeri se alege la întâmplare o echipă de \(4\) persoane. Care este probabilitatea ca echipa să conțină exact \(2\) testeri? Dar cel puțin un tester?
Temă (continuare)
- Câte anagrame are cuvântul PROBABILITATE? Dacă literele lui sunt amestecate la întâmplare, care este probabilitatea ca șirul obținut să înceapă cu o vocală?
- Aruncăm trei zaruri echilibrate. Calculați probabilitatea ca suma lor să fie cel puțin \(15\), enumerând în R cele \(216\) rezultate cu
expand.grid, apoi estimați aceeași probabilitate printr-o simulare cu \(10^5\) repetări. - Pe câte persoane trebuie să întrebați pentru ca, cu probabilitate cel puțin \(1/2\), măcar una dintre ele să fie născută în aceeași zi cu dumneavoastră? Comparați cu pragul \(n=23\) din problema zilelor de naștere și explicați diferența. (Indicație: probabilitatea este \(1-(364/365)^n\).)
- Doisprezece colegi organizează un schimb de cadouri: fiecare extrage la întâmplare un bilet cu numele unui coleg. Estimați prin simulare, cu funcția
potriviridin Exercițiul 10, probabilitatea ca nimeni să nu își extragă propriul nume și probabilitatea ca exact două persoane să își extragă propriul nume; comparați cu valorile date deexact_k.
Bibliografie
Lecturi recomandate: (Blitzstein and Hwang 2019, cap. 1), (Bertsekas and Tsitsiklis 2008, cap. 1); pentru simulări în R: (Wagaman and Dobrow 2021, cap. 1); pentru o introducere pe îndelete în R: (Davies 2016), (Verzani 2014).
Bertsekas, Dimitri P., and John N. Tsitsiklis. 2008. Introduction to Probability. 2nd ed. Athena Scientific.
Blitzstein, Joseph K., and Jessica Hwang. 2019. Introduction to Probability. 2nd ed. CRC Press.
Davies, Tilman M. 2016. The Book of R: A First Course in Programming and Statistics. No Starch Press.
Verzani, John. 2014. Using R for Introductory Statistics. 2nd ed. CRC Press.
Wagaman, Amy S., and Robert P. Dobrow. 2021. Probability with Applications and R. 2nd ed. Wiley.
Probabilități și Statistică · Seminarul 1 — Evenimente, numărare, primii pași în R